
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Функции награды для агентов научились искать без описания задачи, экспертных примеров и доступа к правильному ответу. В препринте ETH Zurich и UCL, который не прошёл рецензирование и приводит замеры самих авторов, метод WATERFALL обошёл все сравниваемые подходы в частично наблюдаемых средах. Это позволяет обучать агентов там, где цель и полезные объекты раскрываются только во время взаимодействия.
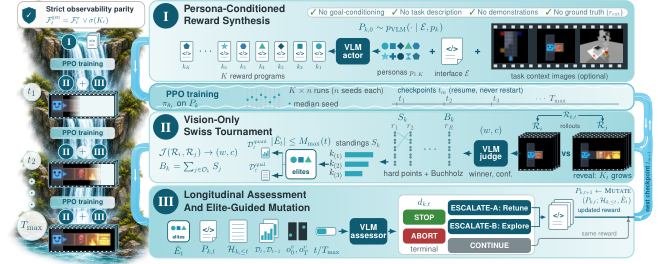
Функция награды задаёт сигнал, по которому агент учится выбирать действия. WATERFALL создаёт 10 вариантов такой функции с разными исходными стратегиями, обучает для каждого отдельную политику и показывает модели-оценщику записи поведения. Генератор видит только те наблюдения и действия, которые доступны самому агенту, а сведения об объектах получает после того, как агент их обнаружил.
Оценщик попарно сравнивает записи и проводит турнир по швейцарской системе: сильные варианты встречаются друг с другом, но полный перебор пар не нужен. Лучшие функции становятся основой для следующего цикла, а остальные система исправляет, дополняет стимулами к исследованию или отбрасывает. История прошлых оценок помогает не принять единичную ошибку зрительно-языковой модели за успешное поведение.
WATERFALL сравнили с обычным обучением с подкреплением, методами внутренней мотивации и генераторами награды CAR-VLM, T2R, L2R и EUREKA. Проверка охватила четыре дискретные и непрерывные среды с полной и частичной наблюдаемостью; первые три обучали до 100 млн шагов, роботизированную задачу — до 10 млн. На отдельной проверке турнир сохранил тот же набор лучших кандидатов, что и полный перебор, использовав 54% попарных сравнений.
Работа показывает не готовую замену ручной постановке целей, а способ исследовать среду до того, как её структура полностью известна. Для робототехники и автономных агентов это меняет архитектурное решение: функцию награды можно строить как изменяемую программу, которую система уточняет по наблюдаемому поведению, а не фиксировать перед началом обучения.
Источники
Иллюстрация: рисунок из статьи «WATERFALL: Workflow for Adaptive Training with Evolutionary Reward Formulation and Automated Learning Loops», Eleftherios Triantafyllidis, Filippos Christianos, Zhibin Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


