
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Повторные обороты RoPE оказались не помощью, а источником ложных связей между далёкими позициями в контексте. Работа Tsinghua University показала рост результата Qwen3-8B в тесте длинного контекста с 35,7 до 40,0, хотя препринт не рецензирован, а все числа получили сами авторы. WavePrune можно применять к готовой модели без дополнительного обучения, но ускорение требует отдельного CUDA-ядра.
Почему полный оборот смешивает разные позиции
RoPE кодирует позицию токена через поворот компонентов запросов и ключей внутри механизма внимания. Каждый канал вращается со своей частотой, поэтому результат сравнения зависит не от абсолютных позиций двух токенов, а от расстояния между ними.
У каждого канала есть период: после полного оборота его угол повторяется. Из-за этого две позиции, разделённые целым периодом, получают близкие позиционные признаки. Содержимое запросов и ключей остаётся разным, но сам механизм кодирования хуже различает расстояния.
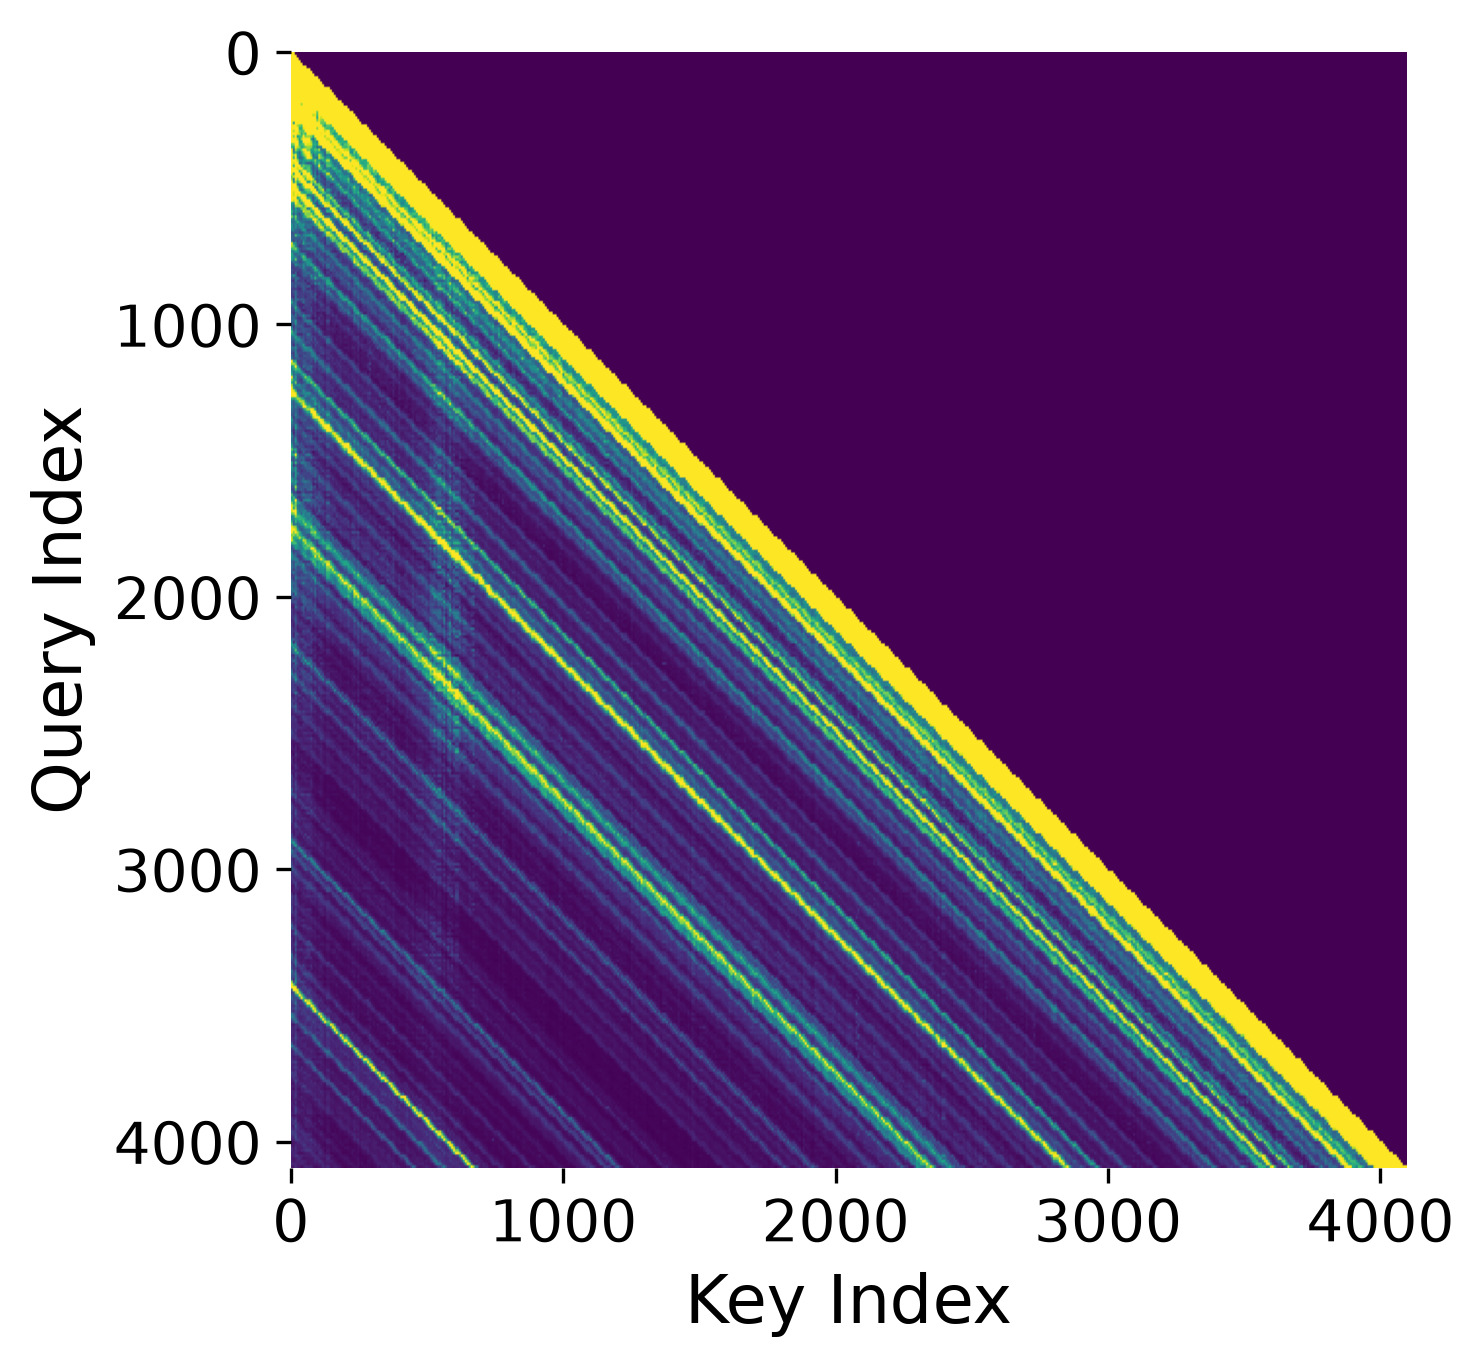
На картах внимания это проявляется как дополнительные диагональные полосы. Голова внимания должна, например, следить за предыдущим токеном, однако часть веса уходит к более далёким позициям с похожей фазой вращения. В статье такие полосы называют «призрачными» поддиагоналями.
WavePrune разрешает каждому каналу работать только внутри его первого периода. Высокочастотные каналы получают короткое окно, а низкочастотные сохраняют доступ к дальним токенам. Это отличается от обычного скользящего окна, которое задаёт одну границу сразу для всех компонентов внимания.
Такое отсечение не убирает длинные зависимости целиком. Оно передаёт их каналам, чья частота подходит для больших расстояний, и не позволяет быстрым каналам повторять один и тот же позиционный рисунок много раз. В математическом разборе даже упрощённое внимание с одинаковыми запросами и ключами порождает бесконечную последовательность близких максимумов, если повторные периоды не отсекать.
Качество растёт, а CUDA-ядро пропускает лишние вычисления
Основной тест проводили на HELMET — наборе задач, который проверяет работу моделей с длинным контекстом. WavePrune улучшил итоговый результат у большинства проверенных моделей; у Qwen3-8B он вырос с 35,7 до 40,0. Дополнительная настройка весов для этого не потребовалась.
Проверка охватывала модели семейств Qwen, Gemma и Ministral. Отдельно авторы обучали варианты GPT-2 с нуля на OpenWebText и оценивали их на последовательностях длиннее тех, что встречались при обучении. WavePrune давал меньшую ошибку на такой экстраполяции длины, а синтетические задачи подтвердили эффект для ближних и дальних зависимостей.
Ускорение возникает не только из-за лучшего позиционного кодирования. После отсечения периодов матрица внимания становится разрежённой: для части каналов далёкие пары токенов заведомо не нужны. FlashWavePrune группирует соседние компоненты так, чтобы выполнять допустимые блоки на тензорных ядрах GPU, а полностью исключённые блоки не вычисляет и не загружает из кэша ключей.
В контексте 32K FlashWavePrune ускорил начальную обработку запроса на 15%, а последовательную генерацию — на 24% относительно FlashAttention-2. Эти замеры относятся к специально написанному CUDA-ядру: простое добавление маски к обычной реализации внимания такого выигрыша не даёт.
Порог внутри производительного ядра задают не для каждого канала отдельно, а для группы компонентов. Это приближение позволяет сохранить вычисления в формате, подходящем тензорным ядрам. В экспериментах оно почти не меняло качество относительно точного варианта WavePrune.
Для готовых моделей это эксперимент, а не смена архитектуры
Команде с моделью на RoPE не нужно заново обучать её, чтобы проверить основную гипотезу. WavePrune можно включить при инференсе и сравнить качество на собственных длинных документах, поиске по контексту и задачах, где ответ зависит от точного положения фрагмента.
Переносить средний результат HELMET прямо в продуктовый прогноз нельзя. Эффект различался между моделями, а одинаковые пороги применяли ко всем головам внимания, хотя они выполняют разные функции. Практический тест должен отдельно проверить качество короткого контекста, поиск далёких фактов и устойчивость генерации на максимальной рабочей длине.
Если цель — снизить задержку, в план работ войдёт интеграция собственного CUDA-ядра или его адаптация к существующему стеку. Замеры FlashWavePrune не переносятся автоматически на другие ускорители и стандартные реализации внимания. Сокращение самого KV-кэша тоже оставили для будущей работы, поэтому подтверждённый выигрыш касается вычислений и загрузок во время внимания, а не общей ёмкости памяти.
Для обучения новой модели результат даёт основание протестировать WavePrune рядом с базовым RoPE до крупного запуска. Работа показывает, что повторяемость позиционного сигнала не обязательна для длинного контекста, но пока не даёт причины менять архитектуру без контрольного обучения на целевых данных. Ближайшее практическое решение — добавить вариант в экспериментальную матрицу и заранее проверить, поддержит ли его инфраструктура инференса.
Источники
Иллюстрация: рисунок из статьи «WavePrune: One period is often enough for RoPE», Guancheng Du, Luotian Huang, Shaowen Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


