
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
RL-агент научился сам выделять длинные навыки из потока игровых кадров и применять их вместе с обычными действиями. Wayfarer обошёл IQN и Rainbow среди агентов с одним потоком опыта и сравнялся с параллельным DreamerV3, хотя это нерецензированный препринт и все числа получили сами авторы. Для длинных задач с редкой наградой такой подход может заменить часть навыков, которые разработчики обычно задают вручную.
Как Wayfarer превращает опыт в длинные действия
Опция в обучении с подкреплением — это навык, который агент выбирает одним решением, а затем выполняет несколько шагов до завершения. Вместо последовательности команд «подойти, спуститься, взять ключ» верхняя политика может выбрать один навык и вернуть себе управление после его окончания.
Такие действия помогают там, где награда приходит далеко не сразу. Агенту проще связать результат с несколькими длинными решениями, чем с большой цепочкой движений. Направленное поведение также исследует среду лучше, чем случайный перебор отдельных команд.
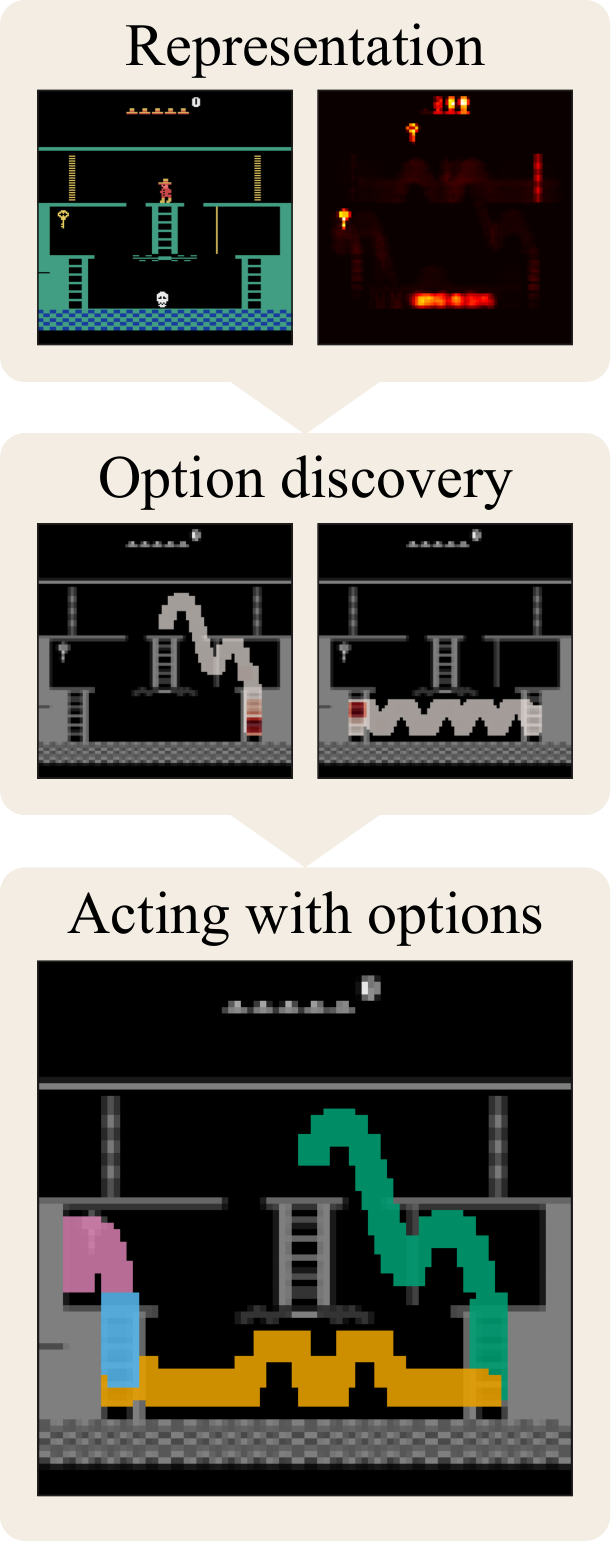
Wayfarer учит одновременно три нейросети. Первая строит представление среды, вторая превращает его направления в навыки, третья выбирает между навыками и обычными действиями ради игровой награды. Все сети используют общий буфер накопленного опыта и обновляются во время взаимодействия со средой.
Представление Лапласа выделяет признаки, которые медленно меняются по мере движения агента. Они описывают крупную структуру среды: например, области, между которыми трудно перейти. Для каждого направления сеть навыков учится как увеличивать, так и уменьшать значение признака, поэтому получает способы двигаться между такими областями без подсказки в виде игровой награды.
Одних медленных признаков недостаточно: таймер, движение машин или анимация тоже могут меняться независимо от действий агента. Поэтому Wayfarer дополнительно учится восстанавливать совершённые действия по наблюдениям. Это заставляет представление сильнее учитывать то, чем агент действительно управляет. В Freeway без такой настройки главный признак отслеживал медленные автомобили, а с ней — вертикальное положение игрового персонажа.
Навыки сначала исследуют границу, затем уступают обычным действиям
Главная сеть оценивает навыки по игровой награде, но сами навыки получают внутреннюю награду за движение вдоль признаков представления. Получается замкнутый цикл: накопленный опыт меняет карту среды, карта задаёт новые навыки, а навыки приводят агента в ещё не изученные состояния.
При этом Wayfarer не обязан навсегда зависеть от найденной опции. Когда навык выполняется, буфер сохраняет и его запуск, и последующие обычные действия. Главная сеть учится повторять полезную траекторию на нижнем уровне. В знакомых областях она постепенно выбирает отдельные действия, а опции оставляет для границы освоенной среды.
Подход проверили на десяти играх Atari 2600, отобранных за сложное исследование и далёкие последствия действий. Агенты получали пиксельные наблюдения, обучались до 200 миллионов кадров и использовали одну конфигурацию параметров во всех играх. Wayfarer показал лучший совокупный результат среди систем, которые собирают один поток опыта, а наибольший выигрыш получил в Montezuma’s Revenge и Private Eye.
Проверка отдельных компонентов показывает, что результат даёт не только базовый алгоритм. После 100 миллионов кадров вариант с найденными опциями превосходил вариант без них в 2,51 раза по медианному нормализованному результату. Если использовать навыки только ради исследования и не давать основной сети выбирать их как действия, самые трудные для исследования игры ещё выигрывают, но совокупный результат становится хуже.
Когда подход стоит учитывать в архитектуре агента
Работа меняет планы команд, которые строят агентов для длинных задач с редкой наградой и пока проектируют промежуточные навыки вручную. Wayfarer показывает рабочую альтернативу: извлекать структуру из наблюдений, учить направленные навыки без разметки и позволять политике решать, когда они полезны для основной цели.
Отдельно полезен механизм переноса. Навык опирается не на конкретную комнату или заданную разработчиком цель, а на направление в выученном представлении. Поэтому поведение, найденное в одной части игры, остаётся доступным в ранее не посещённых частях. Для среды с повторяющейся геометрией или одинаковыми типами переходов это снижает потребность заново осваивать каждую область.
Перестраивать любой RL-стек вокруг опций пока рано. Проверка охватывает пиксельные игры Atari с дискретными действиями, а обучение требует длительного взаимодействия со средой. Работа не показывает, как метод поведёт себя в робототехнике, при непрерывном управлении или в средах, где цена каждого опыта высока.
Практический вывод уже уже: если узкое место связано с исследованием, редкой наградой или слишком длинной цепочкой причин и следствий, стоит сравнить ручную иерархию с опциями, найденными онлайн. Если задача короткая и награда быстро следует за действием, дополнительные сети и меняющийся набор навыков могут лишь усложнить обучение.
Источники
Иллюстрация: рисунок из статьи «Mastering Atari 2600 Games with Discovered Options», Erik M. Lintunen, Marlos C. Machado, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


