
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
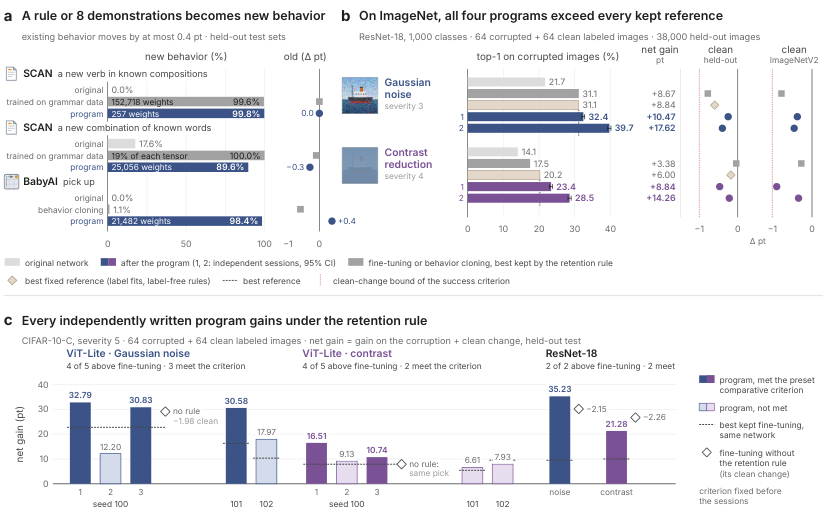
В уже обученную нейросеть удалось добавить новую способность без градиентного дообучения и без отдельной модели во время работы. В препринте Bo Li и соавторов, который ещё не прошёл рецензирование и для которого все числа получили сами авторы, WeightCode дал на ImageNet суммарный прирост от 8,84 до 17,62 процентного пункта: прирост на искажённых изображениях учитывал изменение точности на чистых. LLM при этом нужна только для подготовки программы обновления, а не для обработки каждого запроса.
Как программа превращает знания задачи в новые веса
WeightCode разделяет подготовку обновления и его исполнение. Claude Opus 5.5 с неизменяемыми параметрами пишет программу на Python, которая читает веса целевой сети, запускает прямой проход и анализирует внутренние представления.
На вход программа получает сведения о новой задаче. Это может быть формальное правило, несколько демонстраций, размеченные изображения или описание нужной устойчивости. Она не хранит готовую числовую разницу между старой и новой версиями сети, а описывает, как вычислить изменение для конкретного набора весов.
- LLM изучает архитектуру, веса и реакции сети на примеры.
- Она предлагает вычисление, которое можно встроить в уже существующие внутренние представления.
- Программа меняет не более пятой части весов и проходит восемь проверок на новой и прежней задачах.
- Система сохраняет вариант, который улучшает новую способность и укладывается в допустимое ухудшение старой.
Размеченные данные здесь выбирают программу, но не настраивают веса градиентным спуском. После выбора целевая сеть сохраняет прежнюю архитектуру и выполняет новую операцию самостоятельно: LLM, среда Python и проверочные примеры больше не участвуют в выводе.
Это отличает программу весов от обычного файла с изменёнными параметрами. Если перенести фиксированную числовую поправку в независимо обученную сеть, её внутренние признаки могут находиться в других координатах. WeightCode вместо этого заново измеряет целевую сеть и строит подходящую ей поправку.
Новая функция опирается на вычисления, которые сеть уже умеет выполнять
В задаче SCAN модель должна исполнять новые сочетания известных команд. Программа подняла долю полностью правильных последовательностей с 0 до 99,8%, изменив 257 весов. Она приблизила представление новой команды к представлениям уже известных действий, после чего существующий механизм композиции начал обрабатывать её без перестройки всей модели.
В Vision Transformer программа нашла признаки, по которым шум сдвигал представления фрагментов изображения. Затем она превратила почти неактивные нейроны в условные корректирующие элементы: они включались на зашумлённых данных и вычитали измеренный сдвиг, но почти не влияли на чистые изображения. Проверки отдельных частей программы подтвердили, что прирост давал именно этот механизм.
Повторный запуск программ на независимо обученных Vision Transformer сохранял в среднем 83–110% исходного прироста. Простое копирование готовых изменений весов почти не помогало. Следующая программа также могла добавить устойчивость к другому искажению, сохранив ранее встроенную коррекцию.
Когда WeightCode меняет план разработки
Подход стоит учитывать, если продукт работает с фиксированной моделью, а новую функцию можно точно описать правилом, демонстрациями или небольшим набором примеров. Артефактом становится не очередная версия весов, а исполняемая процедура обновления, которую можно повторно запустить на совместимых экземплярах модели.
Это также позволяет убрать LLM из рабочего контура. Она анализирует сеть и пишет программу один раз, а установленная функция не увеличивает число моделей при выводе. Для локального или пакетного исполнения это отличается от схемы, где LLM постоянно вызывает внешние инструменты либо исправляет ответы основной модели.
«Без дообучения» не означает «без данных и проверки». WeightCode использовал примеры новой задачи, отдельные контрольные наборы и правило сохранения прежнего поведения. Команде всё равно понадобится стенд, который проверяет новую функцию и регрессии, а для другой архитектуры программу придётся строить заново.
Работу проверяли на SCAN, BabyAI, CIFAR-10 и ImageNet с Transformer, Vision Transformer и ResNet. Программы сравнивали с дообучением при одинаковых примерах, числе внешних проверок и требованиях к сохранению прежней точности. Такой протокол показывает, что идея работает в нескольких типах задач, но пока не заменяет обычное обучение как общий способ развивать произвольные производственные модели.
Источники
Иллюстрация: рисунок из статьи «WeightCode: Installing New Capabilities into Neural Networks via Weight-Space Programming», Bo Li, Taoyong Cui, Bob Zhang и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


