
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
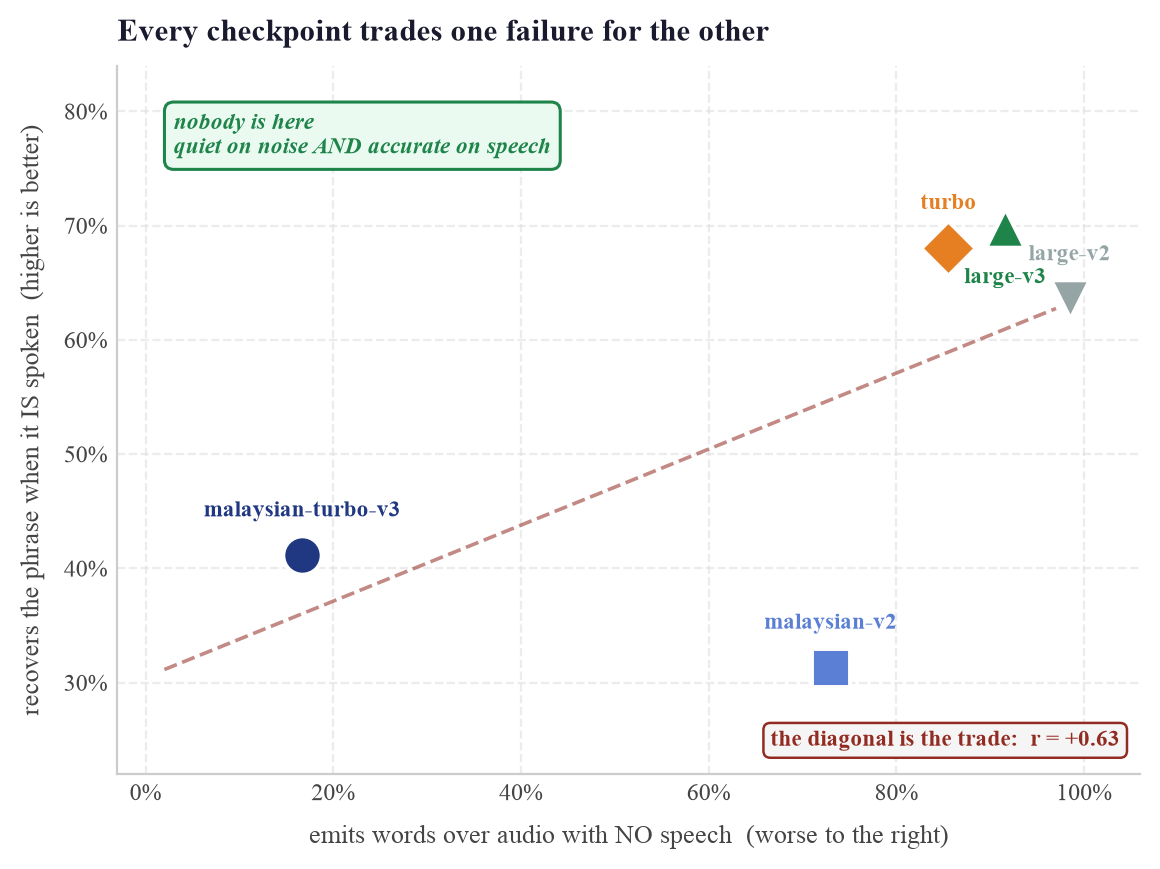
Whisper научили реже придумывать текст на аудио без речи и при этом лучше сохранять настоящие фразы. В препринте Husein Zolkepli из Scicom, который не прошёл рецензирование и содержит собственные замеры автора, лучшая версия снизила долю галлюцинаций на тишине с 61,9% до 2,4%. Результат меняет подход к настройке модели: одних записей шума недостаточно, потому что они могут научить распознаватель молчать даже там, где речь есть.
Одна и та же фраза должна быть и ошибкой, и правильным ответом
Whisper работает как языковая модель, которая опирается на признаки из аудио. Когда речь слышна плохо или отсутствует, языковая часть продолжает строить правдоподобный текст. Так поверх шума, музыки или паузы появляются фразы, которых никто не произносил.
Обычная дистилляция не исправляет это поведение. Whisper размечает аудио для более компактной модели, после чего конвейер удаляет подозрительные расшифровки. Учебный набор становится чище, но вместе с ошибкой исчезает пример, на котором модель могла бы понять: для этого аудио правильный ответ — пустая строка.
Добавление записей без речи решает только половину задачи. Модель учится подавлять вывод, но может связать конкретные фразы с запретом на распознавание вообще. Если человек действительно произнесёт типичное для галлюцинаций «thank you for watching», слишком агрессивная версия Whisper сотрёт и его.
Автор собрал словарь из 40 891 фразы, которые Whisper выдавал без достаточного акустического основания. Затем эти фразы озвучили системой синтеза речи и добавили как правильные примеры. В итоге модель встречала один текст в двух ситуациях: поверх шума его нужно подавить, а при настоящем произнесении — записать.
Проверка учитывала обе ошибки одновременно. В набор вошли тишина, музыка, звуки без голоса, реальные проблемные записи, повторяющаяся речь и обычные речевые корпуса. Отдельная ветка измеряла, распознаёт ли модель синтезированные фразы после добавления пауз и комнатного шума.
Негативные примеры делают модель тише, контраст — разборчивее
Версия Whisper, обученная только на записях без речи, лучше остальных молчала на всех соответствующих ветках, но удаляла 58% повторяющейся речи. Такой результат нельзя считать исправлением галлюцинаций: модель обменяла выдуманный текст на пропуски настоящего.
Синтетические записи изменили этот компромисс. Они снизили выдачу слов на реальном аудио без голоса в 31 из 33 парных запусков, которые различались только наличием таких записей. Восстановление действительно произнесённых фраз улучшилось в 32 запусках.
Помог не только состав данных, но и место настройки. Компактные адаптеры LoRA почти не учили модель останавливаться, когда меняли только механизм внимания. Подключение двух полносвязных слоёв декодера давало лучший результат даже при меньшем числе обучаемых параметров. Значит, для этой ошибки важен не столько размер адаптера, сколько охват нужных частей модели.
Обычная ошибка обучения оказалась плохим критерием выбора. Набор с большим числом пустых ответов было проще выучить, поэтому он давал меньшую ошибку, хотя итоговая модель хуже распознавала речь. Подбирать версию только по графику обучения здесь опасно: необходима отдельная проверка подавления и восстановления.
Планы стоит менять для настройки, но не для немедленной замены конвейера
Командам, которые дистиллируют Whisper или дообучают его под свои записи, работа предлагает практическое изменение. Проблемные псевдоразметки не стоит только удалять: аудио без речи нужно сохранять как отрицательные примеры, а типичные выдуманные фразы — добавлять в виде настоящей речи. Иначе распознаватель может стать тише за счёт пропусков.
Проверочный набор тоже должен измерять две стороны поведения. Нужны записи, где модель обязана вернуть пустой ответ, и записи с теми же фразами, которые она обязана распознать. Отдельно следует тестировать повторения: модель может перестать зацикливаться лишь потому, что начала стирать повторяющуюся речь.
Внешние средства защиты пока сохраняют смысл. Детектор голоса, пороги отсутствия речи и фильтры фраз помогают до вызова модели или после него, хотя не исправляют её веса. Настройка весов полезна там, где другой сервер не поддерживает родной алгоритм декодирования Whisper и его защитные параметры становятся недоступны.
Основной перебор проводили на whisper-large-v3, а аудио имело частоту дискретизации 16 кГц. Позитивный набор в основном состоял из синтезированной речи и чтения, тогда как разговорная речь была представлена уже. Ветка с чистой тишиной содержала 42 записи, поэтому небольшие различия между близкими версиями по ней ненадёжны.
Есть и более существенная цена: каждая настроенная версия ухудшила результат на многоязычном FLEURS, а даже лучшая была примерно на 25% хуже исходной по доле ошибочных символов. Английская проверка почти не показывала этого ущерба. Перед внедрением метод нужно повторить на языках, каналах связи и типах шума конкретного продукта; пока работа подтверждает принцип обучения, а не готовую универсальную замену производственной модели.
Источники
Иллюстрация: рисунок из статьи «How to Reduce Whisper Hallucination», Husein Zolkepli, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


