
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
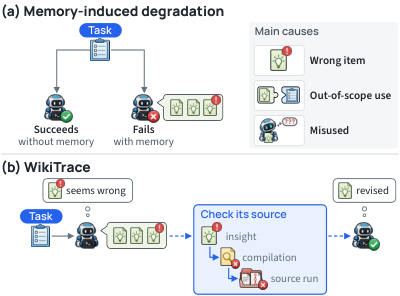
LLM-агента научили проверять советы из внешней памяти по исходной истории действий, прежде чем применять их к новой задаче. Работа KAIST и DeepAuto.ai, которая не прошла рецензирование и приводит числа, полученные самими авторами, показала: WikiTrace обошла варианты памяти без такой проверки во всех тестовых наборах. Для продуктовых команд происхождение записи становится частью архитектуры агента, а не служебной метаинформацией.
Краткий совет из памяти может исказить удачный опыт
Внешняя память хранит опыт вне параметров модели: агент получает правила, процедуры или выводы из прошлых запусков и использует их в новых задачах. Обычно такую запись извлекают из траектории — последовательности рассуждений, действий и ответов среды — вместе с итоговой меткой успеха или провала.
Эта метка не объясняет, какое действие привело к результату. Модель может связать успех с несущественным шагом, неправильно определить область применения правила или превратить случайность в общий совет. После сжатия исходная траектория часто исчезает из доступного агенту контекста, поэтому проверить вывод уже нельзя.
Разбор провалов показал, что в 52% случаев агент отклонялся от верного решения из-за записи, которой последовал. Иногда запись была ошибочной, иногда подходила только для другой ситуации или конфликтовала с более полезным правилом.
В одном примере из ALFWorld память сообщала, что задание с лампой заканчивается, когда предмет находится рядом с включённой лампой. Исходный запуск говорил обратное: агент сначала взял предмет, а затем включил лампу. Без доступа к этой истории ошибочный пересказ выглядел как готовая инструкция.
Средняя точность скрывает такую проблему. Память может помочь с новыми сложными задачами, но одновременно сломать часть уже решавшихся. Поэтому в работе отдельно считают долю исправленных провалов и долю откатов — случаев, когда агент справлялся без памяти, но ошибался после её подключения.
Как WikiTrace связывает правило с доказательством
WikiTrace хранит опыт в трёх связанных слоях. Наверху лежит короткий совет: что делать, когда он применим и из какого запуска получен. Ниже находится разбор ключевых решений и наблюдений, а внизу — неизменённая траектория со всеми действиями и ответами среды.
Разбор остаётся интерпретацией, а не подтверждённым объяснением результата. Его задача — дать агенту быстрый путь к существенным деталям. Если краткого пересказа недостаточно, агент может открыть первичную запись и увидеть, что произошло на самом деле.
При выполнении новой задачи агент сначала получает все советы и указатели на похожие прошлые запуски. Он переходит к разбору и исходной траектории, если совету не хватает деталей, он получен из провального запуска, противоречит другой записи или привёл к неудачному действию. Память подключена как набор файлов только для чтения, которые агент просматривает через инструменты терминала.
Такой спуск меняет роль памяти. Запись больше не служит безусловной командой: это гипотеза с доступным основанием. В PlanCraft агент обнаружил два противоречащих совета о порядке добавления материалов, открыл связанные запуски и увидел, что промежуточный результат не мешает продолжить рецепт. Вариант с теми же советами, но без исходных траекторий, последовал ошибочному правилу и провалил задачу.
Что меняется в архитектуре продуктового агента
В среднем WikiTrace дала на 10,7 пункта больше, чем агент без памяти, и на 3,2 пункта больше, чем вариант с теми же советами без исходных данных. Доля откатов снизилась с 6,5% до 4,5%. Проверка источников увеличила расходы на выполнение задачи в 1,17 раза по сравнению с вариантом, который видел только советы.
Метод проверяли в ALFWorld, ScienceWorld, PlanCraft, AppWorld и среде с диалогом и инструментами для розничных операций. Тесты охватывали текстовые миры, работу с API и две модели семейств DeepSeek и GLM. WikiTrace сравнивали как с агентом без памяти, так и с AWM, ExpeL, ReasoningBank и собственной контрольной версией без доступа к доказательствам.
Работа меняет планы команд, которые собираются накапливать процедурный опыт агента. Схема памяти должна хранить не только итоговый совет, но и идентификатор запуска, краткий разбор и исходные наблюдения. Исполнитель также должен понимать, когда перепроверять запись: при конфликте, нехватке деталей, сомнительном происхождении или неудачном действии.
Для оценки такой системы недостаточно общей доли успешно выполненных задач. Отдельная метрика откатов покажет, не покупает ли команда новые возможности ценой нестабильности на знакомых сценариях. Это особенно существенно для процессов, где агент постепенно накапливает инструкции из собственных запусков.
Эксперимент использует фиксированную память, которую строят заранее и не изменяют во время теста. Все советы помещаются в первое сообщение агенту, поэтому при большом архиве понадобится отдельный механизм поиска релевантных записей. WikiTrace решает проверку найденного совета, но не задачу выбора из памяти, которая перестала помещаться в контекст.
Причины отдельных провалов классифицировала модель-оценщик по записанным рассуждениям агента. Такой анализ показывает, как агент объясняет своё решение, но не доказывает внутреннюю причину ошибки. Практический результат от этого не исчезает: контрольная версия с теми же советами позволяет отделить пользу исходных траекторий от качества самих записей.
Источники
Иллюстрация: рисунок из статьи «Don't Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents», Yukyeong Lee, Yumin Choi, Jinheon Baek и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


