
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Несколько уже обученных политик можно объединить в один контроллер, который передаёт им управление на разных этапах задачи. В препринте University of Toronto и Vector Institute, который не прошёл рецензирование и содержит замеры самих авторов, такой контроллер поднял среднюю долю успешных эпизодов с 44% до 58%. Команде не нужно переобучать исходные политики, но придётся добавить модель среды и единый способ оценивать их будущие состояния.
Как сравнить политики с разными функциями ценности
Целеобусловленная политика получает текущее состояние и цель, а затем выбирает действие. Разные алгоритмы могут хорошо решать отдельные части одной задачи: одна политика подводит захват к кубу, другая надёжнее хватает и переносит его.
Обычно команда сравнивает кандидатов по средней успешности и оставляет победителя. Так теряются политики, которые слабы на всём эпизоде, но полезны в конкретном состоянии. Напрямую сопоставить их внутренние оценки тоже нельзя: алгоритмы обучают функции ценности с разными шкалами, а некоторые политики обходятся без них.
World-Model Policy Arbiter, или WMPA, сравнивает не внутренние оценки, а предсказанные последствия действий. В каждой точке выбора он запускает каждую замороженную политику внутри модели мира (world model), получает несколько возможных будущих состояний и оценивает их общей функцией ценности. Побеждает политика, чья ветка лучше продвигается к заданной цели.
После выбора WMPA отдаёт победителю управление на короткий фиксированный интервал. Это не позволяет контроллеру переключаться после каждого действия и разрушать уже начатое движение. Затем арбитр получает реальное состояние и повторяет процедуру.
Исходный портфель включал шесть алгоритмов OGBench с одинаковыми интерфейсами состояния, действия и цели. Проверка охватывала 18 наборов данных с состояниями среды: навигацию по лабиринтам, перемещение кубов и объектов сцены, а также комбинаторные головоломки. Все политики обучались на офлайн-данных и оставались неизменными во время работы арбитра.
Портфель выигрывает за счёт смены политики внутри эпизода
Если для каждого набора заранее выбрать лучшую отдельную политику, средняя успешность составляет 44%. WMPA довёл её до 58%, причём статистически значимый выигрыш получился на 12 наборах. Среднее здесь рассчитано так, что каждый набор влияет на итог одинаково.
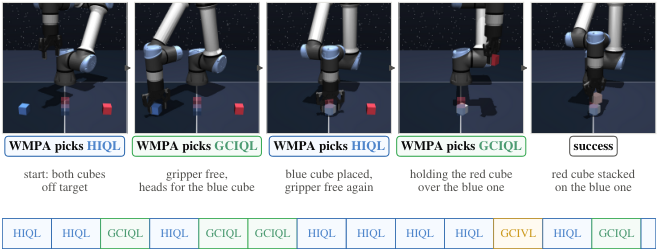
На cube-double-play лучшая отдельная политика завершала задачу в 36% эпизодов, а WMPA — в 69%. Арбитр чередовал HIQL, которая подводила свободный захват к следующему кубу, и GCIQL, которая лучше справлялась с захватом и размещением. Ни одна из них по отдельности не воспроизводила всю последовательность так же надёжно.
Случайное переключение с тем же интервалом не дало сопоставимого результата. Значит, выигрыш создаёт не разнообразие само по себе, а оценка будущих состояний. На cube-triple-play арбитр, напротив, уступил лучшей политике: модель мира и общая функция ценности не гарантируют полезную композицию, если кандидаты плохо дополняют друг друга или прогноз недостаточно точно их ранжирует.
Для лабиринтов, кубов и сцен авторы использовали оценку через расстояние между представлениями состояния и цели. В головоломках геометрическая близость плохо описывает прогресс, поэтому там состояние и цель оценивала обычная нейросеть без требования представить их как точки в метрическом пространстве. Выбор оценщика зависит от структуры задачи, а не только от качества исходных политик.
Когда арбитр стоит добавить в архитектуру
Работа меняет планы команд, у которых уже накопилось несколько контроллеров для одной среды. Вместо выбора единственного победителя их можно сохранить как портфель и вынести композицию на этап выполнения. Особенно полезен такой подход для длинных задач с различимыми фазами, где разные методы уже показывают разные сильные стороны.
WMPA не требует менять параметры политик и обращается с ними как с закрытыми компонентами: достаточно получить действие по состоянию и цели. Однако «без переобучения» относится только к политикам. Команде всё равно нужно обучить на журнале переходов модель динамики и общую функцию ценности, а затем проверить, правильно ли она ранжирует состояния именно для своей задачи.
Ещё одно архитектурное условие — общий интерфейс. Все участники портфеля должны принимать одинаковое состояние и цель и выдавать действия в одном пространстве. Если продукты используют разные представления наблюдений или несовместимые исполнительные контуры, сначала понадобится слой преобразования, которого работа не рассматривает.
При равной длине прогноза и интервала управления вычислительная стоимость на шаг не растёт вместе с горизонтом: длинный прогноз запускается реже. В экспериментах арбитраж добавлял 3–4 мс на шаг при работе на восьми потоках CPU. Для управления с жёстким пределом задержки это отдельный бюджет, а для офлайн-автоматизации или более медленных физических процессов такая цена может оказаться приемлемой.
Практический вывод не в том, чтобы заменить обучение сильной политики модельным планированием. WMPA предлагает промежуточный вариант: оставить существующие политики неизменными и использовать модель среды только как арбитра. Проверять этот вариант разумно там, где портфель уже разнообразен, данные переходов доступны, а ошибки отдельных политик приходятся на разные фазы задачи.
Источники
Иллюстрация: рисунок из статьи «World-Model Policy Arbiter for Goal-Conditioned Reinforcement Learning», Junwei Quan, Evgenii Opryshko, Nicholas Rhinehart и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


