
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Синтетические задания для терминальных агентов удалось сделать длиннее и полезнее для обучения, сохранив в них реальные рабочие файлы. Работа команды City University of Hong Kong, WeChat AI, Tencent и MBZUAI не прошла рецензирование, а все числа в ней получили сами авторы: после обучения точность Qwen3.5-27B в Terminal-Bench 2.1 выросла с 43,1% до 61,8%. Для команд это предлагает другой порядок подготовки данных: начинать не с придуманной инструкции, а с исходных материалов и требуемого результата.
Переход связывает инструкцию с рабочей средой
Обычные способы синтеза расходятся в двух направлениях. Можно сначала придумать сложную инструкцию, а затем собрать под неё среду, но такая среда часто выглядит искусственно. Можно взять настоящий репозиторий или набор документов, но тогда задание легко сводится к чтению файла, поиску значения или краткому пересказу.
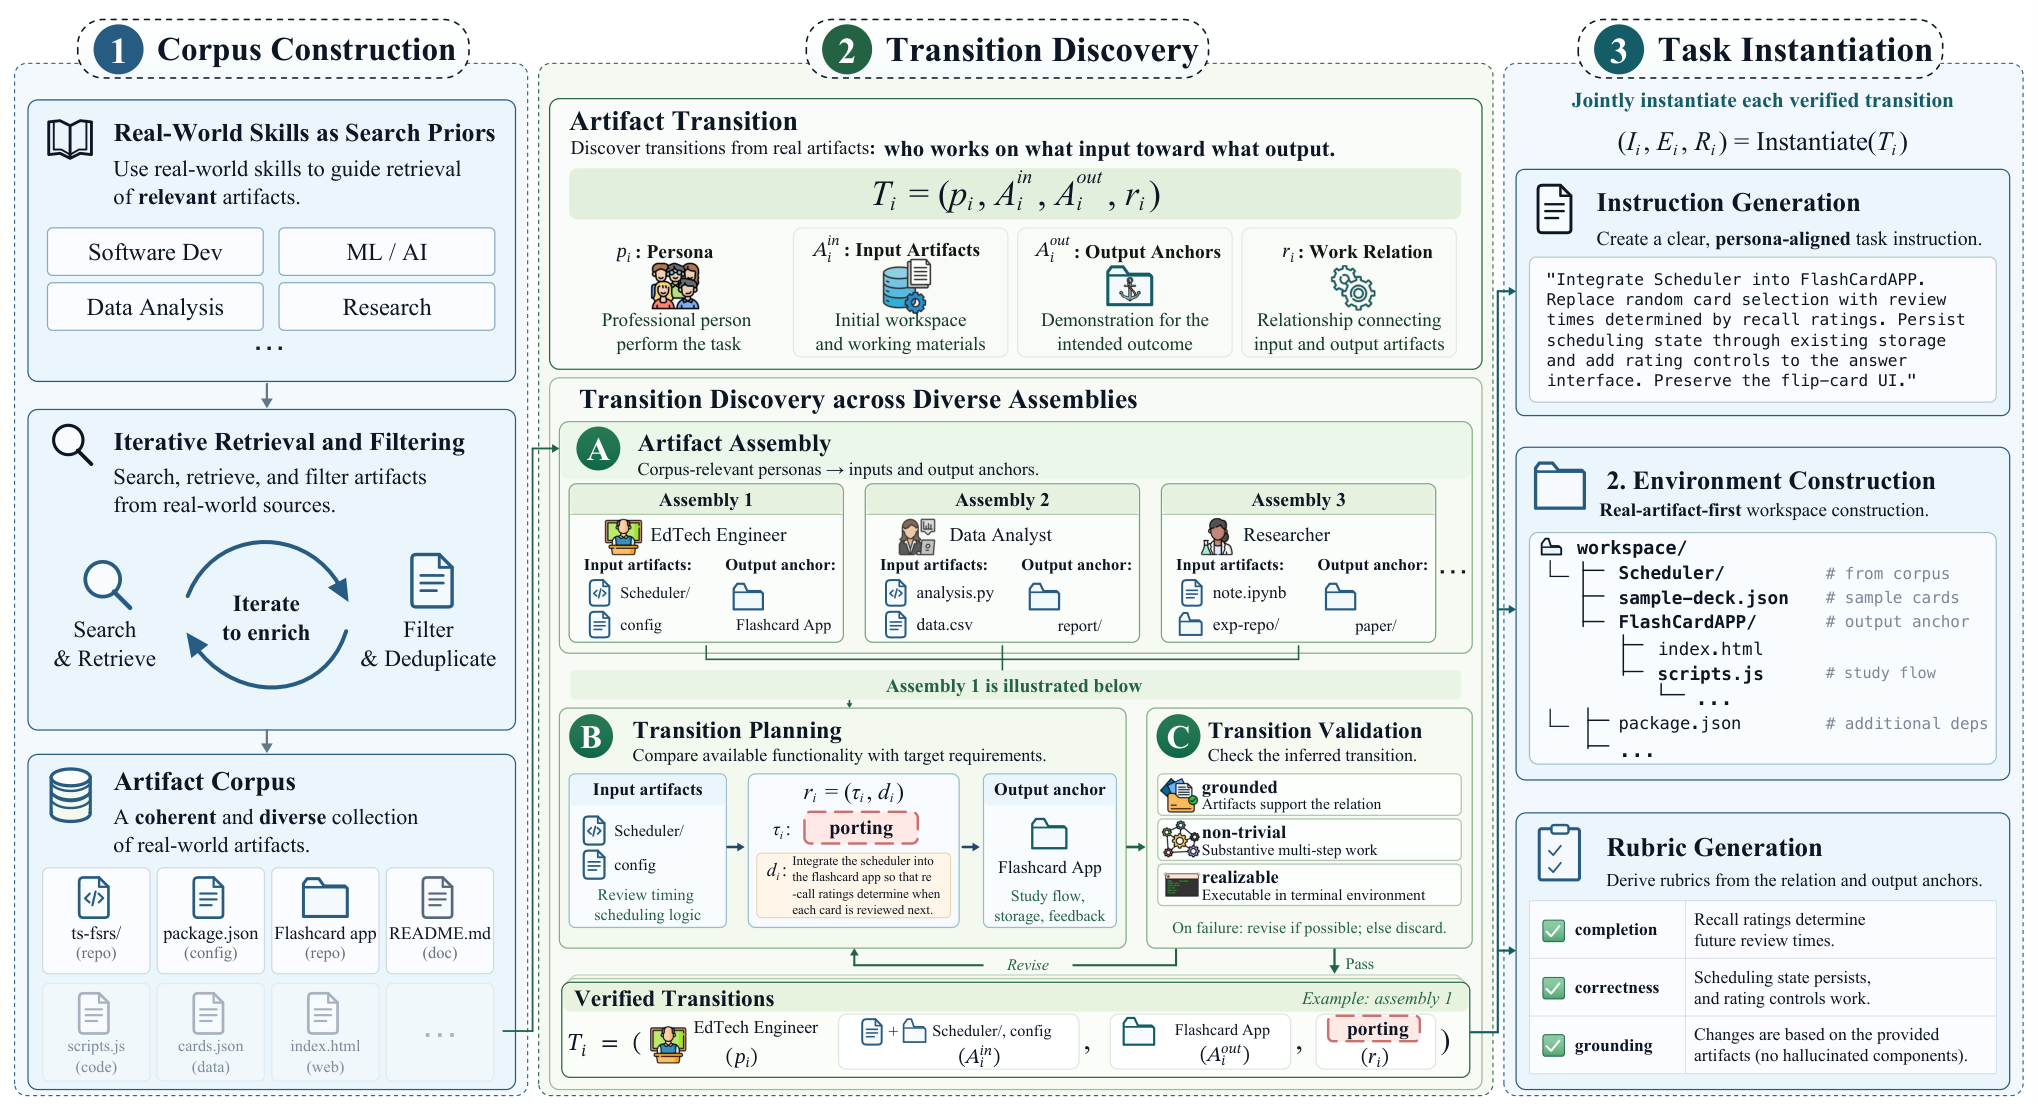
WorkBorne считает основой задания переход между цифровыми материалами. Он описывает, кто выполняет работу, какие файлы доступны в начале, каким должен быть результат и как преобразовать первое во второе. Так инструкция, среда и критерии проверки возникают из одной структуры, а не создаются независимо.
Например, система может взять библиотеку планирования повторений ts-fsrs как исходный материал, а приложение SimpleFlashCard — как образец результата. Задание требует не скопировать код и не описать библиотеку, а перенести её логику в учебный процесс приложения, сохранив нужное поведение.
Сначала WorkBorne собирает связанные материалы из интернета: исходный код, документацию, наборы данных и конфигурационные файлы, которые могут встречаться в одном рабочем процессе. Получилось 1 061 такая коллекция, из которых система построила 7 882 исполняемых среды и сохранила 15 485 траекторий — записей последовательных действий агента.
Затем система выбирает подходящую профессиональную роль, разделяет материалы на исходные файлы и образцы результата, после чего выводит необходимое преобразование: адаптацию, расширение, перенос или объединение. Отдельный агент отбрасывает задания, которые решаются простым копированием либо не выполняются в подготовленной среде.
На последнем этапе один и тот же переход превращается в инструкцию, рабочую директорию и проверяемые критерии. Исходные файлы по возможности копируются без изменений, а образец результата очищается так, чтобы не раскрывать готовое решение.
Структура результата удлиняет работу агента
В контролируемом сравнении WorkBorne сопоставили с конвейером, который использовал те же исходные материалы, но не строил переход к образцу результата. При одинаковом объёме обучающих данных средняя длина выполнения выросла с 27,8 до 44,5 хода агента. Точность в Terminal-Bench 2.1 одновременно поднялась с 48,3% до 51,7%.
Количество файлов само по себе почти не определяло длину работы. Сильнее влияли сочетание исходных материалов и образца результата, форма этого образца и тип преобразования. Для одной и той же пары репозиториев структурное подражание требовало меньше действий, чем перенос функциональности.
Это различие полезно при проектировании заданий. Большая директория не делает задачу длинной автоматически: агент может найти один нужный файл и закончить работу. Образец результата задаёт несколько связанных обязательств — структуру, поведение и совместимость, — поэтому агенту приходится менять файлы, запускать проверки и исправлять ошибки.
Командам стоит расширять набор рабочих контекстов
Работа меняет планы команд, которые самостоятельно готовят данные для терминальных агентов. Вместо генерации сотен инструкций вокруг одного репозитория сначала стоит собрать несколько целостных рабочих контекстов, а затем определить для каждого правдоподобные результаты и переходы к ним. В экспериментах разнообразие коллекций давало больше пользы при одинаковом бюджете, чем дополнительные переходы внутри небольшого числа коллекций.
Практический конвейер можно разделить на четыре шага. Команда собирает связанные файлы, выбирает исходное состояние и образец результата, описывает требуемое преобразование, а затем из него одновременно выводит инструкцию и критерии проверки. Проверять нужно не сходство с эталонным текстом, а работоспособность результата и его связь с предоставленной средой.
Такой подход также помогает отделить сложность задания от случайного объёма репозитория. Если задача должна проверять длительную автономную работу, полезнее усложнять отношения между файлами и ожидаемым результатом, чем добавлять документы, которые агент может не открыть.
Проверяли подход на Qwen3.5-27B и Qwen3.5-35B-A3B в Terminal-Bench Lite, Terminal-Bench 2.1 и общей части ClawEval. Для синтеза использовали Opus-4.6, траектории собирали с Kimi-K3, а модели обучали на 128 GPU H20. Поэтому результаты прямо относятся к дообучению терминальных агентов в крупном конвейере; работа не показывает, что тот же прирост сохранится для других классов агентов или при меньших вычислительных ресурсах.
Источники
Иллюстрация: рисунок из статьи «WorkBorne: Discovering Agentic Tasks from Real-World Artifact Transitions», Junyi Zhou, Yufei Wang, Qiyuan Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


