
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
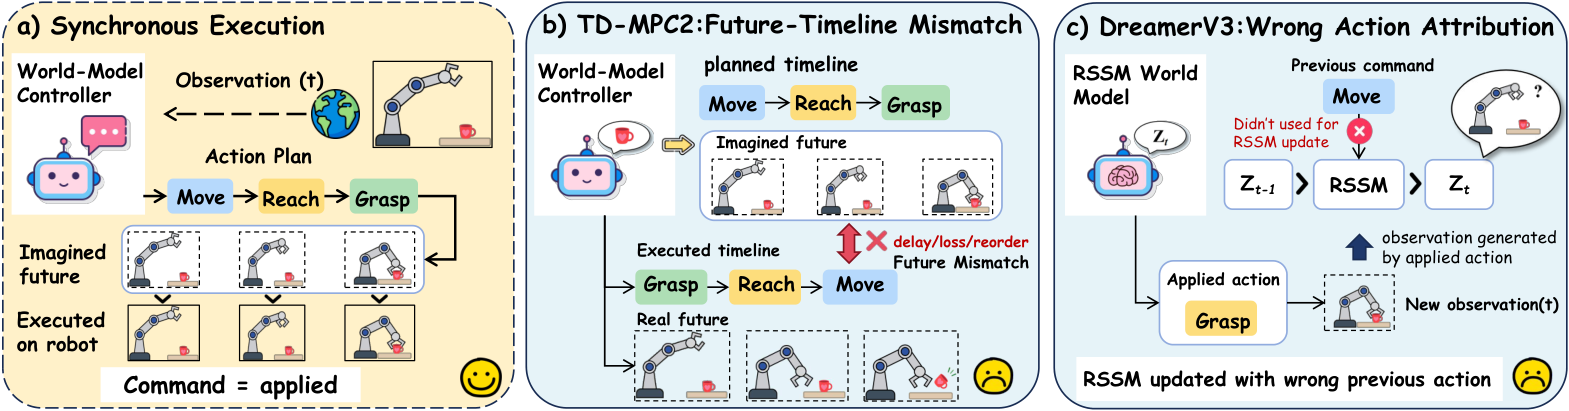
Задержка между отправкой команды и её исполнением заставляет контроллер с моделью мира строить прогноз по действиям, которые механизм фактически не выполнит. В препринте команды Nanjing University of Aeronautics and Astronautics, Tsinghua University и Nanjing University, который не проходил рецензирование и где числа получили сами авторы, передача будущей последовательности действий оказалась надёжнее отправки одной команды. Для внедрения это переносит часть требований с самой модели на протокол связи, исполнительный буфер и обратную связь от привода.
Одна команда попадает в две временные линии
Контроллер формирует команду, но среда меняется под действием того, что действительно дошло до исполнительного механизма. Задержка, потеря пакета, изменение порядка доставки или уже заполненный буфер могут развести эти действия.
Для обычного контура управления такое расхождение выглядит как внешняя помеха. Для модели мира проблема глубже: действие служит не только управляющим сигналом, но и входом для прогноза. Если модель получила одну последовательность, а механизм исполнил другую, прогноз описывает уже не тот процесс.
Авторы изолировали этот эффект, повторяя одну и ту же запланированную последовательность из одинаковых состояний среды, но меняя задержку доставки. Чем сильнее расходились команды и исполненные действия, тем меньше награды набирал контроллер на коротком отрезке, хотя сам план не менялся.
Передача текущего исполненного действия или содержимого буфера не исправила TD-MPC2. Контроллеру требовалась будущая последовательность, причём её нужно было подать внутрь прогноза скрытых состояний. Использование тех же сведений только при итоговой оценке траекторий не помогало.
TD-MPC2 и DreamerV3 требуют разных исправлений
TD-MPC2 заранее прогоняет возможные действия через модель мира. При асинхронном исполнении его внутренняя временная линия расходится с последовательностью на стороне привода. Интерфейс Future-Sequence поэтому отправляет не одну ближайшую команду, а оставшуюся часть плана вместе с индексом поколения.
Исполнитель хранит последнюю действительную последовательность и продолжает её, если новая посылка задержалась. Более свежий план заменяет ещё не выполненный остаток, а опоздавший старый пакет уже не может перезаписать буфер.
На неблагоприятных режимах средняя нормированная награда Future-Sequence составила 0,733 против 0,278 у отправки одиночного действия. Однако почти весь выигрыш дал уже обновляемый буфер: он отстал всего на 0,016. Более заметное отличие возникло при потере пакетов — 0,601 против 0,537.
DreamerV3 ломается в другом месте. Его рекуррентная модель обновляет внутреннее состояние по предыдущему действию и новому наблюдению. Если наблюдение возникло после одного физического действия, а модель связывает переход с другой отправленной командой, она неверно объясняет изменение среды.
Applied-Action Feedback возвращает вместе с наблюдением квитанцию об исполнении. Она содержит само действие либо идентификатор пакета и позицию внутри него, по которым контроллер восстанавливает нужную команду из своей истории. Дополнительный обмен сообщениями для этого не требуется.
Такое исправление помогало моделям DreamerV3, обученным на исполненных действиях, но не давало стабильного выигрыша моделям, обученным на отправленных командах. Интерфейс должен совпадать с тем смыслом действия, который модель усвоила при обучении.
Планы меняются на уровне интеграции, а не модели
Работа не предлагает ещё один алгоритм обучения. Параметры контроллеров во время сравнения оставались замороженными, а исправления затрагивали сообщения между планировщиком и исполнительной системой. Поэтому команде не обязательно сразу переобучать модель, если проблема возникает из-за транспорта или буферизации.
Для планирующей архитектуры протокол должен уметь передавать продолжение плана, его временные позиции и версию. Буфер на стороне механизма должен принимать более свежие планы, заменять только будущие действия и отбрасывать устаревшие пакеты. Отправка одной команды с повтором последнего значения не сохраняет временную линию, которую оценивал планировщик.
Для рекуррентной архитектуры важнее журнал фактически исполненных действий. Наблюдение следует связывать с конкретным действием, которое вызвало переход, а не с последней командой в памяти контроллера. При этом замена команды на исполненное действие без проверки обучающей схемы может ухудшить результат.
Эффект проверяли на TD-MPC2 и DreamerV3 в DeepMind Control Suite, а дополнительные опыты охватывали MetaWorld, ManiSkill2 и MyoSuite. Испытания включали задержки, потерю и перестановку пакетов, измеренные сетевые трассы и стек, где управление и исполнение работали в отдельных процессах. Эти условия показывают устойчивость механизма в изученных контроллерах, но не превращают конкретные интерфейсы в универсальную схему для любой модели мира.
Практический вывод состоит в том, что асинхронность нельзя закрыть только тайм-аутом транспорта. Сначала нужно определить, где архитектура использует действие: при прогнозе будущей траектории или при объяснении уже произошедшего перехода. От этого зависит, что передавать через границу между моделью и исполнительной системой.
Источники
Иллюстрация: рисунок из статьи «Mind the Execution Gap: Action-Semantic Mismatch in World-Model Control», Shengtao Wen, Xiang Chen, Yu Tian и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


