
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Видеомодель научили отвечать на вопросы по длинному потоку, ждать будущего события и возвращаться к уже просмотренному фрагменту, если краткой памяти недостаточно. WTI набрала 83,3% на StreamingBench и стала лучшей среди сравнённых открытых потоковых моделей. Хотя препринт не рецензирован и числа получили сами авторы, работа показывает практичную альтернативу постоянному расширению контекста.
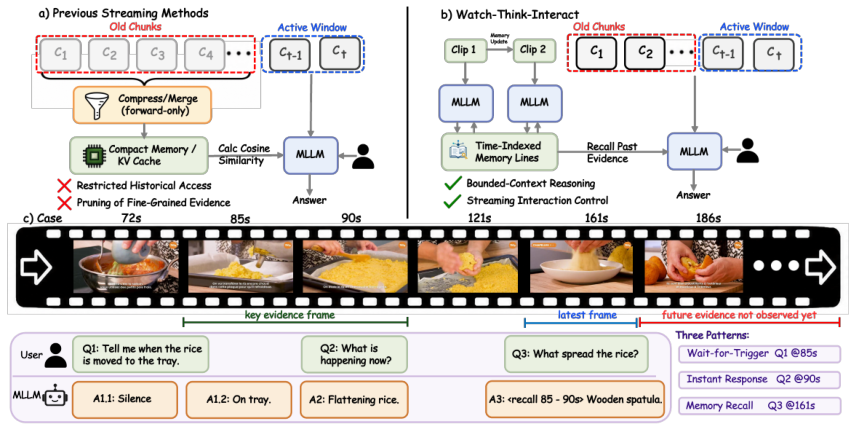
Память хранит не кадры, а адреса доказательств
Потоковая модель видит только начало видео, доступное к текущему моменту. Вопросы приходят асинхронно: один относится к происходящему сейчас, другой — к сцене в прошлом, а на третий пока нельзя ответить, потому что нужное событие ещё не произошло.
Обычная сжатая память плохо работает с поздними вопросами. Она формируется до того, как модель узнает, какая деталь понадобится, поэтому может сохранить общий смысл сцены и выбросить цвет предмета, жест или короткую надпись. Рассуждение поверх такого пересказа не восстановит утраченное изображение.
WTI разделяет текущее восприятие, память и исходное видео. В памяти каждая краткая запись содержит описание события и временной диапазон, где оно произошло. Модель использует описание для простого ответа, а временную метку — как адрес, по которому можно снова загрузить визуальные данные.
На каждом шаге модель выбирает одно из трёх действий: ответить, продолжить просмотр или запросить прошлый интервал. Возврат не переводит поток вперёд: система добавляет найденный фрагмент в видимый контекст и просит модель принять решение заново в тот же момент.
В экспериментах активное окно охватывало восемь секунд. За один шаг разрешался один возврат, который загружал до четырёх ранее просмотренных фрагментов. Полный архив оставался у управляющего компонента, поэтому видимый модели контекст сохранял фиксированный размер, хотя хранилище исходного видео росло вместе с потоком.
Обучение связывает ранние решения с поздними ответами
Для обучения собрали WTI-82K: вопросы объединены в последовательности, где согласованы момент появления вопроса, время достаточного ответа, подтверждающие фрагменты и действия модели. Часть вопросов требует текущего кадра, часть возвращает к прошлому, а часть заставляет ждать будущего события.
Сначала обучение с учителем задаёт формат поведения: когда молчать, отвечать, обращаться к архиву и переписывать память. Затем Stream-GDPO оценивает целую последовательность взаимодействий, а не отдельный ответ. Это важно, потому что преждевременный ответ или неудачное сжатие памяти меняют состояние, с которым модель встретит следующие вопросы.
Алгоритм отдельно учитывает правильность ответа, соблюдение формата, уместность возврата и качество памяти. Перед объединением эти сигналы нормализуются по отдельности, чтобы изменчивость одного показателя не заглушала остальные. Награда за возврат засчитывается только тогда, когда запрос соответствует нужному интервалу и приводит к правильному ответу.
На StreamingBench, который проверяет понимание видео в реальном времени, WTI получила 83,3% против 79,5% у ближайшей указанной потоковой модели VST-7B. На OVO-Bench, где отдельно проверяют текущие, прошлые и будущие события, итог составил 73,6% против 62,6% у StreamBridge-7B. Если убрать возврат к исходному видео, результат на заданиях о прошлом падает на 17,9 процентного пункта: один текстовый пересказ не заменяет визуальные детали.
Для продукта нужен архив, а не только длинный контекст
Работа меняет архитектурный план для систем, которые наблюдают камеры, записи встреч, производственные процессы или пользовательские сессии в реальном времени. После сжатия очередного участка видео его не стоит считать ненужным: краткая память должна оставаться индексом, а исходные фрагменты — доступным источником доказательств.
Это не отдельная настройка модели. Потребуются архив наблюдённого видео, временные метки в памяти, инструмент выборочной загрузки и управляющий цикл, который повторно вызывает модель после возврата. Протокол также должен запрещать доступ к будущим кадрам и отличать ситуацию «ответ неизвестен» от ситуации «нужно продолжить смотреть».
Проверяли WTI-8B на базе Qwen3-VL-8B-Instruct: видео поступало секундными фрагментами, а StreamingBench и OVO-Bench сравнивали систему с открытыми потоковыми и обычными видеомоделями. Дополнительные наборы для длинного видео показали, что механизм не ухудшил общую способность работать с продолжительными записями.
Работа сравнивает прежде всего точность, а не эксплуатационную цену. Перед внедрением придётся отдельно измерить задержку повторной загрузки, объём архива и частоту обращений к нему на собственных потоках. Но сам принцип уже пригоден для проектирования: ограничивать нужно контекст модели, а не доступ системы к ранее увиденным данным.
Источники
Иллюстрация: рисунок из статьи «Watch-Think-Interact: Bootstrapping Long-Horizon Multi-Turn Streaming Video Reasoning with Reinforcement Learning», Ziheng Huang, Yicheng Bao, Xueheng Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


