
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
История прошлых попыток помогает LLM надёжнее оценить, верен ли её новый ответ. Caiqi Zhang и коллеги описали XConf: в 23 из 24 сравнений он не уступил самосогласованности при одной десятой числа генераций ответа; поскольку работа не прошла рецензирование, числа в ней получили сами авторы. Такой сигнал можно использовать, чтобы принять результат, отправить его человеку или запустить ещё одну попытку.
Как XConf превращает прошлые попытки в оценку уверенности
Обычные способы оценивают только текущий ответ. Модель может назвать вероятность своей правоты, система может прочитать вероятности токенов или несколько раз решить одну задачу и сравнить результаты. Последний подход называют самосогласованностью (self-consistency): если независимые ответы совпадают, система считает результат более надёжным.
XConf добавляет к оценке банк проверенного опыта. После каждой попытки система хранит условие задачи, короткий самоанализ модели, заявленную уверенность, фактический исход и урок, который модель формулирует после проверки. Самоанализ записывают до получения оценки, чтобы знание результата не исказило описание хода решения.
Для нового ответа XConf сначала ищет похожие эпизоды. Поиск учитывает не только задачу, но и исходную уверенность модели: прошлый случай с высокой уверенностью полезнее для оценки нового уверенного ответа, чем случай, где модель изначально сомневалась. Пространство поиска дополнительно настраивают по известным исходам, чтобы сближать эпизоды с похожими причинами успеха и ошибки, а не просто с общей темой.
На этапе Recall система выбирает 50 ближайших эпизодов и вычисляет долю успешных. Если модель обычно заявляла высокую уверенность на подобных задачах, но часто ошибалась, историческая частота механически снижает оценку.
Затем этап Reflect показывает модели найденные записи вместе с уроками. Модель называет повторяющийся сбой и заново оценивает свою уверенность, не решая задачу ещё раз. Итоговый показатель — среднее между исторической частотой успеха и пересмотренной оценкой модели.
Метод не меняет веса LLM и не требует доступа к вероятностям токенов. Он работает поверх API и не сравнивает сами строки ответов, поэтому подходит не только для коротких вопросов, но и для программ и длинных действий агента.
Где история оказалась полезнее повторной генерации
XConf проверили на девяти наборах задач, четырёх моделях из трёх семейств. В тест вошли рассуждения MMLU-Pro, SuperGPQA, BBEH и OlympiadBench, код LiveCodeBench, мультимодальные вопросы MMMU-Pro и агентные среды ScienceWorld, AppWorld и SWE-bench Verified.
Эксперимент охватил Gemini 2.5 Flash, Gemini 3.5 Flash, Claude Sonnet 4.6 и Qwen3.5-397B. Короткие ответы проверяли точным совпадением или моделью-оценщиком, программы — модульными тестами, действия агентов — правилами среды и проверками выполненной задачи. Поэтому оценка уверенности опиралась на внешний исход, а не на мнение той же модели о собственной работе.
Основная метрика AUROC показывает, насколько хорошо оценка ставит успешные ответы выше ошибочных независимо от выбранного порога. Ошибку калибровки измеряли отдельно: она показывает, совпадает ли заявленная вероятность с фактической долей успехов. XConf одновременно лучше разделял верные и неверные результаты и точнее связывал оценку с реальной частотой успеха, особенно на коде и действиях агентов, где ответы трудно сравнивать простым голосованием.
Практический эффект проверили через отказ от самых сомнительных результатов. Если не принимать нижние 10% ответов по уверенности, успешность оставшейся части агентных задач росла вплоть до 8,7 процентного пункта. Это превращает калибровку из диагностической метрики в правило маршрутизации запросов.
Когда XConf меняет архитектуру продукта
Работа меняет планы систем, где результат позже можно проверить: помощников программиста, браузерных агентов, автоматизацию операций и обработку задач с человеческим контролем. Вместо повторной генерации каждого ответа команда может сохранять проверенные эпизоды и использовать их для решения, какой результат принять, повторить или передать оператору.
Для этого обратную связь нужно превратить в часть инфраструктуры. Запись должна связывать исходную задачу, версию модели, её уверенность, итоговую проверку и урок. Важно соблюдать порядок событий: текущий ответ не должен видеть собственную оценку, а банк для него должен содержать только ранее проверенные случаи.
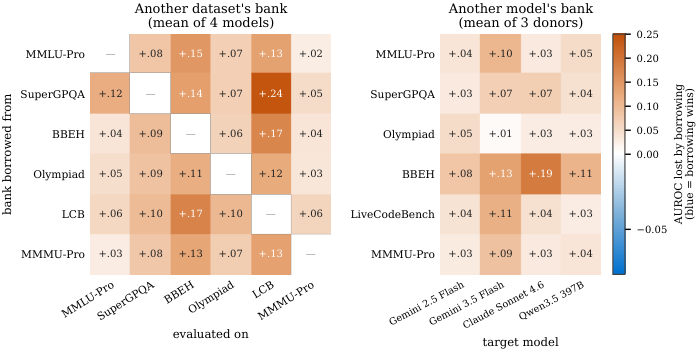
Банк опыта не стоит считать общей базой знаний для любых моделей и доменов. Перенос выявил понятную границу: чужой опыт хуже помогает там, где модели ошибаются по-разному. Отдельно выделился BBEH, а банк без программных задач хуже подходил для кода. Для рабочего контура разумнее вести историю по конкретной модели и типу процесса, а объединять банки только после отдельной проверки калибровки.
Метод также предполагает поток достоверных исходов. Если продукт не узнаёт, выполнил ли агент задачу или прошёл ли код тесты, XConf нечем пополнять. При наличии такой обратной связи банк становится накопительным активом: калибровка улучшалась по мере добавления эпизодов и не требовала повторного обучения LLM.
XConf пока не основание немедленно заменять действующую схему оценки, но достаточный повод сохранить полные журналы проверенных попыток. Такой журнал позволяет испытать калибровку на собственных ошибках модели и сравнить её с повторной генерацией на тех порогах, от которых действительно зависит запуск, эскалация или отказ.
Источники
Иллюстрация: рисунок из статьи «Confidence Comes from Experience: Experiential Confidence Estimation from Reasoning to Agents», Caiqi Zhang, Xiaochen Zhu, Chengzu Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


