
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Систему YouRA научили не терять связь между выводом в рукописи, выполненным кодом и результатом эксперимента на длинном исследовательском маршруте. В препринте Yoonkyu Woo, Woojin Lee и Jin-Xia Huang, который не рецензирован и содержит замеры самих авторов, YouRA получила лучшую итоговую оценку на MLR-Bench при каждом сопоставимом сочетании базовой модели и конкурента. Для команд, которые строят длинные агентные процессы, это аргумент выносить гипотезы, ошибки и доказательства из истории диалога в отдельное постоянное состояние.
Состояние связывает гипотезу с выполненным экспериментом
Обычный агент часто хранит состояние процесса (workflow state) в переписке с моделью. По мере роста контекста ранние решения обрезаются или смешиваются с новыми, а агенту приходится одновременно выполнять задачу и решать, куда двигаться дальше.
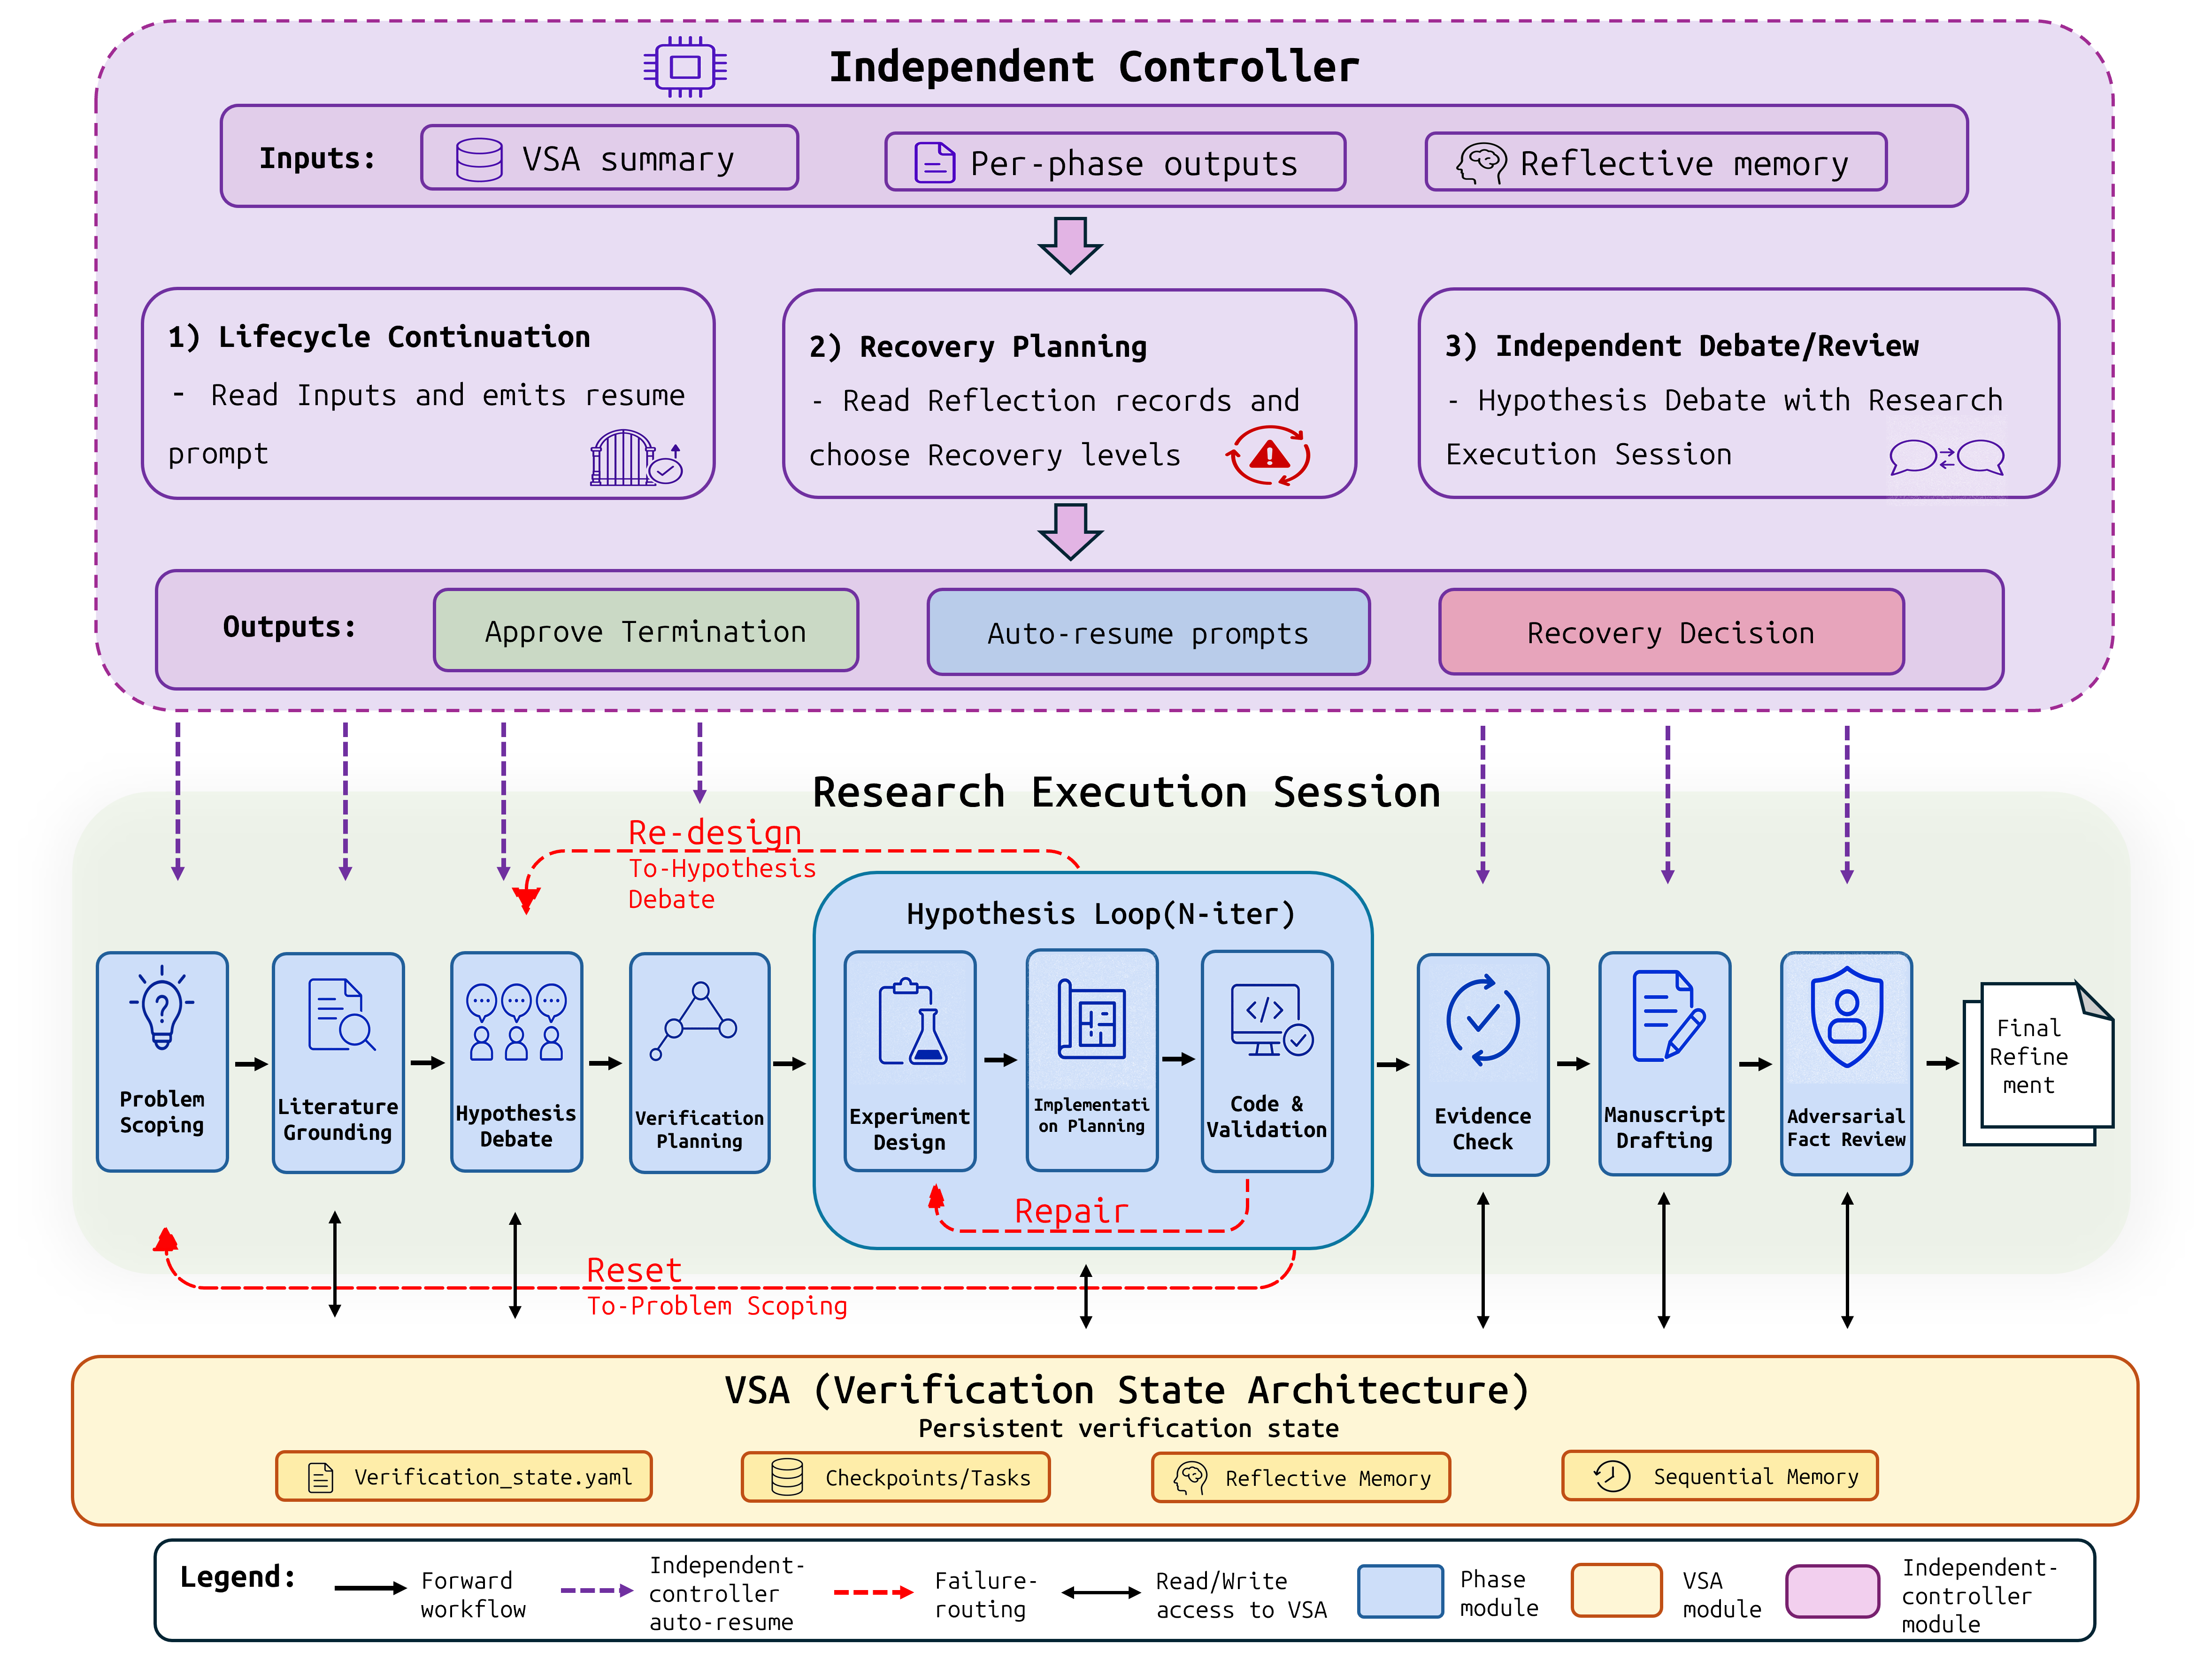
YouRA записывает состояние в структурированные YAML-файлы. Центральный файл хранит гипотезы, результаты обязательных проверок, решения о дальнейшем маршруте, ссылки на код и результаты, а также реестр неудачных гипотез. Каждое изменение получает время и автора, поэтому следующий этап читает не пересказ предыдущего диалога, а устойчивую запись.
Гипотеза продвигается дальше, только если прошла обязательные проверки. При подготовке статьи агент получает ссылки на фактические результаты экспериментов, а не генерирует выводы по памяти. После черновика отдельная проверка сопоставляет утверждения рукописи с состоянием, журналами, кодом и накопленными материалами.
Управление отделено от исполнения. Независимый контроллер читает краткие сводки состояния и выбирает следующий этап, тогда как рабочая модель пишет код, проводит анализ или готовит текст. Поэтому решение повторить эксперимент, пересмотреть гипотезу или вернуться к постановке задачи не зависит только от текущего окна контекста.
Ошибки тоже становятся частью состояния. YouRA сохраняет причину сбоя, подтверждающие или опровергающие материалы и решение о повторном использовании результатов. Сначала система пытается локально исправить код; если обязательная проверка снова не пройдена, она меняет гипотезу или возвращается к постановке проблемы. Отдельный детектор ищет макетные данные и жёстко записанные результаты до того, как эксперимент попадёт в доказательную базу.
Проверяемые следы улучшили итоговую статью
YouRA проверяли на заранее выбранной десятке сквозных задач MLR-Bench: от постановки исследовательского вопроса до экспериментов и готовой статьи. Систему сравнили с MLR-Agent и AI Scientist V2 на трёх одинаковых базовых моделях. Итоговый показатель Overall объединяет оценки качества готовой работы, включая ясность, новизну, обоснованность и значимость.
YouRA обошла лучшую из двух базовых систем на каждом движке: преимущество составило от 0,17 до 0,63 балла Overall. Попарная проверка, которая меняла порядок предъявления работ модели-оценщику, также отдала предпочтение YouRA во всех сопоставимых конфигурациях.
Одной оценки текста недостаточно: убедительная рукопись может опираться на несуществующий эксперимент. Поэтому финальные статьи дополнительно сверяли с кодом и журналами. У YouRA оказалось статистически значимо меньше подтверждённых выдуманных фактов, чем у MLR-Agent; разница с AI Scientist V2 осталась в пределах погрешности. Анализ происхождения данных также чаще относил результаты YouRA к основанным на реальных данных.
Удаление центрального состояния, независимого контроллера, доступа к инструментам или восстановления с учётом прошлых ошибок снижало Overall. При этом сравнение величины падений не показало, какой компонент важнее остальных: результат поддерживает архитектуру в сборе, но не доказывает превосходство отдельного механизма.
Проверка охватывала только задачи машинного и глубокого обучения. Системы работали с разными наборами инструментов и бюджетами токенов, а модель-оценщик отличалась от использованной в исходном исследовании MLR-Bench. Поэтому баллы показывают результат конкретных конфигураций, а не изолированное преимущество одной архитектуры при равной стоимости.
Архитектуру длинного агента стоит пересмотреть до масштабирования
Работа меняет планы команд, если агент уже проходит несколько этапов, запускает код и затем составляет итоговый документ. Истории сообщений для такого процесса недостаточно: даже если модель удерживает контекст, в нём трудно проверить, какой файл подтверждает конкретное утверждение и почему система отказалась от предыдущей гипотезы.
Практический вывод — проектировать гипотезы, проверки, ссылки на материалы и историю ошибок как данные продукта. Контроллер должен восстанавливать маршрут из этих данных, а не из свободного пересказа рабочей модели. Финальный текст следует проверять против выполненных экспериментов до публикации или передачи человеку.
YouRA не представлена как подключаемый модуль для существующего агента: авторы считают эти механизмы частью общей архитектуры. Переход потребует изменить формат состояния, границы этапов и правила восстановления, а не просто добавить долговременную память. Работа пока обосновывает это решение для автономного исследования в машинном обучении; для других научных и бизнес-процессов нужны отдельные проверки.
Источники
Иллюстрация: рисунок из статьи «YouRA: A Persistent-State Architecture for Evidence-Traceable Autonomous Research Agents», Yoonkyu Woo, Woojin Lee, Jin-Xia Huang, CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


