
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Создатели ZGCM-1 открыли полный стек компактной модели: веса разных стадий, код обучения, промежуточные контрольные точки, рецепты данных, журналы экспериментов и средства оценки. Модель с 7,39 млрд параметров поддерживает контекст до 256 тысяч токенов и конкурирует с моделями своего класса в рассуждении, хотя препринт не рецензирован и все числа получили сами авторы. Для команд, которые обучают собственные модели, работа даёт не отдельный приём, а связанный маршрут от архитектуры до агентного поиска.
Гибридное внимание сокращает цену длинного контекста
ZGCM-1 — плотная модель: при обработке каждого токена она использует все параметры, а не выбирает отдельные группы экспертов. Её главное архитектурное отличие — чередование локального и полного внимания в пропорции 5:1.
Локальные слои работают только с небольшим соседним фрагментом текста. Полные слои периодически связывают информацию из всей последовательности, поэтому модель не теряет доступ к началу длинного диалога или истории работы с инструментами. Дополнительный обучаемый затвор регулирует, сколько результата локального внимания передавать дальше.
Варианты архитектуры сравнивали на одной основе и с одинаковым бюджетом обучения на GPU H100. Выбранная схема почти не уступила полному вниманию по функции ошибки, но при максимальном контексте обрабатывала токены в 3,94 раза быстрее. Память под кэш ключей и значений, который хранит промежуточные данные внимания при генерации, сократилась в 6,4 раза.
Это сочетание важно именно для длинных рассуждений и агентных сценариев. Поиск в интернете, вызовы терминала и анализ программ накапливают историю быстрее обычного диалога, а полное внимание заставляет платить за всю эту историю на каждом следующем шаге.
Обучение связывает рассуждение с действиями
Авторы сначала подобрали состав данных на уменьшенной модели, затем обучили основную на веб-текстах, научных материалах, коде, математике и специализированных примерах рассуждений. На ранней стадии обычные тексты подавали от лексически простых к сложным, но код и математику перемешивали отдельно: внешняя сложность текста плохо отражает сложность алгоритма или доказательства.
Для вычислений использовали восьмибитную арифметику FP8 и оптимизатор Muon. Метод TWEO сдерживал редкие слишком большие значения внутри сети, которые иначе делали обучение в низкой точности нестабильным. На контексте 16 тысяч токенов весь набор архитектурных и системных решений дал расчётное ускорение в 4,2 раза до достижения заданной функции ошибки относительно основы с AdamW и BF16.
Это не прямой замер двух полных циклов обучения. Итоговый коэффициент получили, перемножив отдельно измеренные и оценённые выигрыши от внимания, числовой точности, оптимизатора и расположения нормализации. Поэтому число полезно как инженерная декомпозиция затрат, но не как готовая оценка бюджета нового проекта.
На следующей стадии контекст постепенно расширяли и добавляли больше инструкций, рассуждений и действий. Следы взаимодействия с инструментами преобразовали в последовательности «текущее состояние — следующее действие». Так модель училась не просто воспроизводить длинный журнал, а выбирать шаг по доступной ей информации: сформировать запрос, прочитать результат, вызвать команду или продолжить рассуждение.
Финальная настройка смешивала задачи с развёрнутым рассуждением и прямым ответом. Для действий использовали траектории, результат которых можно проверить исполнением. Это снижает риск обучить модель убедительно описывать вызов инструмента, который на практике не работает.
Рецепт полезнее как основа эксперимента, чем как готовая замена
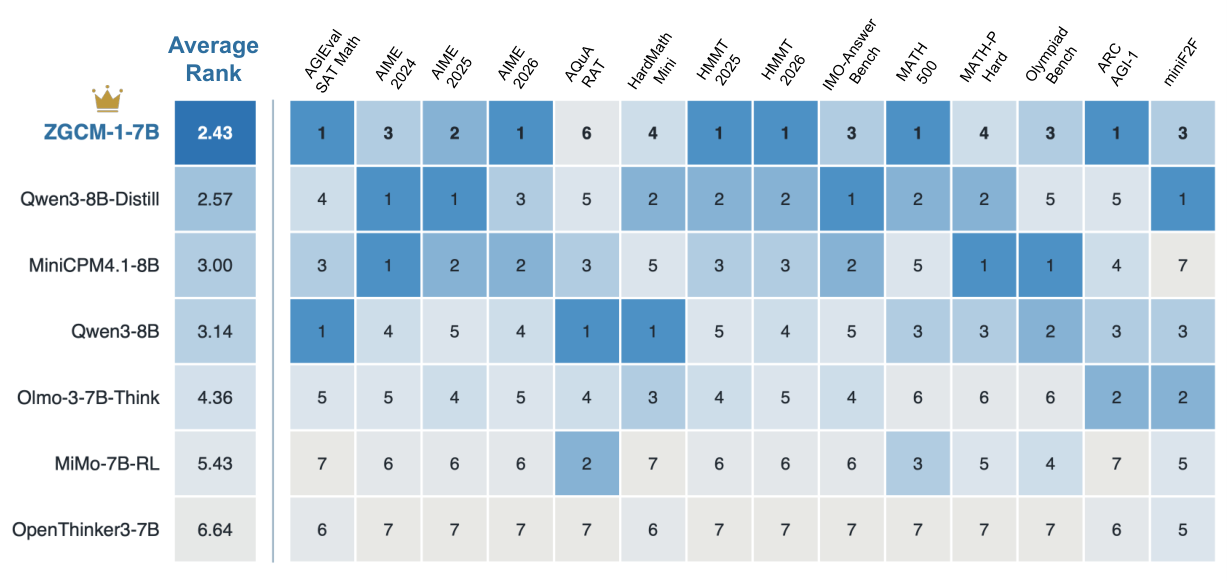
На среднем месте среди 14 тестов рассуждения ZGCM-1 стала лучшей в своём размерном классе. На AIME 2026 модель решила 75% задач, а на WebWalkerQA, где нужно искать сведения по связанным веб-страницам, набрала 63,1%. Сильные результаты охватывают математику, поиск и работу с исполняемыми средами, но не образуют равномерного превосходства: в отдельных тестах кода, знаний и следования инструкциям другие компактные модели остаются впереди.
Проверки проводили как в режиме рассуждения, так и без него. В таблице прямых ответов использовали детерминированную генерацию и один запуск. Значения для внешних моделей взяли из их публикаций, а не получили повторным прогоном в единой среде, поэтому сравнения с Claude, Qwen и GLM-5.1 показывают ориентир, но не заменяют испытания под конкретную нагрузку.
Для команды, которая только вызывает коммерческую модель через API, работа не создаёт причины менять стек. Её практическая ценность выше там, где нужно контролировать веса, данные, длинный контекст и исполнение инструментов либо исследовать собственную базовую модель.
ZGCM-1 позволяет начать не с восстановления скрытых деталей по итоговым весам. Можно сопоставить стадии обучения, проверить рецепты данных, повторить отдельные архитектурные опыты и увидеть журналы запусков. При этом работа не доказывает, что компактная модель заменит крупную во всех агентных задачах: она показывает, как перераспределить ограниченную ёмкость модели между внутренним рассуждением и получением сведений извне.
Автоматизация самой разработки тоже очерчивает разумную границу. Агенты лучше справлялись с запуском и наблюдением за экспериментами, оценкой, развёртыванием и обслуживанием вычислительного кластера. Выбор архитектуры и алгоритма обучения сильнее зависел от решений специалистов. Значит, открытый стек сокращает ручную эксплуатационную работу, но не устраняет необходимость проектировать эксперимент и проверять его выводы.
Источники
Иллюстрация: рисунок из статьи «ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search», Jiyan He, Guang Liang, Hao Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


