
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Число токенов при работе LLM удалось сократить с меньшим ущербом для качества, не обучая базовую модель заново. zip2zip++ закрывает примерно половину разрыва между прежним zip2zip и несжатой моделью при близкой степени сжатия, хотя препринт не рецензирован, а все числа получили сами авторы. Для продуктовых команд это основание тестировать адаптивный словарь там, где длина контекста и стоимость ограничивают систему.
Почему объединение токенов портит ответы
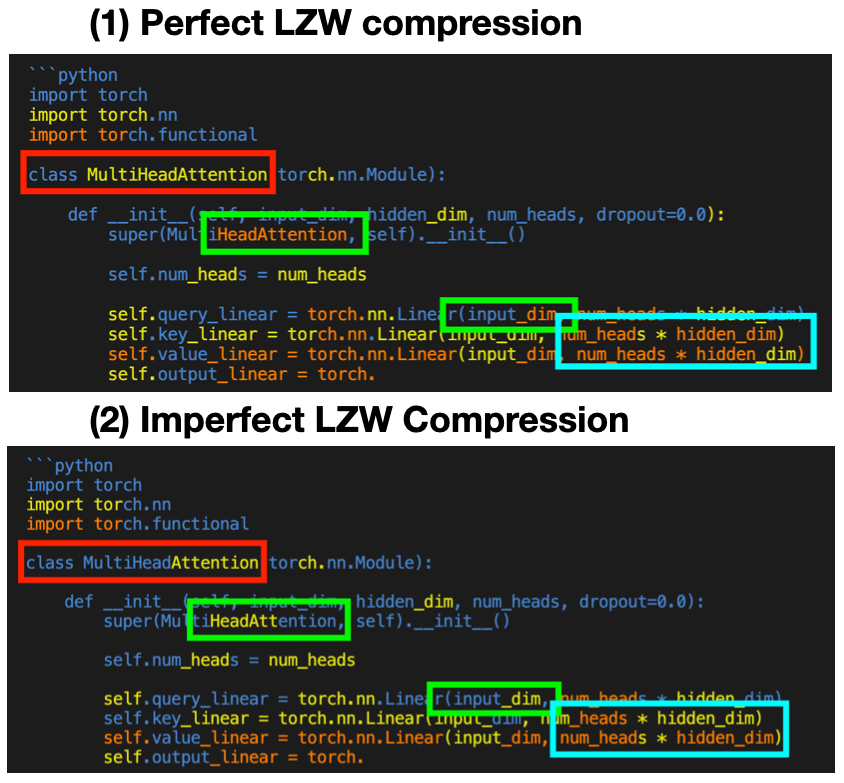
Работа EPFL, Technical University of Munich, Zuse School ELIZA и ETH Zürich развивает zip2zip. Этот метод во время инференса ищет повторяющиеся последовательности обычных токенов и создаёт для них составные токены. Один такой элемент занимает место нескольких, поэтому модель делает меньше последовательных шагов, хранит меньший кеш внимания и вмещает больше исходного текста в прежнее окно контекста.
Составных токенов не было в словаре при предварительном обучении модели. zip2zip добавляет небольшой кодировщик, который собирает их представления из исходных элементов, а затем дообучает систему через LoRA. Базовую модель не приходится готовить с нуля, но простой перенос алгоритма сжатия в LLM заметно ухудшает математические ответы и повышает перплексию — показатель того, насколько неуверенно модель предсказывает продолжение текста.
Первая причина потерь скрыта в устройстве LZW. Его словарь хранит цепочки с общим началом: например, отдельными элементами могут стать последовательности «A B», «A B C» и «A B C D». На выходе модель должна различать их в одной позиции, поэтому ей выгодно особенно сильно учитывать начало. На входе требуется другое представление, которое учитывает весь составной токен равномернее.
Прежняя схема поручала обе задачи одному кодировщику. zip2zip++ разделяет кодировщики входа и выхода, чтобы каждый учил подходящую структуру представлений. Это не косметическое изменение: один набор параметров пытался одновременно поддерживать две несовместимые геометрии.
Качество возвращают четыре изменения
Новый кодировщик начинает не со случайного вектора, а с представления первого обычного токена и учит только поправку к нему. В исходной реализации норма нового вектора могла оказаться примерно в 54 раза выше нормы знакомого модели токена. Начальная настройка через тождественное преобразование убирает этот скачок и сохраняет поведение предварительно обученной модели в начале дообучения.
Второе изменение касается позиций. Обычная схема нумеровала составные токены подряд, словно каждый занимал одно место. Из-за этого объединение нескольких элементов сдвигало координаты всего последующего текста. zip2zip++ ставит составной токен в конечную позицию охваченного им отрезка, а следующие элементы сохраняют координаты исходной последовательности. На GSM8K такая настройка прибавила 2,7 процентного пункта точности без заметного изменения перплексии.
Третье изменение защищает хрупкие элементы от объединения. Особенно сильно качество страдало при сжатии цифр: их защита во время обучения и инференса дала 25,4 процентного пункта на GSM8K относительно варианта без защиты. Операторы и команды LaTeX дали гораздо меньшую добавку, поэтому авторы предлагают исключать из слияния только элементы с измеренным отрицательным эффектом.
Четвёртое изменение делает сам кодек устойчивее. Языковая модель может пропустить ожидаемое объединение, после чего обычный декодер LZW рассинхронизирует словарь и накапливает ошибки. Исправленный декодер проверяет, существует ли комбинация, и добавляет запись только при встрече действительно новой последовательности.
Авторы также меняют оценку перплексии. Один и тот же текст можно собрать из динамических токенов несколькими способами, хотя после распаковки результат будет одинаковым. Вместо проверки единственной канонической разбивки метод суммирует вероятности допустимых вариантов и не считает корректную альтернативную разбивку ошибкой.
Когда адаптивный словарь стоит включить в план
Метод проверяли на четырёх базовых моделях, нескольких корпусах обычного текста и математическом наборе GSM8K. Его сравнивали с прежним zip2zip и с моделью, которую дообучили на несжатых последовательностях. zip2zip++ улучшил перплексию на каждом проверенном корпусе и повысил точность математических ответов, но полностью разрыв с несжатым вариантом не закрыл.
Для существующего продукта это не замена токенизатора одной настройкой. Потребуются отдельные кодировщики составных токенов, продолжение обучения, изменённый LZW-декодер и согласованная логика на стороне генерации. Кроме того, мониторинг качества должен учитывать несколько допустимых разбиений текста, иначе команда будет измерять свойства выбранного кодека, а не вероятность самого ответа.
Подход лучше всего соответствует системам, где входы содержат повторы, специализированные термины или структурированные фрагменты, которые стандартный словарь дробит слишком мелко. Потенциальная выгода состоит в меньшем числе шагов генерации и более ёмком контексте при том же лимите токенов. При этом работу нельзя использовать как готовый расчёт инфраструктуры: она показывает степень сжатия и качество модели, а не фактическую задержку и стоимость сервинга.
Практический план — оставить обычную токенизацию контрольным вариантом, дообучить zip2zip++ на представительном потоке и отдельно проверить числовые ответы, код и форматы с жёстким синтаксисом. Главный вывод работы не в том, что динамические словари уже работают без потерь, а в том, что значительная часть потерь вызвана исправимыми решениями в представлениях, позициях, кодеке и оценке.
Источники
Иллюстрация: рисунок из статьи «zip2zip++: Towards Inference-Time Token Compression with Minimal Quality Loss», Saibo Geng, Andrea Gentilini, Xinxian Ma и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


