Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Разбиение управления роботом на пакеты действий не заставляет небольшую ошибку затухать автоматически. В препринте, который не проходил рецензирование и приводит замеры самого автора, на 12 задачах усиление ошибки встречалось часто, а уверенное затухание — редко. Поэтому нельзя считать редкое перепланирование безопасным лишь потому, что управляющая модель обучена копировать демонстрации.
Как измеряли судьбу одной ошибки
Пакетное выполнение действий (action chunking) устроено так: модель сразу предсказывает последовательность команд, робот исполняет её часть без новых наблюдений, а затем строит следующий пакет. Такой подход часто работает лучше, чем предсказание одной команды за раз, но причины выигрыша остаются спорными.
Работа независимого исследователя Aryan Goyal проверяет одно из объяснений: пакет якобы не даёт ошибкам быстро накапливаться. Вместо итогового успеха задания автор измерял, что происходит с небольшим отклонением сразу после его появления.
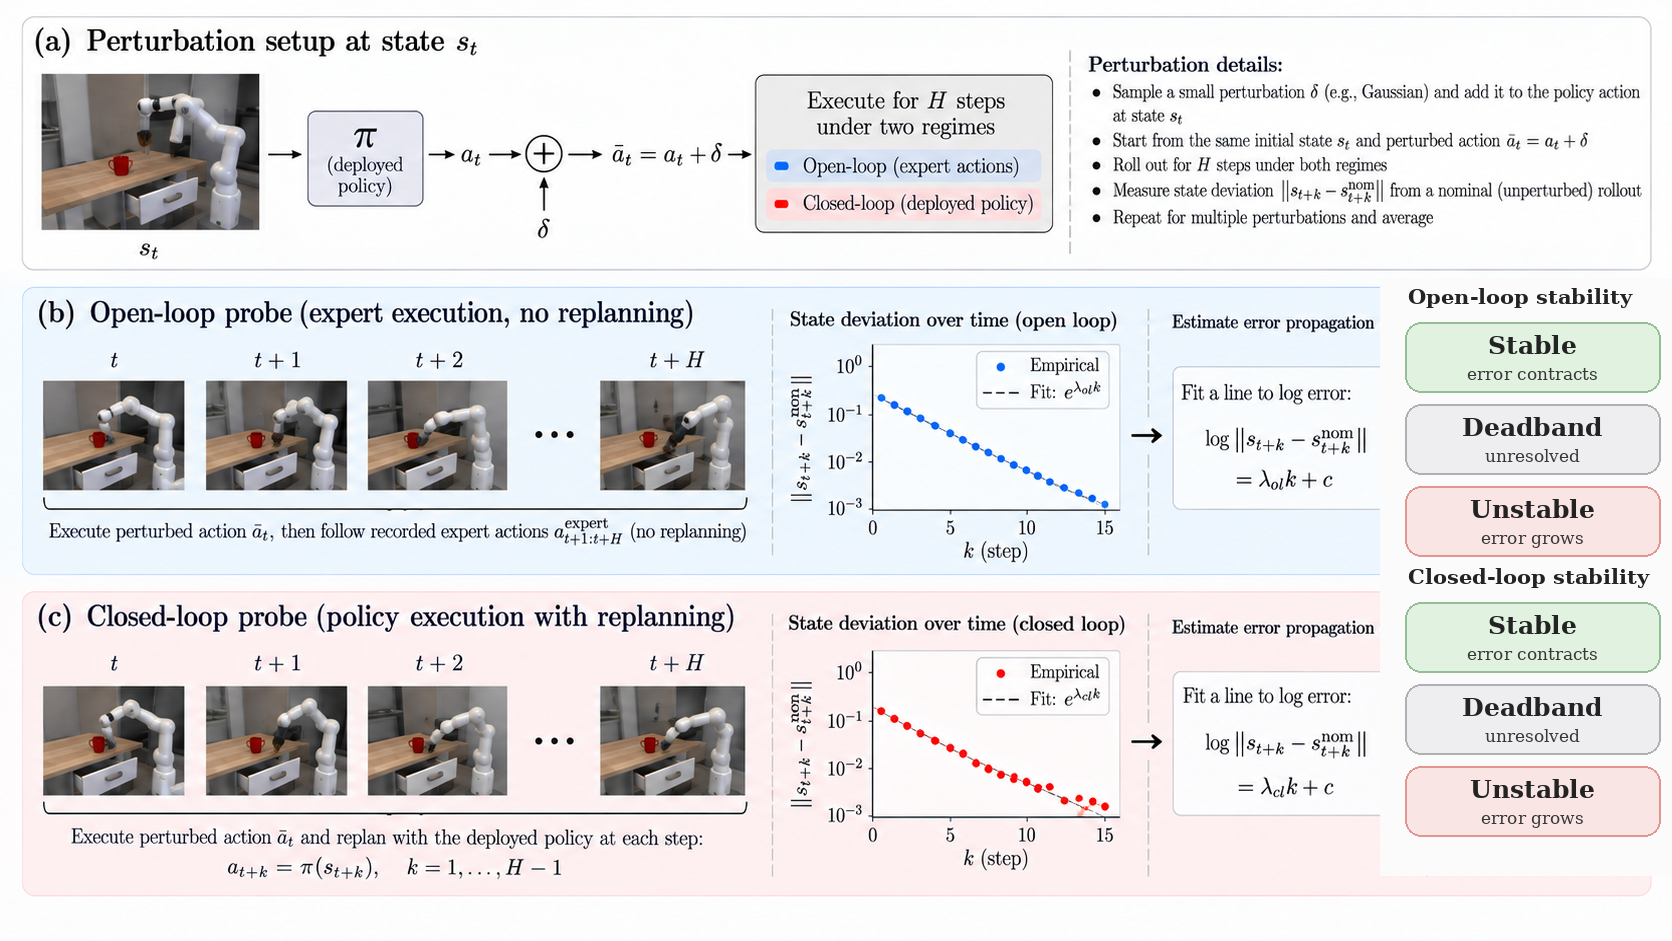
В выбранном состоянии к поступательному движению манипулятора добавляли шум. Его величину подбирали по типичной ошибке обученной модели на отложенных демонстрациях. Затем сравнивали исходную и изменённую траектории и оценивали, растёт ли расстояние между ними, сокращается или остаётся слишком малым для уверенного вывода.
Первый режим отделял свойства робота и среды от поведения модели. После возмущения система исполняла остаток записанного пакета без перепланирования. Если расхождение увеличивалось, состояние считали усиливающим ошибку; если уменьшалось — устойчивым.
Во втором режиме модель после возмущения строила команду заново на каждом шаге. Для исходной и изменённой ветвей использовали одинаковые случайные выборки, чтобы не спутать реакцию на ошибку со случайностью самой модели. Это позволяло проверить не абстрактную устойчивость управления, а способность конкретной обученной модели вернуть робот к исходной траектории.
Перепланирование останавливает рост, но редко исправляет отклонение
Проверка охватила 12 задач из трёх наборов — robomimic, MimicGen и RoboCasa — и две разновидности управляющих моделей. Замеры проводили на состояниях из демонстраций, на состояниях, куда приходила сама модель, и на границах перепланирования её пакетов. Это симуляционные задачи манипулирования с человеческими и сгенерированными демонстрациями, а не испытания на физических роботах.
Уверенно устойчивые состояния встречались редко. Среди состояний, где направление изменения удалось определить, ошибка чаще усиливалась. Это противоречит удобной картине, в которой механика задачи сама поглощает небольшое отклонение до следующего обращения к модели.
Перепланирование часто убирало уверенное усиление, но обычно переводило результат в неопределённую область, а не в уверенное затухание. Иными словами, обратная связь могла остановить явно плохой сценарий, однако редко показывала, что модель действительно возвращает систему к прежней траектории.
Оценка зависела и от длины наблюдаемого отрезка. Сильнее всего ошибка росла сразу после возмущения, а затем могла упереться в геометрию задачи или перестать увеличиваться прежним темпом. Поэтому короткое окно завышало долгосрочную скорость усиления, а единый коэффициент устойчивости плохо описывал даже разные состояния одной задачи.
Автор также обучил отдельный предсказатель на кадрах камер и данных о положении робота. Для режима без перепланирования его AUROC составлял от 0,63 до 0,94: наблюдаемая сцена действительно содержит признаки будущего усиления ошибки. Точную скорость роста он восстанавливал хуже, а реакцию системы с перепланированием предсказывал менее стабильно, поскольку она зависит не только от состояния, но и от последующих решений модели.
Длину пакета придётся проверять вместе со способностью восстанавливаться
Работа не даёт основания отказаться от пакетов действий. Она не определяет лучшую длину пакета и не сводит итоговый успех задания к одному показателю устойчивости. На результат также влияют качество команд, согласованность последовательности и стоимость частого перепланирования.
Меняется другое: затухание ошибок нельзя использовать как исходное допущение при выборе архитектуры. Если модель обучалась только повторять действия эксперта в правильных состояниях, она почти не видела ситуаций после собственного отклонения. Способность эксперта исправить ошибку при этом не переходит к модели автоматически.
Для команды, которая строит такое управление, практический тест должен включать возмущения в состояниях, куда приходит сама модель. Нужно отдельно сравнивать продолжение пакета и немедленное перепланирование: первая проверка показывает свойства динамики, вторая — реальную способность модели восстановиться.
Если восстановление критично, его следует включать в обучение. В работе предлагается показывать модели возмущённые состояния и траектории возврата, а также шире покрывать дерево возможных отклонений. Тогда реакция на ошибку становится учебной целью, а не ожидаемым побочным эффектом имитации.
Предсказание режима по камерам может со временем поддержать переменную длину пакета: там, где среда усиливает ошибку, обращаться к модели раньше. Но измерения показывают, что одного такого переключателя недостаточно. Если сама модель не обучена возвращаться после отклонения, более частое перепланирование лишь меняет источник усиления.
Источники
Иллюстрация: рисунок из статьи «Measuring the Stability Assumption Behind Action Chunking», Aryan Goyal, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.