Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Безопасную часть офлайн-датасета научились выделять, даже когда для каждого шага нельзя задать численную стоимость нарушения. Нерецензированный препринт Adam Haroon и Cody Fleming из Iowa State University приводит числа из замеров самих авторов: обученные политики уложились в бюджет стоимости на 11 из 15 задач. Метод заменяет полную разметку переходов сравнениями коротких фрагментов и проверкой 200 эпизодов, но гарантирует состав обучающей выборки, а не безопасность готовой политики.
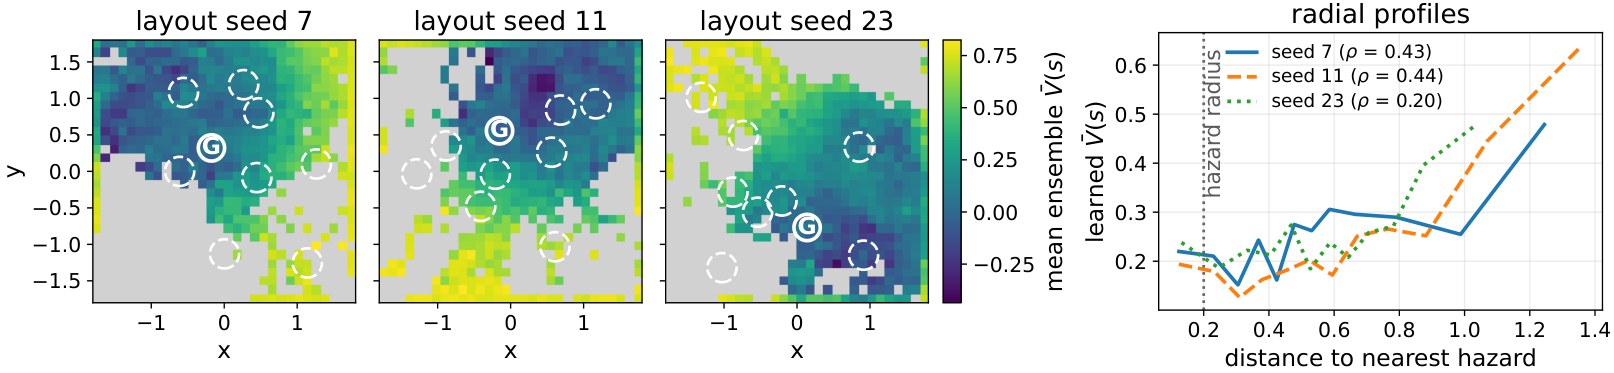
Сначала сеть, которая видит только состояния, учат выбирать более безопасный из двух фрагментов. Затем она оценивает полные траектории, усредняя значения по всем состояниям эпизода. Порог оставляет лучшие траектории, после чего политика учится повторять записанные в них действия.
Порог калибруют по 200 случайно выбранным эпизодам: для каждого достаточно одного ответа — превысил он бюджет или нет. При допустимой доле опасных траекторий 25% риск выдать сертификат выборке с большей долей не превышает 10%, причём гарантия не требует предположений о распределении данных. Если подтвердить порог нельзя, процедура отказывается от сертификата и возвращает консервативную выборку с явной пометкой.
Сертифицированный вариант прошёл на одну задачу меньше, чем BC-Safe, которому нужна метка безопасности для каждой траектории. Несертифицированный вариант вернул эту задачу, поэтому в данном эксперименте статистическая гарантия стоила одного успешного результата.
Основную проверку провели на DSRL: набор охватывал задачи движения с ограничением скорости и навигацию для роботов Point и Car. Метки и сравнения строили из точной функции стоимости самого бенчмарка. Эксперимент поэтому проверяет отбор и калибровку, но не показывает, как метод перенесёт ошибки человека при оценке фрагментов и эпизодов.
Источники
Иллюстрация: рисунок из статьи «Certified Safety Curation: Distribution-Free Guarantees for Safe Offline Reinforcement Learning», Adam Haroon, Cody Fleming, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.