Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
GPT-5 почти не справился с задачами, где нужно пройти длинный профессиональный регламент и выдать точный итог. В работе Manulife, которая не прошла рецензирование и содержит замеры самих авторов, лучший результат составил 1% для медицинского кодирования и 15,5% для расчёта уровня федерального наказания в США. Высокая оценка на коротком тесте рассуждений поэтому не подтверждает, что модель сможет вести производственный процесс без отдельного контроля правил и промежуточных решений.
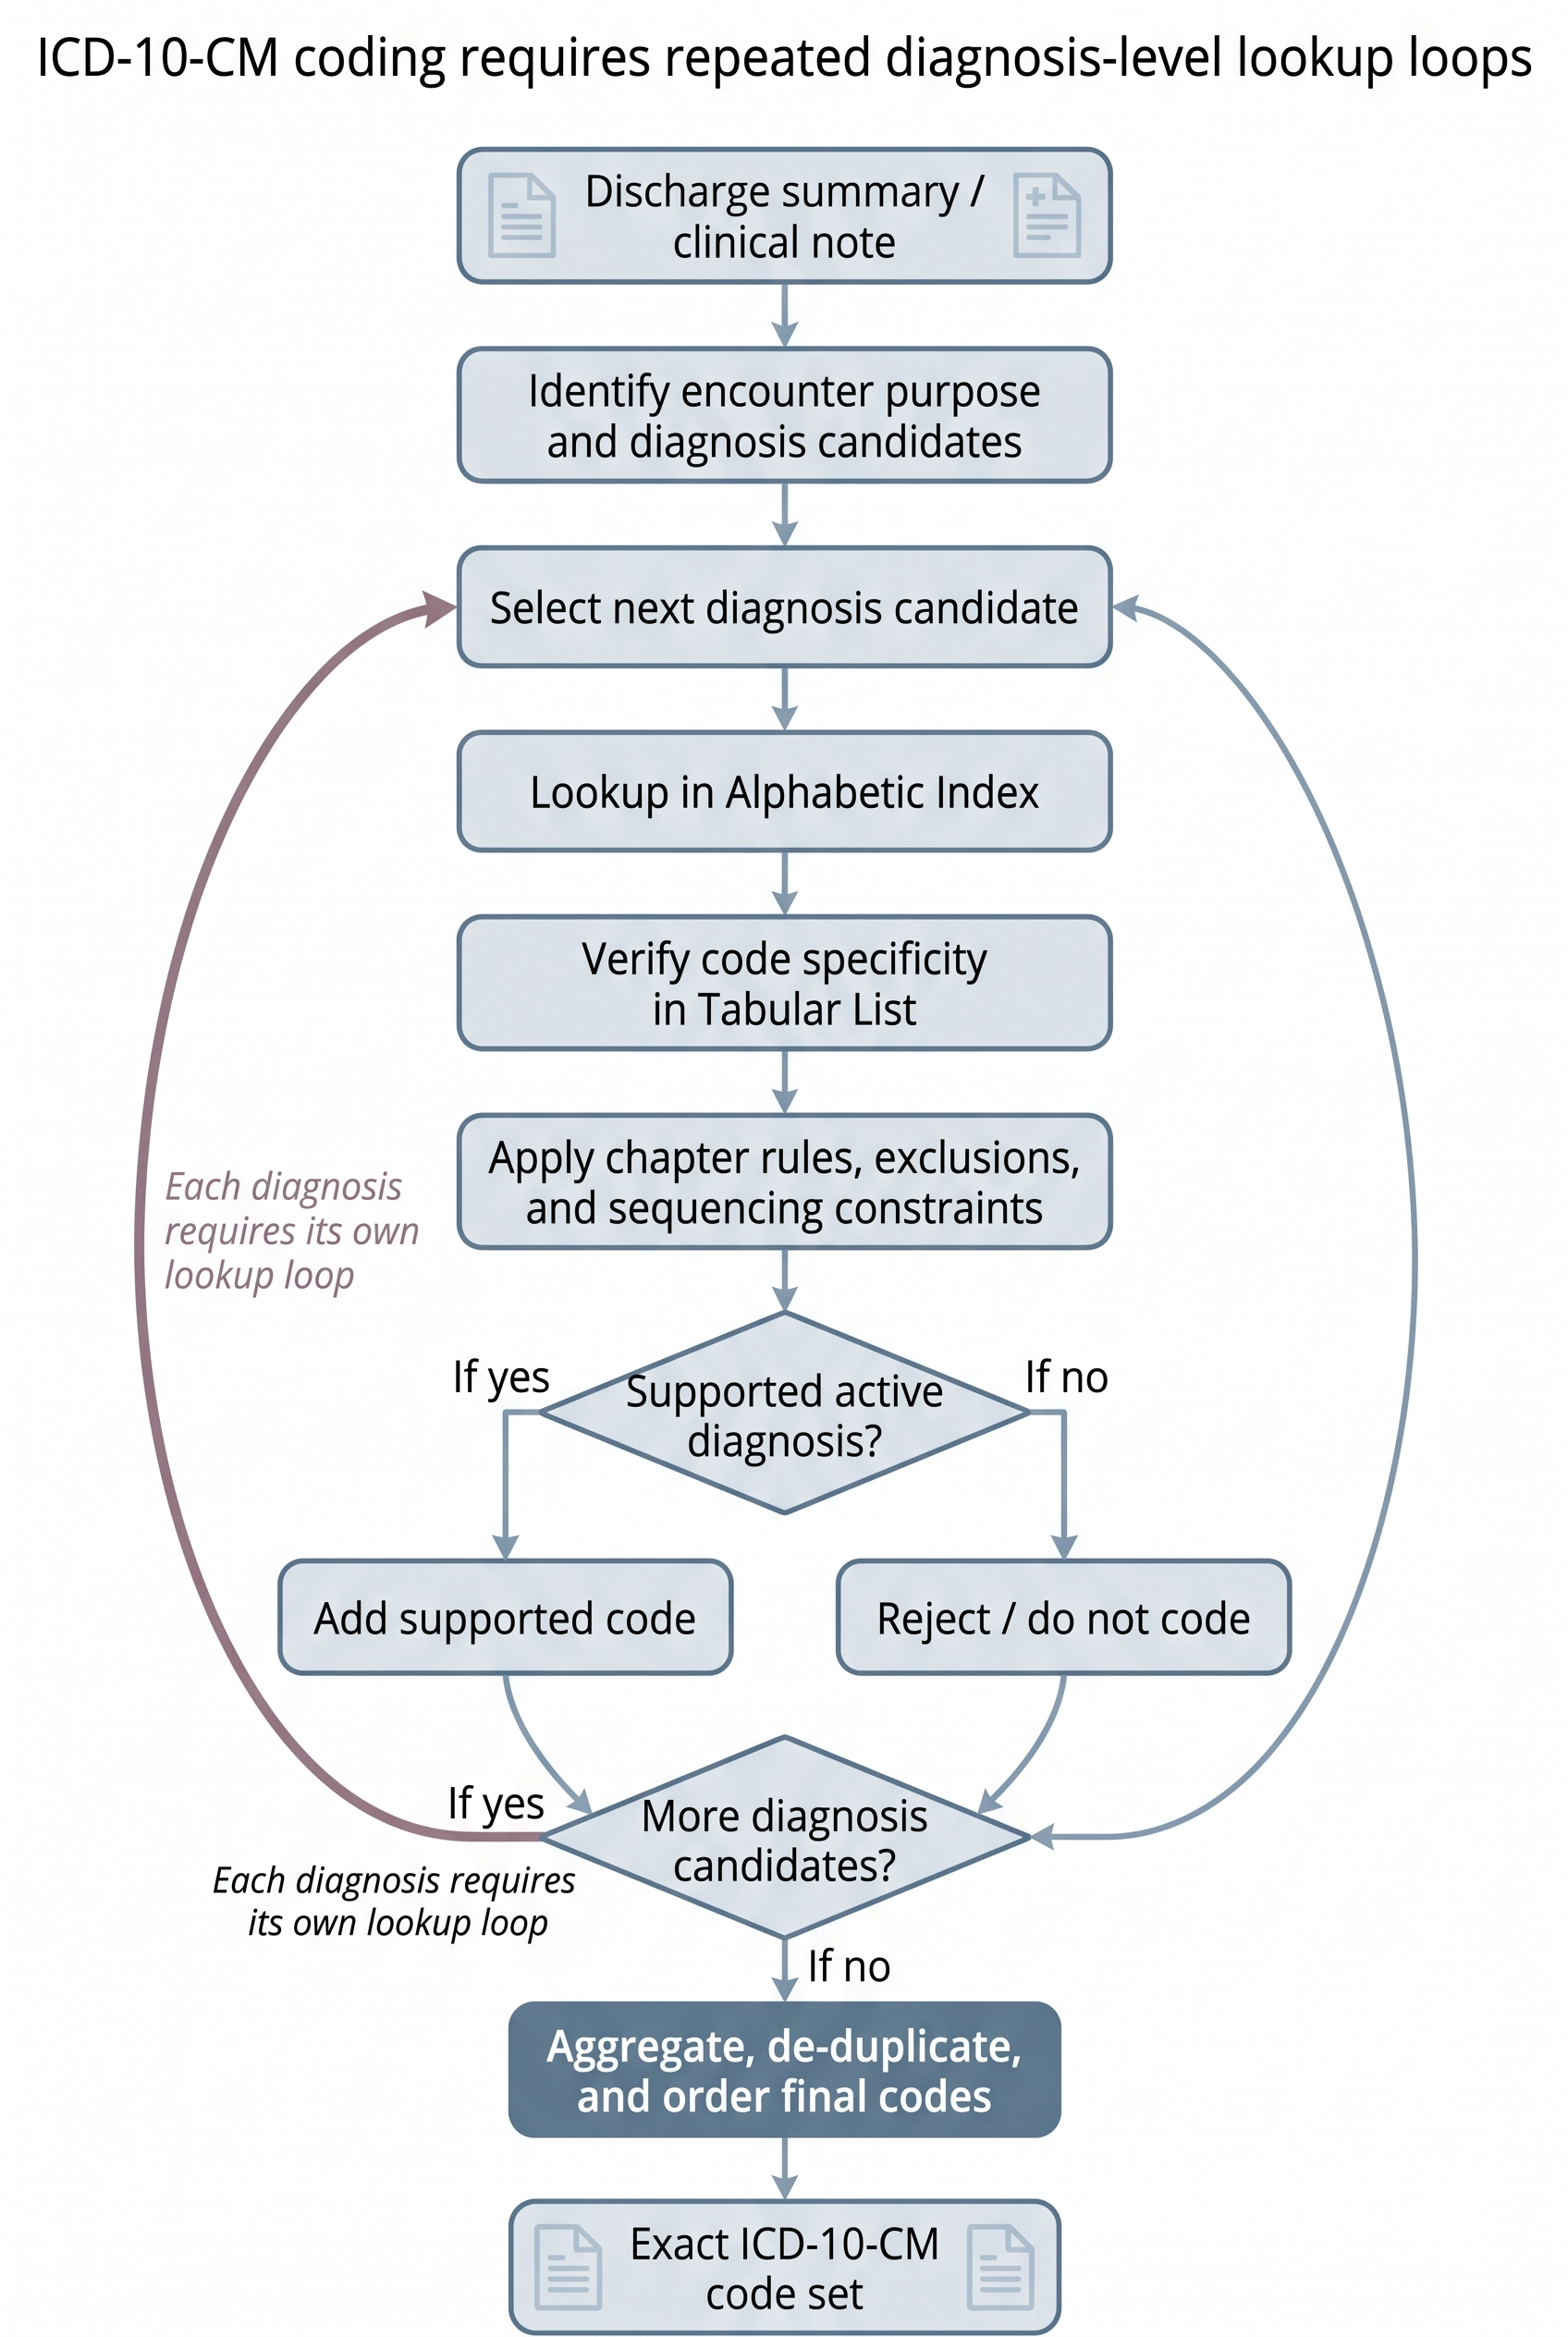
Новый бенчмарк TAM проверяет не отдельный поиск факта, а выполнение всей процедуры. Модель должна переходить между разделами руководства, учитывать исключения, возвращаться к ранним решениям и собирать точный ответ; любое лишнее или пропущенное значение делает результат неверным.
GPT-5 получал доступ к одним и тем же руководствам четырьмя способами: через однократный поиск с генерацией ответа, итеративный агентный поиск, ReAct с инструментами и агентную систему, которая распределяла этапы между отдельными исполнителями. Разбиение работы не решило проблему: на медицинских случаях точное совпадение осталось не выше 1%.
Модель часто находила подходящие правила, но не удерживала согласованность всей цепочки. В 38 из 50 изученных ошибочных траекторий ReAct первое заметное отклонение вело к глобально неверному решению: система рано выбирала не ту ветку руководства, а затем последовательно и правдоподобно продолжала ошибочный расчёт.
Проверка охватывает две области с формализованным результатом: 1 000 случаев кодирования по ICD-10-CM и 200 задач по федеральным правилам назначения наказаний. Сравнивали только GPT-5 и способы работы с подсказками, поиском и инструментами, а не обученные под конкретную область системы. Для продуктовой архитектуры результат очерчивает границу RAG: доступ к регламенту ещё не превращает LLM в надёжного исполнителя, поэтому состояние процесса, обязательные проверки и возврат к ранним шагам придётся задавать отдельно.
Источники
Иллюстрация: рисунок из статьи «Tasks over Application Manuals: Revealing Gaps in Long-Horizon Procedural Reasoning for Language Models», Utkarsh Soni, Syed Shariyar Murtaza, Yifan Nie и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.