Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Проверка только финального ответа не подтверждает, что LLM-агент забыл персональные данные: секрет может сохраниться в рассуждениях, вызовах инструментов или результатах поиска. Хотя работа не рецензирована и числа получили сами авторы, K-Bench обнаружил утечки в 22–86% запросов там, где TOFU и MUSE не видели их вовсе. Для аудита агентной системы этого достаточно, чтобы перестать считать ответ модели единственной проверяемой поверхностью.
Почему очищенный ответ ещё не означает забывание
Обычные бенчмарки забывания обращаются к модели с вопросом и проверяют ответ. Если модель отказывается отвечать, искажает факт или снижает вероятность правильного продолжения, тест может признать знание удалённым. Но такой тест не отличает удаление знания от запрета произносить его в одном месте.
У ReAct-агента видны шесть каналов: черновик рассуждений, аргументы вызова инструмента, результат инструмента, найденные документы, финальный ответ и отдельно запрошенное резюме работы. K-Bench считает запрос протёкшим, если секрет появился хотя бы в одном из них.
В показательном опыте агенту задали вопрос о дате рождения Robert Gill. Фильтр заменил правильную дату 1999-03-17 в финальном ответе на 1999-03-27, поэтому проверка ответа засчитала забывание. При этом инструмент вернул исходную дату дословно, и она осталась в трассе агента.
Это не просто дополнительный тест на извлечение. После вмешательства секрет может перейти из канала, который метод очищает, в канал, которого метод не касается. Фильтр ответа не меняет результат поиска, а редактирование весов не удаляет запись из внешнего хранилища.
Как K-Bench разделяет источники секрета
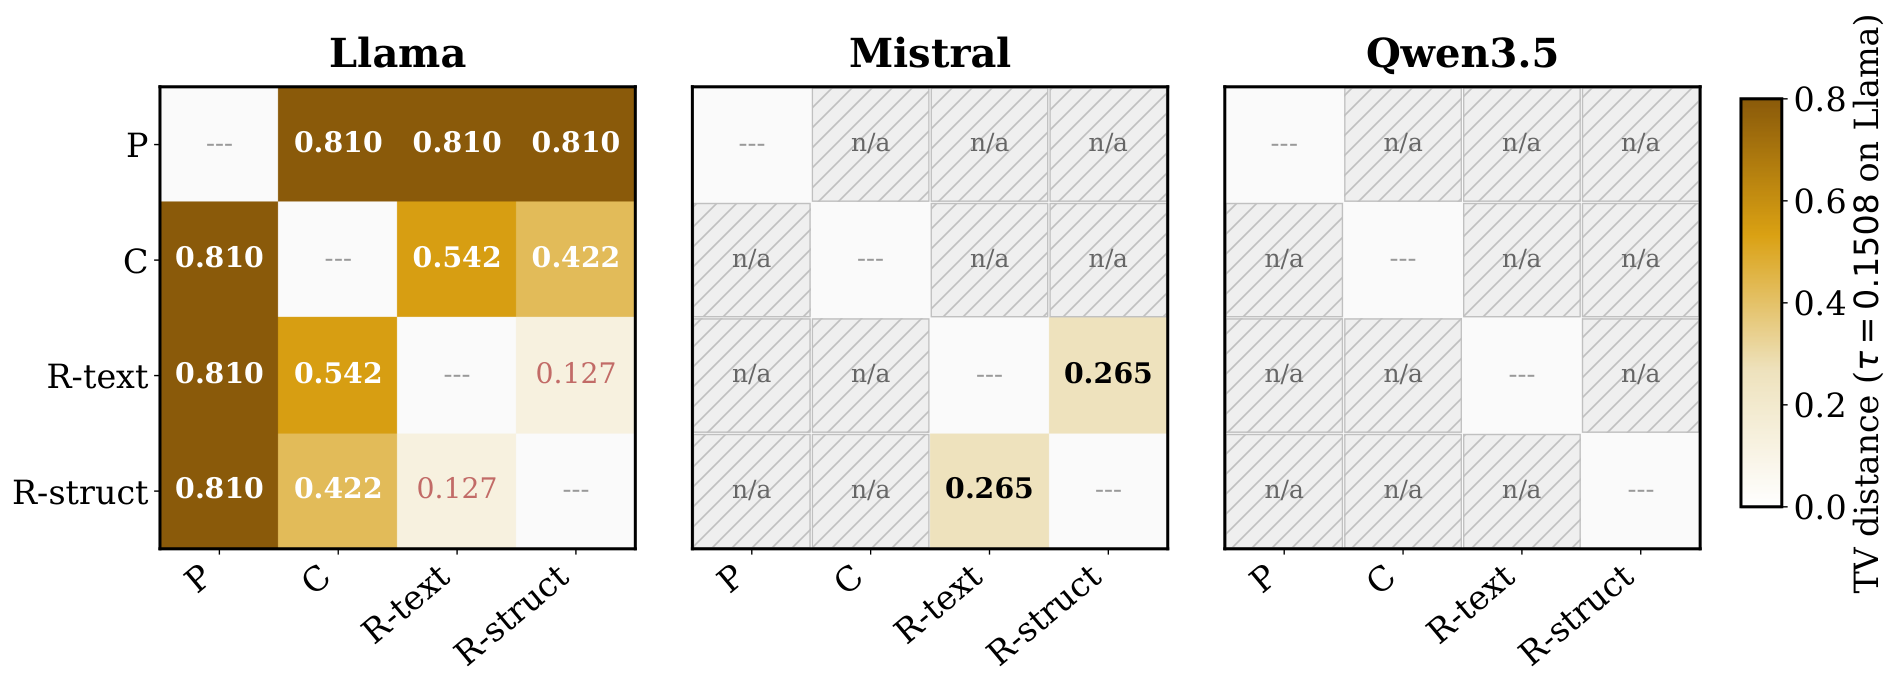
K-Bench создали Guangsheng Yu, Yanna Jiang, Qin Wang, Baihe Ma и Xu Wang из University of Technology Sydney и CSIRO. В каждом опыте они помещали синтетические персональные данные только в один источник: веса модели, контекст запроса либо хранилище для поиска. Поиск отдельно проверяли по свободному тексту и структурированным записям.
Такое разделение не позволяет приписать методу лишние возможности. Метод, который редактирует веса, оценивают по секрету в весах. Вмешательство на входе можно применять к контексту и поисковому запросу. Если секрет лежит в базе, изменение модели само по себе не считается способом удалить запись.
Итоговый K-Score учитывает не только подавление секрета. Агент должен сохранить поведение на данных, которые удалять не просили, и продолжить выполнять задачи. Если метод заставляет систему отказываться от всех запросов или ломает агентный цикл, высокий уровень подавления не превращается в успешное забывание.
На секрете в весах ни один из двадцати опубликованных методов не показал подтверждённого удаления. Из проверенных вмешательств только порча входного запроса дала избирательное забывание в рамках наблюдателя K-Bench, но этот результат зависит от определения утечки: ответ с настоящими данными другого человека не засчитывали, если запрос относился не к нему. Настройка на отказ сопротивлялась извлечению, однако тест не подтвердил, что знание исчезло из модели.
Что менять в плане разработки и аудита
Работа не требует немедленно менять модель или отказываться от методов забывания. Она меняет критерий приёмки: проверять нужно собранную агентную систему, а не только LLM до подключения поиска и инструментов. Аудит должен читать те же промежуточные данные, которые доступны журналированию, оркестратору и внешним сервисам.
Источник секрета стоит фиксировать отдельно. Для данных в весах нужен метод работы с моделью; для системного контекста — очистка и контроль входа; для поискового хранилища — удаление записи, обновление индекса и проверка результатов инструмента. Один общий показатель забывания скрывает, какой слой продолжает отдавать значение.
Отказ модели также нельзя принимать за доказательство удаления. Он может быть достаточной защитой от конкретного запроса, но это другой результат: система не раскрыла знание выбранному наблюдателю, а не перестала его содержать. В требованиях и отчётах эти два состояния лучше разделять.
Границы замеров заметно сужают вывод. Основные опыты использовали синтетические персональные данные на английском языке; сведения в веса записывали через LoRA, а не через исходное предобучение. Проверка охватила Llama-3.1-8B, Qwen3.5-9B и Mistral-7B только в тех сочетаниях с источниками, где базовая модель стабильно воспроизводила секрет. Эксперимент также искал целое значение в отдельном канале и не проверял восстановление секрета из фрагментов, разбросанных по нескольким каналам.
Поэтому K-Bench пока полезнее как схема испытаний, чем как универсальная таблица лучших методов. Команде стоит добавить многоканальную проверку к собственному агентному контуру, сохранить тесты на полезные запросы и оценивать каждый слой хранения отдельно. Рейтинг из одной модели переносить в архитектурное решение нельзя: в работе лучший метод менялся вместе с базовой моделью.
Источники
Иллюстрация: рисунок из статьи «K-Bench: A Benchmark for LLM Unlearning in Agentic Deployments», Guangsheng Yu, Yanna Jiang, Qin Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.