Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
У базовой языковой модели научились находить правильные цепочки рассуждений, которые обычная генерация пропускает из-за их низкой вероятности. В препринте Zhendong Mi и Shaoyi Huang из Stevens Institute of Technology, который не прошёл рецензирование и содержит замеры самих авторов, метод показал на GPQA точность 45,6% против 39,9% у GRPO. Для продукта это открывает промежуточный вариант между обычным вызовом модели и её дообучением с подкреплением.
Вероятный следующий шаг не гарантирует правильного ответа
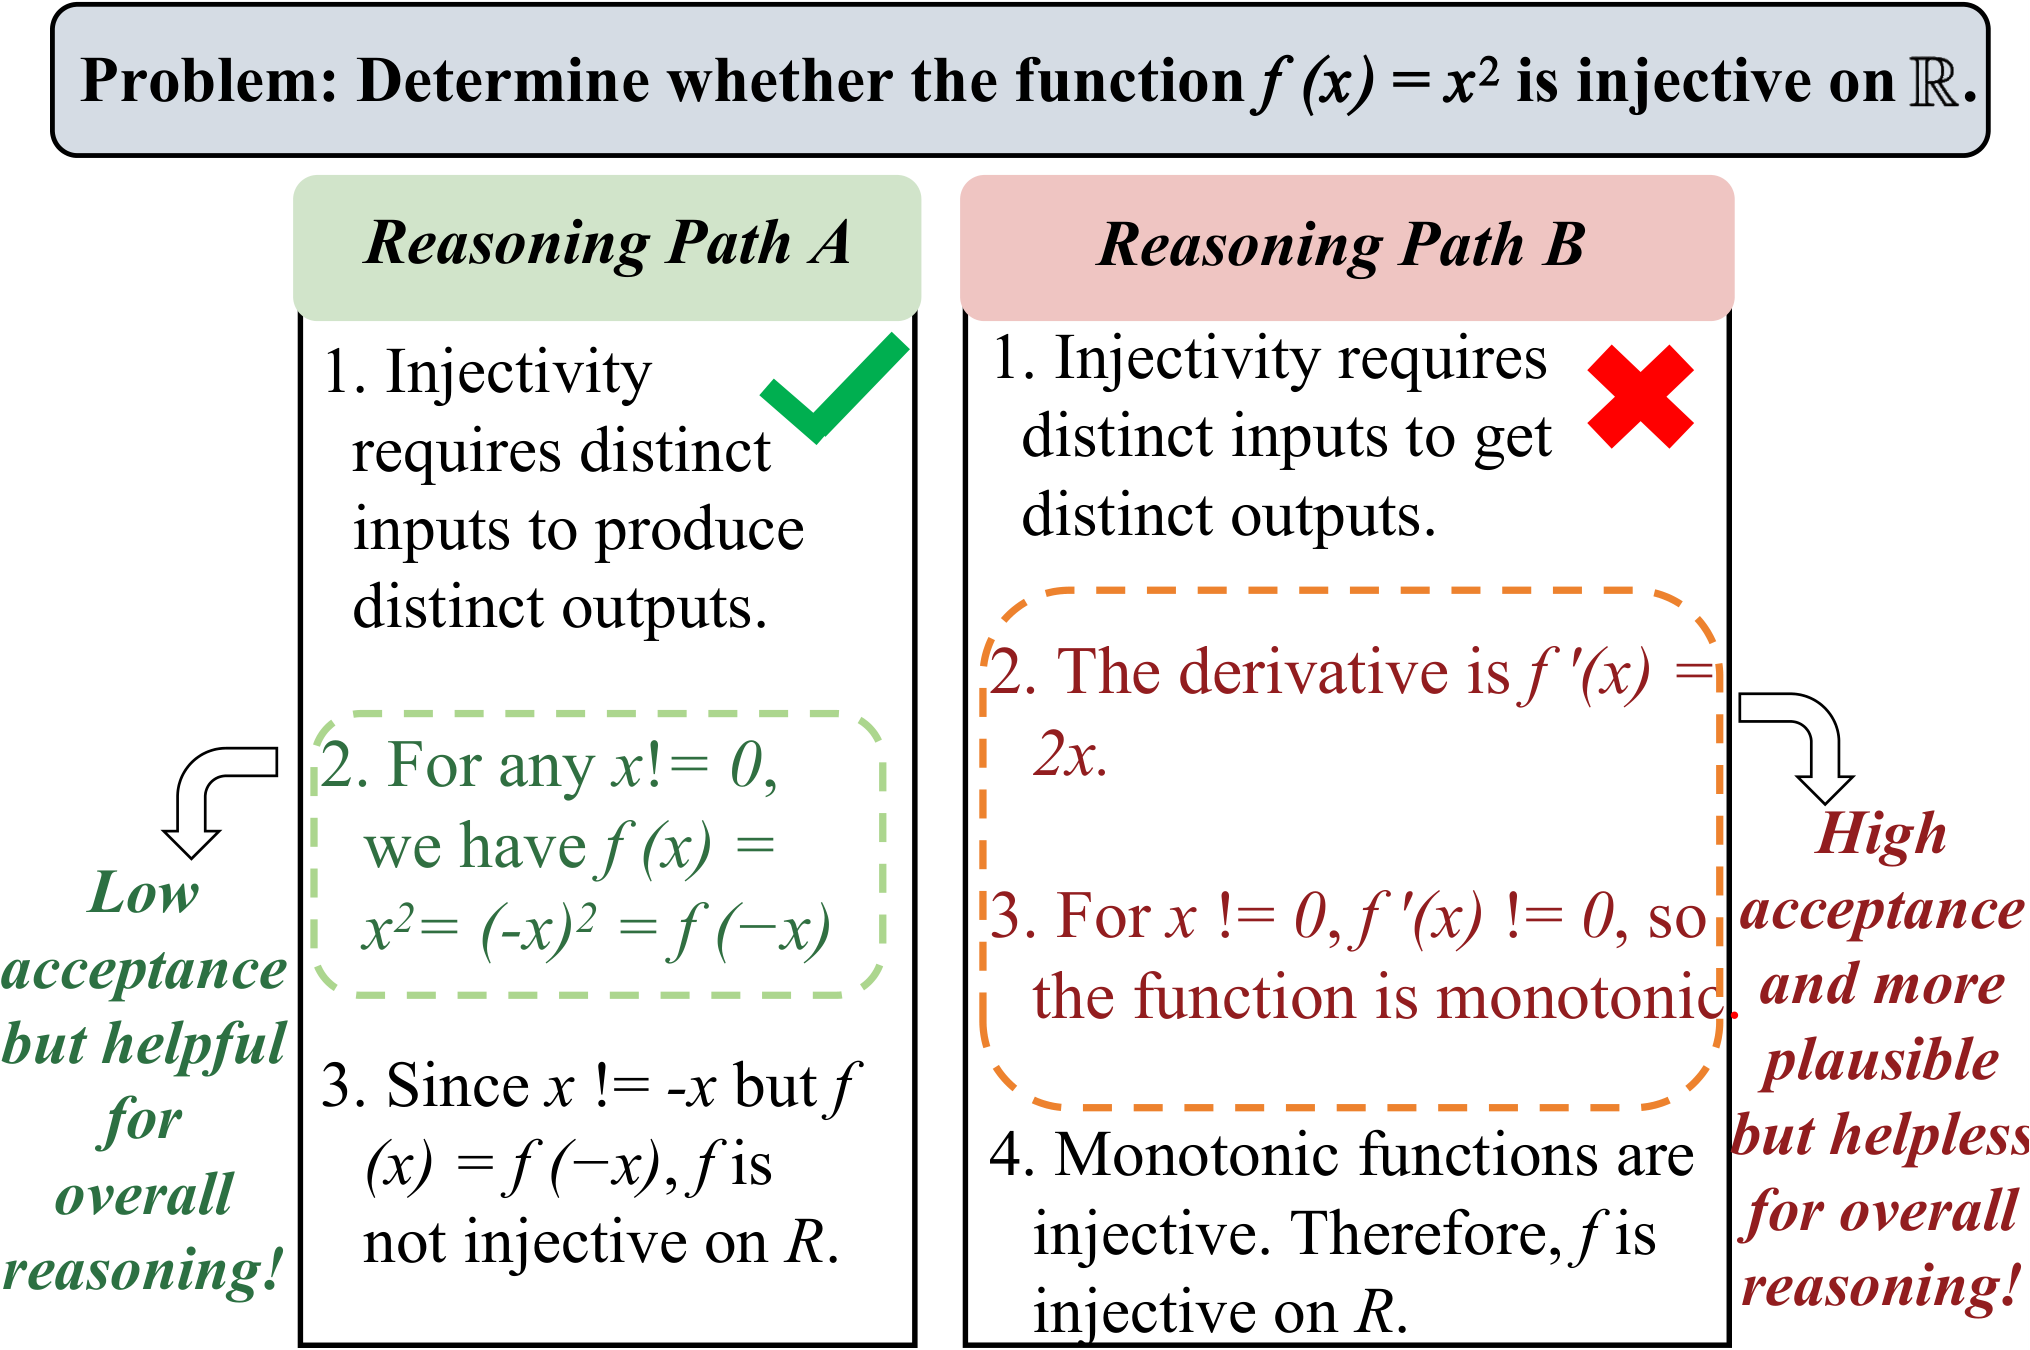
Языковая модель выбирает продолжение по локальной вероятности: каждый новый фрагмент должен хорошо сочетаться с уже написанным. Такой способ работает для текста, но может ошибаться в длинной задаче, где правдоподобный промежуточный шаг ведёт к неверному выводу.
В статье это показано на простом уравнении. Модель может разделить обе части на переменную, неявно исключить её нулевое значение и потерять один из корней. Этот ход привычен и короток, поэтому получает высокую вероятность, хотя альтернативная цепочка приводит к полному решению.
DF-Sample исходит из того, что правильная цепочка уже доступна базовой модели, но находится в менее вероятной части распределения ответов. Обучение с подкреплением повышает вероятность удачных цепочек через обновление параметров. Новый метод оставляет параметры неизменными и ищет подходящую цепочку во время ответа.
Это не доказывает, что обучение с подкреплением никогда не добавляет модели новых навыков. Работа проверяет более узкое предположение: часть улучшений можно получить, если лучше исследовать уже существующие варианты рассуждения.
Как дерево оценивает путь целиком
DF-Sample разбивает рассуждение на шаги и для каждого шага генерирует несколько продолжений. Так возникает дерево: узел хранит фрагмент рассуждения и вероятность, которую присвоила ему исходная модель. Выбор не делают сразу, поэтому локально слабая ветка остаётся доступной до оценки её результата.
После построения дерева метод оценивает конечные узлы. Оценка сочетает вероятность последнего фрагмента с показателем качества ответа; в экспериментах качество определял GPT-4o. Авторы используют последний шаг как приближение для качества всей цепочки, поскольку там обычно содержатся итог и краткое обоснование.
Затем оценки распространяются от листьев к корню. Промежуточный узел получает высокий вес, если из него часто выходят качественные завершения, даже когда сам переход казался модели необычным. Финальный путь выбирают по сочетанию исходной вероятности и ожидаемого качества доступных продолжений.
Для длинных рассуждений дерево строят блоками. Метод выбирает частичный путь, добавляет его к контексту и разворачивает следующий блок. Это ограничивает рост дерева, но ранний выбор уже нельзя пересмотреть после перехода к следующему блоку.
На MATH500 с Qwen2.5-Math-7B метод достиг точности 81,8% против 78,5% у GRPO. Преимущество оказалось не универсальным: на HumanEval с Phi-3.5-mini-instruct DF-Sample получил 66,5%, тогда как Power Sampling — 73,2%. Один вопрос MATH500 в измеренном режиме занимал около 384 секунд, поэтому выигрыш в качестве оплачивался продолжительным поиском при выводе.
Метод проверяли на Qwen2.5-Math-7B, Qwen2.5-7B и Phi-3.5-mini-instruct. Набор задач охватывал математику MATH500, программирование HumanEval, научные вопросы GPQA-Diamond и выполнение открытых инструкций AlpacaEval 2.0; эксперименты запускали на NVIDIA A6000, а результаты методов сравнения брали из соответствующих работ.
Когда поиск вместо дообучения меняет план
DF-Sample имеет смысл рассматривать, если команде нужно повысить качество сложных ответов, но она не хочет собирать тренировочный набор и обновлять параметры модели. Метод можно добавить поверх базовой модели как отдельный слой вывода: он управляет генерацией кандидатов, вызывает оценщик и возвращает выбранную цепочку.
Экономия на обучении не означает экономии на эксплуатации. Для каждого запроса нужно построить несколько вариантов рассуждения, оценить их и провести обратный расчёт по дереву. При большом потоке запросов эта работа повторяется постоянно, тогда как дообученная модель переносит часть затрат в подготовительный этап и затем отвечает обычным способом.
Практический выбор зависит от профиля нагрузки. Для редких, дорогих ошибок — научного анализа, сложной математики или генерации кода с проверкой — дополнительный поиск можно включать только для трудных запросов. Для интерактивного продукта с жёстким временем ответа описанный режим потребует ограничения дерева, маршрутизации запросов или фонового выполнения.
Отдельная зависимость — модель-оценщик. В работе эту роль выполнял GPT-4o, поэтому система фактически использует вторую модель для выбора ответа первой. Если продукт нельзя отправлять внешнему поставщику или оценивать таким способом, понадобится собственный проверяющий механизм, и результат статьи на него автоматически не переносится.
Работа не даёт основания отменять планы по дообучению там, где модели нужно освоить новые данные, формат или поведение. Она показывает более узкий путь: прежде чем менять параметры, можно проверить, не умеет ли базовая модель уже решать задачу и не мешает ли ей стандартный способ генерации.
Источники
Иллюстрация: рисунок из статьи «Sampling via Decision-Flow: Training-Free Extraction of Improved Latent Reasoning Paths in Large Language Models», Zhendong Mi, Shaoyi Huang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.