Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Попытка стереть влияние отдельных обучающих примеров через изменение изображений не выдержала сравнения с полным переобучением. В препринте команды Monash University и партнёров, который не прошёл рецензирование, а числа в нём получили сами авторы, DPL не прошёл критерий прямого удаления во всех трёх парных запусках. Закладывать этот подход как замену переобучению пока не стоит.
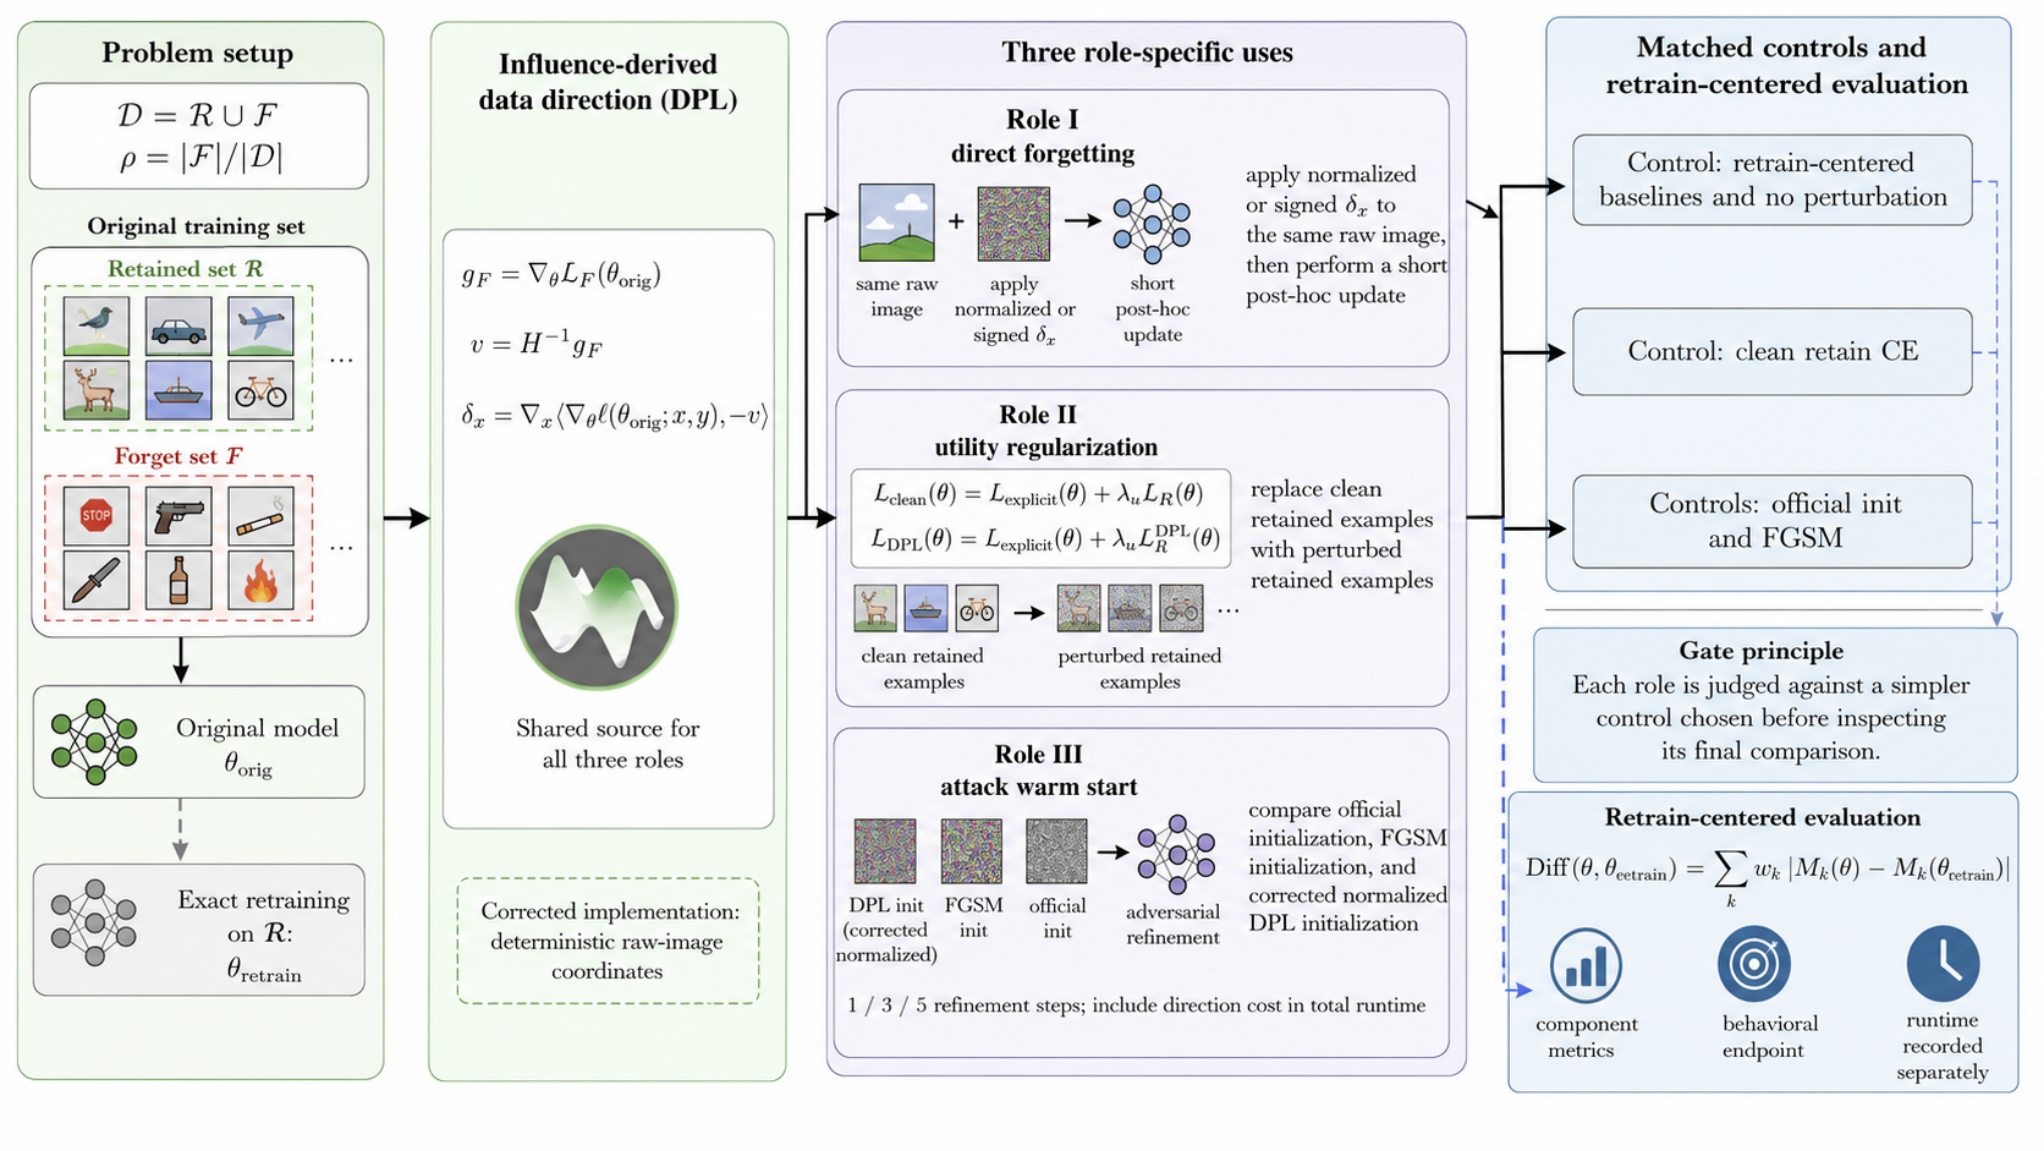
DPL оценивает, как удаление примеров должно изменить параметры модели, и по этому направлению меняет обучающие изображения и метки. Метод проверили в трёх ролях: как самостоятельный механизм машинного забывания — удаления влияния выбранных данных без полного переобучения, как способ сохранить качество при другом механизме забывания и как начальную точку для состязательной атаки.
Аудит реализации нашёл две ошибки. Направления вычислялись на дополненных и нормализованных изображениях, но применялись к исходным; изменение меток было меньше шага представимых значений float32, поэтому метки фактически не менялись. После исправления обработки изображений DPL всё равно оставался дальше от результата полного переобучения, чем SalUn и AMUN.
Добавка для сохранения качества сработала только в одном из трёх запусков и не дала устойчивого преимущества перед обычным обучением на сохранённых данных. Как начальная точка DPL не обошёл одновременно штатный вариант и одношаговый FGSM, если учитывать ещё 47–66 секунд на вычисление направления.
Основной тест провели на CIFAR-10 с ResNet-18 при случайном удалении 10% примеров. Дополнительная проверка на Tiny ImageNet с VGG-19 также не поддержала две вспомогательные роли, а прямое сравнение там оказалось неубедительным из-за разной предварительной обработки. Вывод относится к случайному удалению примеров в классификации изображений.
Работа показывает и правильную схему проверки: сравнивать итоговое поведение с моделью, полностью переобученной на оставшихся данных, подбирать отдельный простой контроль для каждой заявленной роли и учитывать всю вычислительную стоимость. При случайном удалении низкая точность на забытых примерах сама по себе не означает успеха: переобученная модель может по-прежнему распознавать их правильно.
Источники
Иллюстрация: рисунок из статьи «Do Influence-Derived Data Perturbations Enable Machine Unlearning? A Controlled Study of Three Plausible Roles», Chenkai Wu, Chrispine Kambimbi, Qinyang Zeng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.