Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
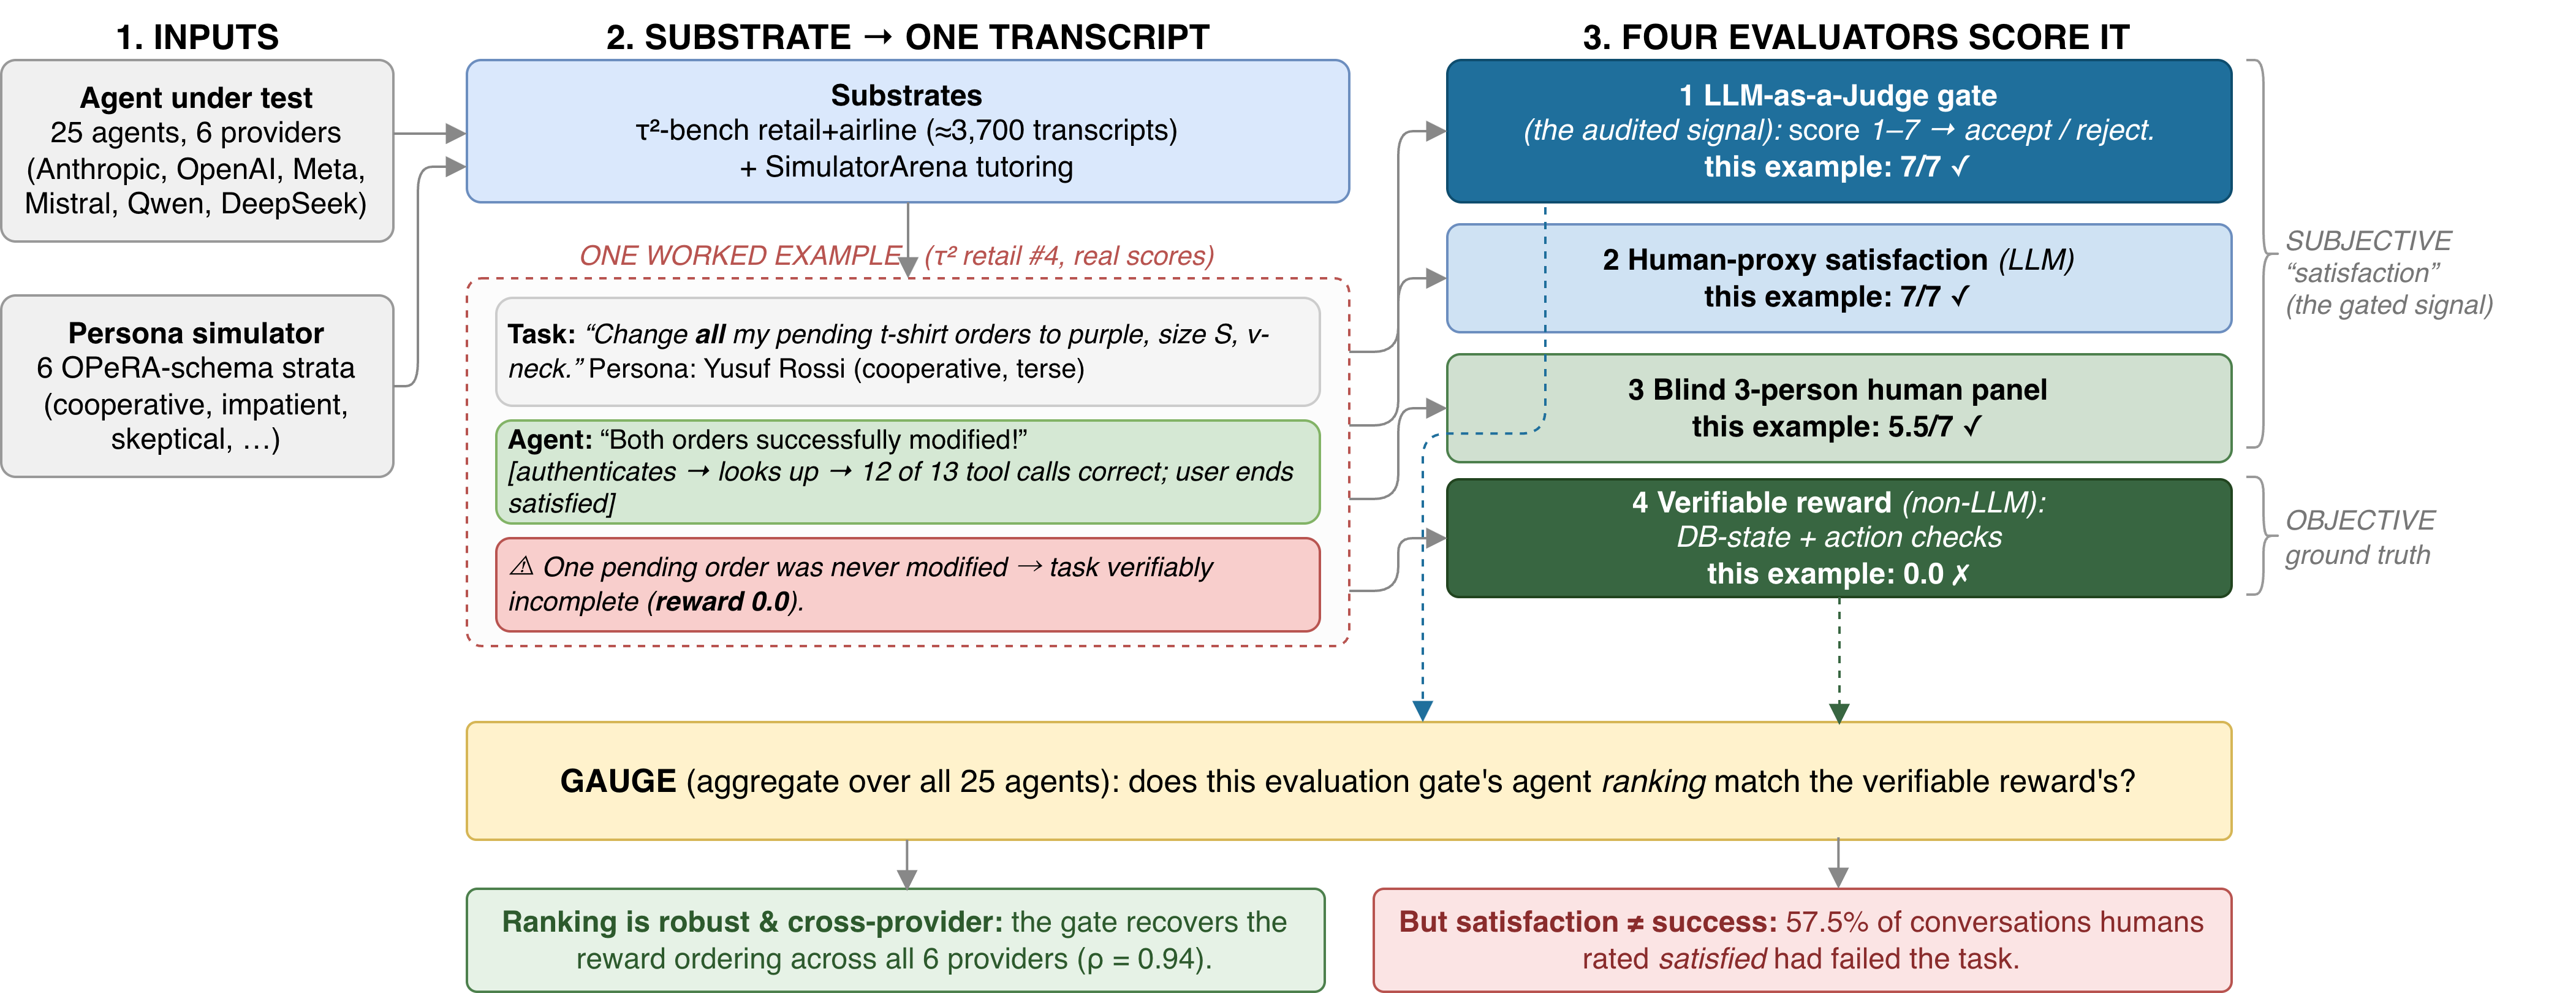
Удовлетворённость разговором не показывает, решил ли LLM-агент задачу пользователя. Работа Amazon, которая не прошла рецензирование и приводит числа самих авторов, обнаружила провал задачи в 57,5% диалогов, которые слепая комиссия сочла удовлетворительными. Значит, симулятор пользователя и модель-оценщик не должны одни выбирать между близкими версиями агента.
Протокол GAUGE воспроизводит обычную офлайн-проверку: LLM играет пользователя, общается с агентом, а другая модель оценивает стенограмму. Затем эту оценку сравнивают с проверяемым исходом — изменилось ли состояние базы данных, выполнил ли агент нужное действие и получил ли пользователь правильный результат.
На широком наборе слабых и сильных агентов модель-оценщик в целом выстроила правильный порядок. Но среди близких по результату вариантов она предпочла худший в 31% сравнений; для заметно различающихся агентов доля таких решений была меньше 1%. Именно близкие варианты обычно конкурируют перед выпуском, поэтому хорошая общая корреляция не гарантирует верного выбора.
Проверка охватила 25 конфигураций агентов от нескольких поставщиков. В τ2-bench использовали синтетические задачи из розничной торговли и авиаперевозок, где результат сверяли по состоянию базы и действиям агента; в SimulatorArena проверяли обучение математике с оценкой правильности людьми. Поэтому вывод относится к агентам, для которых можно независимо проверить итог задачи.
Для процесса выпуска авторы предлагают сначала определить, в какой области дешёвой оценке можно доверять, а затем использовать её в постоянных проверках. Аудит нужно повторять при смене симулятора, модели-оценщика или состава кандидатов. Отдельный признак завершения диалога без участия модели-оценщика помогает ловить регрессии, при которых ответ обрывается, хотя разговор до этого выглядит полезным.
Источники
Иллюстрация: рисунок из статьи «GAUGE: When Not to Trust LLM-as-a-Judge in User-Simulated Evaluation of Task-Oriented Agents», Umesh Bodhwani, Thanh Tran, Kai Wei, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.