Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель мира научили подстраиваться под изменившееся поведение среды во время работы, не получая награду за действия и не переобучая все свои компоненты. В препринте JEPA-TTT, который не прошёл рецензирование и где числа получены самими авторами, после 500 эпизодов ошибка прогноза снизилась в среднем на 83%, а качество планирования выросло на 153% относительно замороженной модели. Подход предлагает вариант для систем, где цель остаётся прежней, но механика среды после запуска меняется.
Модель уточняет динамику по последствиям собственных действий
Модель мира помогает агенту выбирать действия, если умеет предсказывать их последствия. Вместо будущих кадров JEPA прогнозирует скрытые представления наблюдений: визуальный кодировщик переводит изображение в компактное состояние, а отдельный блок рассчитывает, как действие изменит это состояние.
Проблема возникает, когда среда ведёт себя не так, как в обучающих данных. Привод может иначе реагировать на команду, контакт с объектом — давать другое движение, а действие — выполняться с задержкой. Тогда планировщик сравнивает варианты по неверному прогнозу и выбирает последовательность, которая выглядит выгодной только внутри устаревшей модели.
JEPA-TTT обновляет блок прогноза динамики после выполненных действий. Следующее наблюдение проходит через замороженный визуальный кодировщик и становится целевым состоянием: модель сопоставляет его со своим прогнозом и исправляет параметры без внешней разметки.
Визуальный кодировщик и заранее обученный модуль оценки цели остаются неизменными. Поэтому модель не может улучшить результат, переопределив полезное состояние или перестроив пространство признаков: ей приходится точнее предсказывать последствия действий. Во время работы системе не нужны изображение цели и награда из среды.
Планировщик использует алгоритм Cross-Entropy Method. Он перебирает последовательности действий, прокручивает их через текущую модель динамики и ранжирует полученные состояния с помощью замороженного модуля оценки. После выполнения первой части плана агент получает новое наблюдение и строит план заново.
Накопление опыта оказалось важнее обновлений внутри эпизода
Параметры модели, состояние оптимизатора и буфер опыта сохраняются между эпизодами. Это отличает JEPA-TTT от режима, в котором адаптацию каждый раз начинают с исходной модели: в прямом сравнении постоянное накопление улучшило результат при каждом проверенном сдвиге динамики.
Авторы также применили плотное повторное обучение. Система формирует обучающие отрезки со всех допустимых временных позиций, а не только с границ блоков действий, складывает их в растущий буфер и равномерно выбирает оттуда мини-пакеты. Так один и тот же поток взаимодействий покрывает больше временных смещений, а старые переходы не исчезают после очередного эпизода.
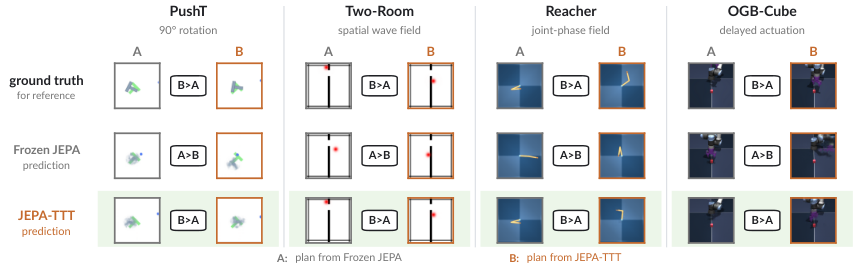
Метод проверяли в PushT, Two-Room, Reacher и OGBench-Cube — средах непрерывного управления с наблюдениями в виде изображений. Для каждой среды задали два сдвига, включая изменения управления, контакта, связи между осями и задержку действий. Задача, пространство действий, способ наблюдения и длительность эпизода при этом не менялись, а новая динамика оставалась постоянной на протяжении развёртывания.
Средняя нормированная площадь под кривой качества планирования составила 0,571 против 0,267 у замороженной JEPA. Эта метрика учитывает не только лучший достигнутый результат, но и весь путь адаптации: высокий итоговый балл не компенсирует слабое поведение в начале.
Улучшение появилось при всех восьми сдвигах. Продолжение того же обучения в среде с неизменной динамикой, напротив, не дало устойчивого выигрыша. Это связывает эффект именно с исправлением рассогласования между обучающей и рабочей средой, а не с дополнительными шагами оптимизации как таковыми.
Что меняется в архитектурных планах
Работа не предлагает заменять заранее обученную модель полностью. Практический вывод уже: если представление наблюдений и функция цели переносятся в рабочую среду, изменяемым компонентом можно сделать только прогноз динамики. Такое разделение уменьшает область онлайн-обновления и не позволяет адаптации незаметно изменить критерий выбора действий.
Для проектирования системы это означает, что буфер переходов, состояние оптимизатора и версия адаптированного блока становятся частью долговременного состояния агента. Сбрасывать их на границе сессии нельзя, если сессии относятся к одному устойчивому режиму среды. Также потребуется собирать последовательные наблюдения и фактически выполненные действия, а не только итоговые оценки.
Подход относится к сценарию одного устойчивого сдвига при неизменных задаче и наблюдениях. Проверка показывает, что адаптация способна приблизить модель к варианту, заново обученному на данных изменившейся среды: при шести сдвигах разрыв по лучшему результату не превышал 0,08. На Reacher остаточный разрыв был больше, поэтому онлайн-исправление прогноза не стоит считать полной заменой переобучению под новую механику.
JEPA-TTT меняет планы команд, которые уже рассматривают модели мира для управления: адаптацию стоит закладывать как отдельный контур вокруг прогноза динамики, а не как дообучение всей модели. Но работа обосновывает это решение только для контролируемых сред с постоянным новым режимом; перенос на меняющуюся во времени динамику требует отдельной проверки.
Источники
Иллюстрация: рисунок из статьи «JEPA-TTT: Persistent Test-Time Training of Latent World Models for Planning under Dynamics Shifts», Zheyuan Zhang, Suyu Ye, Nakul Agarwal и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.