Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Искажения изображения удалось отделить от полезных признаков так, чтобы затем удалить их перед классификацией. В препринте Sakin Kirti и Joel Zylberberg, который не рецензирован и где все числа получили сами авторы, модель с таким разделением обошла обычную L2-регуляризацию при всех проверенных уровнях искажений. Для систем компьютерного зрения это даёт ещё один способ бороться со сдвигом распределения помимо расширения обучающей выборки.
Как регуляризатор разводит сигнал и шум
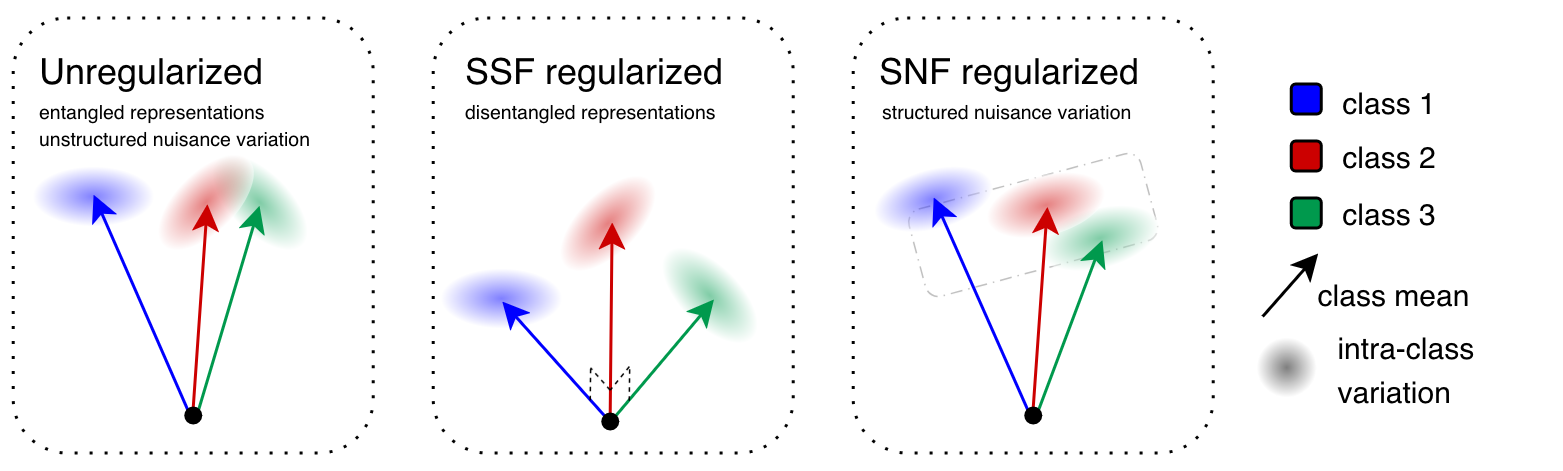
Нейросеть кодирует изображение набором чисел во внутренних слоях. Одни направления в этом пространстве помогают определить класс, другие отражают размытие, изменение контраста и прочие вариации, которые не должны влиять на ответ.
Регуляризатор разделения сигнала и шума штрафует модель, если остаточная вариация попадает в направления, связанные с классом. Его применяют к предпоследнему слою: сеть по-прежнему сама выбирает признаки, но во время обучения получает дополнительное требование — держать помехи в стороне от полезного сигнала.
Для сравнения в работе проверили другой геометрический штраф — разделение сигналов разных классов. Он заставляет направления классов становиться ортогональными и одинаковыми по масштабу. Такая геометрия выглядит упорядоченной, но сама по себе не сделала классификатор устойчивее.
Эксперименты провели на одной архитектуре, ResNet-18, и двух задачах: распознавании объектов CIFAR-100 и классификации клеток BloodMNIST. Модели сравнивали с обучением без регуляризации и с обычным L2-штрафом на веса. Для BloodMNIST использовали 11 видов искажений MedMNIST-C с пятью уровнями тяжести.
После обучения исследователи вычитали представление чистого изображения из представления его искажённой версии. Сингулярное разложение находило направления, вдоль которых искажение сильнее всего меняло внутреннее представление. Эти направления оценивали на отложенной валидационной части, удаляли из тестовых представлений и только затем передавали данные в замороженный линейный классификатор.
Удаление десяти направлений вернуло часть точности
На CIFAR-100 разделение сигнала и шума дало небольшую прибавку на обычной тестовой выборке. Разница стала заметнее, когда модель обучали на слабых преобразованиях изображений, а проверяли на сильных. Штраф, который разделял сигналы классов, улучшил целевую геометрическую метрику, но снизил точность относительно базовых режимов.
На искажённом BloodMNIST модель с L2 и разделением сигнала и шума достигла средней точности 61,03%, тогда как модель только с L2 получила 57,93%. На чистых изображениях различие между режимами осталось в пределах погрешности. Значит, выигрыш пришёл от устойчивости к помехам, а не от общего улучшения классификатора.
Проекция показала более сильный эффект. Если удалить десять направлений, найденных на отдельной валидационной части, точность модели с новым регуляризатором выросла с 60,9% до 69,3%. Для двух других режимов та же операция ухудшала результат: в их представлениях шум и полезные признаки оставались смешанными, поэтому проекция удаляла оба.
Этот результат важнее самой прибавки от регуляризации. Модель не просто стала реже ошибаться: она разместила помехи в подпространстве, которое можно оценить на одних изображениях и убрать на других без повторного обучения классификатора.
Работа меняет планы только для систем с измеримыми искажениями
Метод стоит включить в прототип, если команда обучает классификатор изображений и заранее знает типичные источники сдвига: размытие, изменения освещения, особенности микроскопа или другой аппаратуры. К существующей функции потерь добавляется геометрический штраф, а основной классификатор и архитектура не требуют замены.
Проекционный шаг предъявляет более жёсткое требование к данным. Чтобы найти подпространство помех, нужны отложенные примеры, для которых можно сравнить чистое и искажённое представления одного изображения. Если в эксплуатации встречаются неизвестные артефакты без такого контрольного набора, работа пока не показывает, как оценить направления для удаления.
Подпространства также зависят от конкретной модели и во многом от типа искажения. Их придётся вычислять после обучения и проверять отдельно для каждого рабочего сценария, а не переносить как готовый фильтр между моделями.
Масштаб проверки пока узок: одна свёрточная архитектура, две задачи классификации и искусственно внесённые искажения. Для ResNet-18 в медицинских или промышленных изображениях результаты дают основание провести эксперимент. Для vision transformer, самоконтролируемого обучения и естественных сдвигов между площадками это пока гипотеза, а не причина менять выбранную архитектуру.
Источники
Иллюстрация: рисунок из статьи «Signal-Noise Factorization Isolates Nuisance Variation into Removable Subspaces», Sakin Kirti, Joel Zylberberg, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.