Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель удалось сделать глубже при вычислении без пропорционального роста числа параметров и без обучения с нуля. Новый рецепт сократил бюджет обучения в 25 раз, а LoopLM обошёл сопоставимую по числу параметров плотную модель на всех 12 проверенных задачах. Поскольку препринт не прошёл рецензирование и все числа получили сами авторы, результаты пока стоит считать ориентиром, но сам рецепт уже можно воспроизвести в архитектурном прототипе.
Как повторный блок заменяет дополнительные слои
Обычный трансформер проводит токен через последовательность разных слоёв один раз. Модель с повторным блоком несколько раз применяет к нему один и тот же набор слоёв: число параметров не растёт, но каждый следующий проход добавляет вычисления.
За остановку отвечает отдельный шлюз. Он оценивает, после какого прохода модель может выдать результат. Такая схема позволяет в принципе тратить больше вычислений на сложные позиции, а простые обрабатывать быстрее.
Главная проблема — отделить пользу повторных проходов от различий в данных и обучении. Авторы построили LoopLM на 1,4 млрд параметров и сравнили его с плотными моделями, которые видели те же данные, прошли те же стадии и получили тот же бюджет токенов. Одну плотную модель подобрали по числу параметров, другую — по стоимости вывода.
Проверка охватила математику, выполнение кода, понимание текста, знания и здравый смысл. Это сравнение показывает эффект самой архитектуры, а не преимущество более удачной обучающей смеси.
Что удерживает повторные проходы от деградации
При обучении с нуля LoopLM использует четыре прохода с самого начала. Сначала модель обучают предсказывать следующий токен на общей смеси, затем продолжают на более качественных примерах с упором на математику, рассуждения и ответы по инструкции.
Критическая неисправность возникает в начале обучения: шлюз начинает почти всегда завершать вычисление после первого прохода. Остальные проходы перестают получать полезный обучающий сигнал, а модель незаметно превращается в обычный трансформер. Значение функции потерь при этом не выдаёт проблему, поэтому следить нужно непосредственно за распределением выходов шлюза.
Схему стабилизируют постепенным повышением скорости обучения и более сильной регуляризацией шлюза. Первый приём не даёт ему схлопнуться в начале, второй помогает восстановиться, если это всё же произошло. Благодаря этому авторам не понадобилось повторять многоступенчатое расписание Ouro.
Для готовой Qwen3-1.7B-Base потребовался другой приём. Простое повторение декодера ухудшало представление на каждом следующем проходе. Модель исправили одним обучаемым коэффициентом: он смешивает исходное представление токена с результатом предыдущего прохода.
Дополнительно авторы сгладили функцию потерь, чтобы каждый из трёх проходов продолжал обучаться, даже если шлюз редко выбирал один из них. Отдельные параметры для разных проходов почти не меняли результат, поэтому итоговый вариант полностью разделяет декодер между ними. На оценке модель останавливают на предпоследнем проходе, поскольку последний уже почти не улучшал функцию потерь.
Когда рецепт меняет план разработки
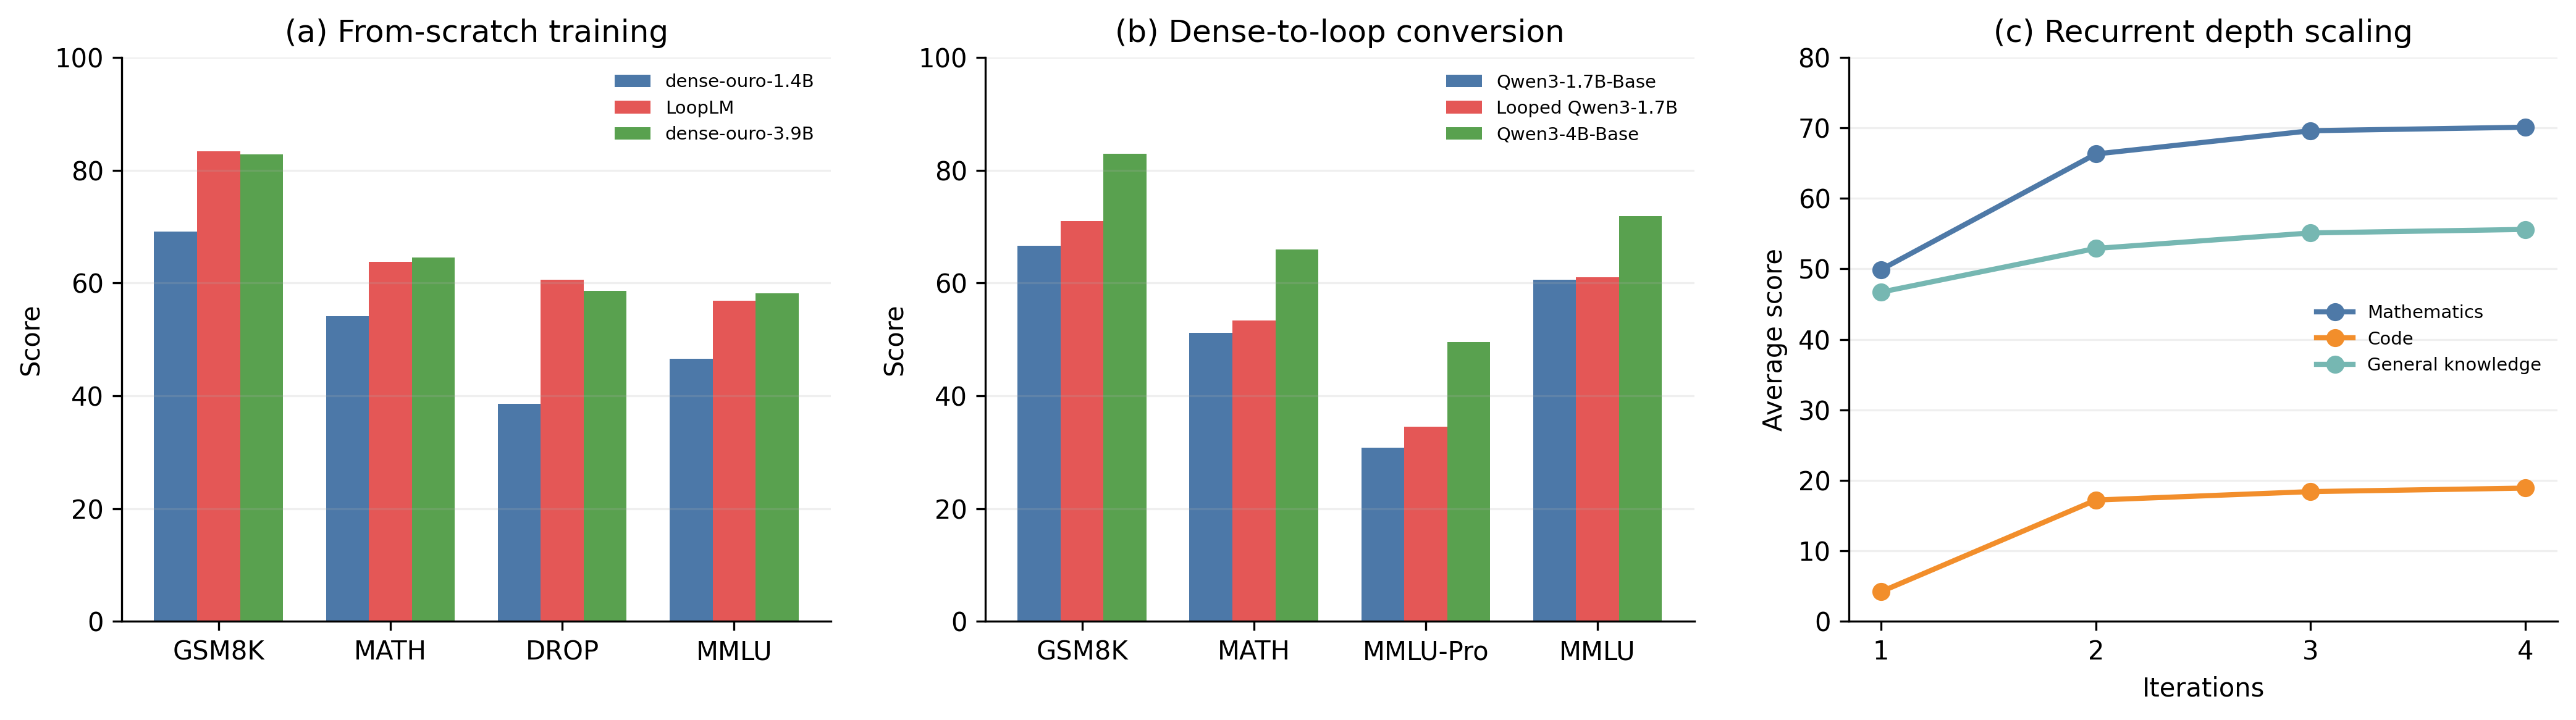
На GSM8K повторная модель прибавила 14 пунктов к результату плотного аналога, а на DROP — 22 пункта. На MATH преимущество тоже оказалось статистически значимым. При сопоставимой стоимости вывода LoopLM приблизился к более крупной плотной модели в математике и понимании текста, но уступил ей в знаниях и здравом смысле.
Преобразованная Looped Qwen превзошла исходную модель после такого же продолжения обучения на каждой проверенной задаче и на обеих смесях данных. При этом более крупная плотная Qwen с сопоставимой стоимостью вывода осталась впереди. Повторные проходы здесь не заменяют масштабирование во всех режимах, а дают промежуточный вариант: сохранить компактные веса и обменять дополнительное время ответа на качество.
Для команды с готовой базовой моделью практичнее сначала проверить преобразование, а не обучать LoopLM с нуля. Оно потребовало менее 1% вычислений исходного предварительного обучения и не добавило отдельный набор параметров на каждый проход. Такой эксперимент подходит, если вес модели ограничен памятью, а задержку можно увеличить.
Обучение с нуля имеет смысл, когда команда контролирует данные и готова отдельно наблюдать за шлюзом остановки. Проверки охватывают две архитектурные линии и несколько групп задач, но остаются лабораторным сравнением базовых моделей: работа не измеряет задержку на конкретном оборудовании и не показывает поведение внутри прикладной системы. Поэтому решение о внедрении всё равно требует замера на собственных запросах и целевых GPU.
Источники
Иллюстрация: рисунок из статьи «Closing the Loop: Practical Training Recipes for Looped Language Models», Andrei Marchenko, Viacheslav Bezrukov, Oleg Kashurin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.