Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Многоагентные системы научились улучшать не только схему работы, но и роли, которые её создают и исполняют. Совместное обучение ролей прибавило 5,03 процентного пункта против 2,83 у одной роли в нерецензированной работе Xuehang Guo и коллег, где числа получили сами авторы. Для команд это переносит внимание с выбора генератора на обучение всей связки агентов.
Почему одного генератора недостаточно
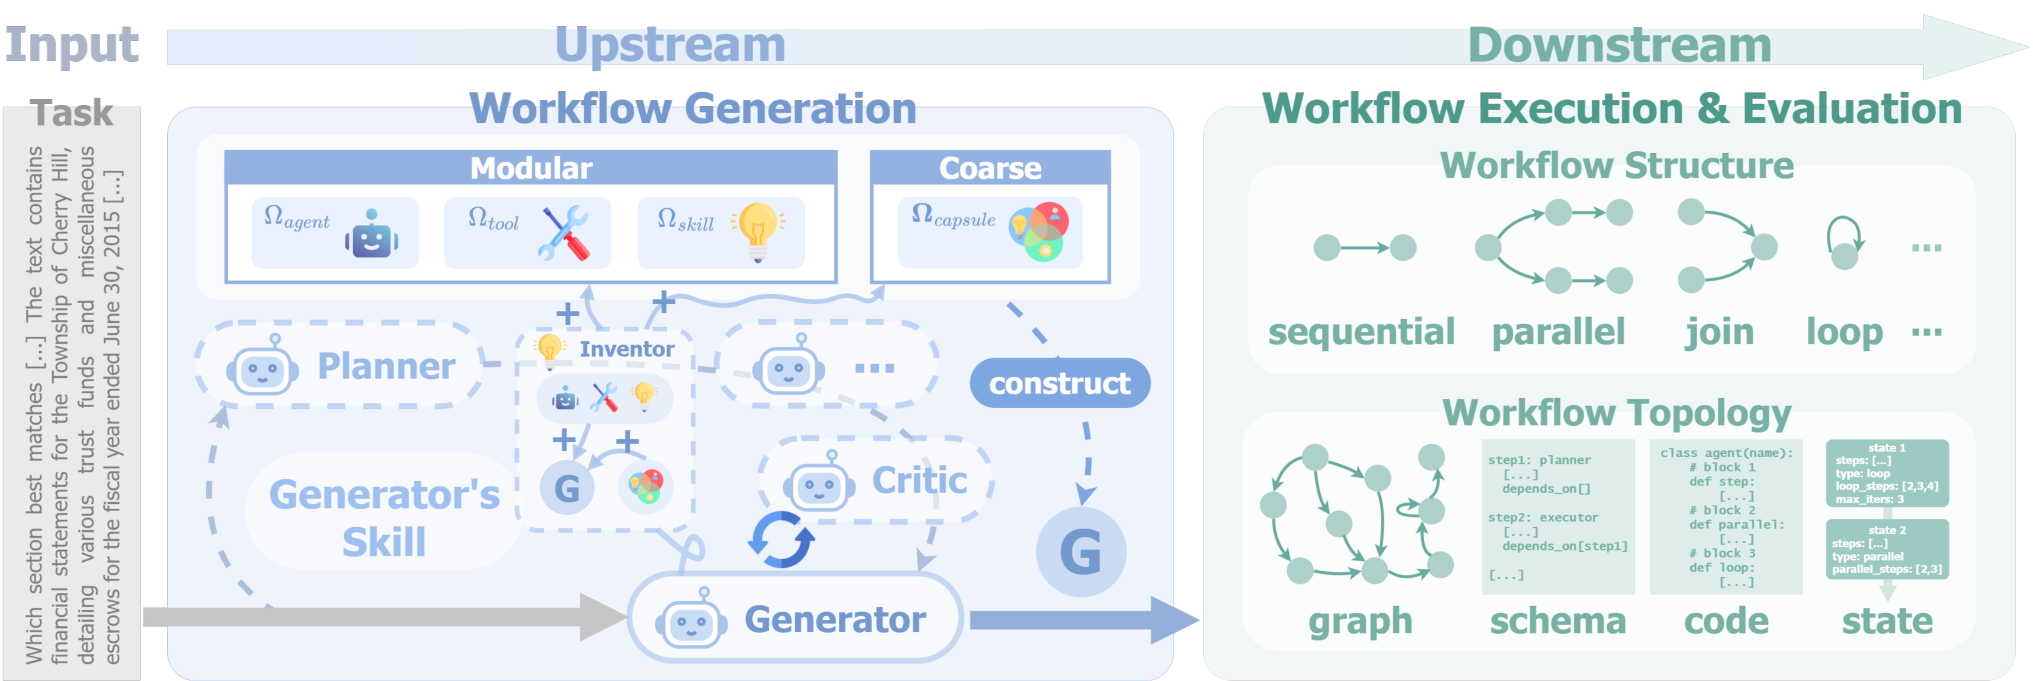
Обычный многоагентный процесс начинается с генератора: он превращает задачу в ориентированный граф, выбирает агентов и инструменты, задаёт последовательные, параллельные или повторяющиеся шаги. Затем исполнители проходят по этому графу и собирают итоговый ответ.
Предыдущие подходы обычно обучают генератор, но оставляют исполнителей и вспомогательные роли неизменными. Это создаёт разрыв: итог зависит от всей системы, а учится только компонент, который проектирует её структуру.
Обучать роли вместе сложнее. Выход одного агента становится входом другого, поэтому локальная ошибка может проявиться несколькими шагами позже. Итоговая оценка ответа показывает, что процесс не справился, но не объясняет, кто именно испортил результат.
FloWright использует один механизм выполнения и проверки для всех ролей. Он запускает граф, сохраняет след выполнения и выставляет итоговую оценку. Этот же сигнал служит метрикой качества, наградой при обучении и ориентиром для отбора удачных примеров во время работы модели.
Как след выполнения превращается в награду
Награда строится как лестница. Система проверяет, удалось ли разобрать выход роли, соответствует ли он правилам этой роли, выполнился ли процесс до конца и насколько правилен итоговый ответ. Поэтому неудачный запуск не обязательно получает один бесполезный ноль: модель видит, до какого этапа дошла.
К этой лестнице добавляется локальный штраф. FloWright связывает узлы графа с создавшими или исполнившими их ролями, а затем читает из следа выполнения, какие узлы стали причиной сбоя. Роль штрафуют пропорционально доле проблемных узлов в её части графа.
Так генератор отвечает за выбранные узлы и связи, создатель нового навыка — за узлы с этим навыком, а исполнитель — за собственные действия. Для распределения награды не нужны отдельная модель-оценщик, ручная разметка или повторный запуск. Это не делает обучение бесплатным: вычисления по-прежнему нужны для самих запусков, но разбор ответственности не добавляет ещё один цикл выполнения.
Роли можно обучать по отдельности или совместно. Во втором случае обновлённый генератор меняет задания, которые получают исполнители, а улучшившиеся исполнители меняют обратный сигнал для генератора. Получается взаимная учебная программа, а не набор независимо настроенных компонентов.
Во время применения FloWright может не менять веса модели, а собирать успешные случаи в повторно используемую основу для следующих задач. Такой режим ближе к автоматическому обновлению примеров и правил процесса, чем к полноценному дообучению в рабочей среде.
Когда работа меняет планы команды
Максимальный прирост над необученным FloWright достиг 7,41 процентного пункта. Улучшения сохранялись на заданиях из обучающего распределения, изменённых вариантах знакомых заданий и предметных областях, которые система не видела при обучении.
Проверка охватила 12 наборов данных из семи областей. DataWright усложнял исходные примеры тремя способами: объединял несколько вопросов в одну задачу, связывал вопросы с несколькими входными данными и добавлял отвлекающие входы. В итоге получились 44 сочетания набора, способа усложнения и уровня трудности.
Обучали открытые Qwen3.5-4B и Qwen3.5-9B, а при проверке также использовали закрытые GPT-5-mini и GPT-5.4-mini. Задачи включали работу с документами, презентациями, диаграммами, кодом, математикой и финансами. Одноагентные варианты получали сопоставимый вычислительный бюджет, поэтому преимущество нельзя объяснить только дополнительными вызовами модели.
Главное практическое следствие касается архитектуры обучения. Если продукт уже хранит граф процесса, принадлежность шагов ролям, результаты инструментов и проверяемый итог, имеет смысл проектировать общий контур награды для генератора и исполнителей. Фиксировать исполнителей и обучать только планировщик теперь выглядит как искусственное ограничение.
Подход хуже переносится на процессы, где нельзя автоматически проверить промежуточные выходы и конечный ответ. FloWright распределяет имеющийся проверяемый сигнал, но не создаёт объективную метрику для переговоров, стратегии или субъективного текста. Перед внедрением важнее проверить качество следа выполнения и правил оценки, чем сразу расширять число агентов.
DataWright указывает ещё на одну развилку. Если один агент решает тест за один проход, многоагентная архитектура может выглядеть лишней даже при хорошем устройстве. Оценивать такую систему стоит на составных заданиях с несколькими источниками и зависимыми шагами — тех, ради которых её строят.
Источники
Иллюстрация: рисунок из статьи «It Takes Workflows to Evolve Better Workflows», Xuehang Guo, Haoyu Wang, Haifeng Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.