Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Примеры для новой задачи можно один раз свернуть во внутренние поправки LLM, а затем выполнять запросы без исходных демонстраций. В препринте University of Virginia, который не прошёл рецензирование и все числа для которого получили сами авторы, Task Operator оказался ближе к обычному обучению по контексту, чем прежние способы сжатия примеров. Метод может сократить повторную обработку длинных подсказок, но требует прямого доступа к слоям модели.
Как демонстрации превращаются в оператор задачи
Обучение по примерам в контексте (in-context learning, ICL) не меняет веса модели. Пользователь помещает в подсказку несколько пар «вход — правильный ответ», и модель учитывает их при обработке нового запроса. Эти пары приходится передавать и вычислять заново для каждого запроса, даже если задача не меняется.
Прежние методы пытались заменить примеры фиксированным вектором, который добавляют к активациям модели. Такой перенос работает для простых соответствий, но хуже справляется с задачами, где ответ зависит от конкретного входа: обращением последовательности, удалением повторов или математическим рассуждением.
Task Operator сохраняет не готовую добавку, а правило преобразования. Для каждой головы внимания авторы разделяют её выход на вклад текущего запроса и вклад демонстраций. Полный выход точно выражается как масштабированный выход без контекста плюс отдельное смещение от контекста.
Масштаб показывает, какая доля внимания осталась на токенах вне демонстраций. Смещение собирает значения, которые голова внимания получила от самих примеров. Вместе они образуют аффинное преобразование: модель одновременно меняет силу исходного сигнала и добавляет контекстную поправку.
Параметры извлекают из оценок внимания и внутренних значений на всех слоях, головах и позициях. Затем их усредняют по запросам без правильных ответов. Авторы обнаружили, что для одной задачи эти параметры достаточно устойчивы между примерами, поэтому их можно повторно применять к новым входам.
Во время выполнения модель получает подсказку того же формата, но уже без демонстраций. Оператор меняет выходную проекцию механизма внимания на позициях шаблона, содержимого запроса и генерируемого ответа. Это не постоянное дообучение весов: поправка действует только при выполнении выбранной задачи.
Динамическая поправка лучше фиксированного вектора
Метод проверили на четырёх моделях семейств Qwen и Llama и восьми лексических, алгоритмических и логических задачах. Для извлечения использовали одинаковые наборы демонстраций, а результат сравнили с обычным ICL, выполнением без примеров и четырьмя методами переноса знаний через активации. В задачах на рассуждение ответ засчитывали только при точном совпадении с эталоном.
На MATH500 меньшая модель Qwen с Task Operator дала 51,2% правильных ответов против 55,8% у обычного ICL. Лучший из других методов сжатия примеров достиг 28%. Это не превосходство над полной подсказкой, а сокращение большей части разрыва между запросом без примеров и запросом с демонстрациями.
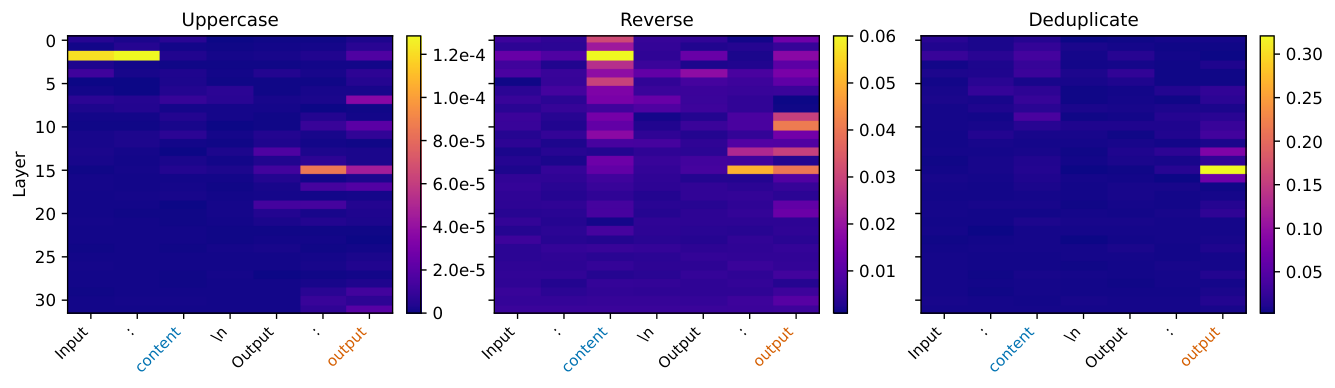
Разница проявилась и в разборе самого оператора. На простых преобразованиях хватало позиций шаблона, но обращение последовательности и удаление повторов зависели также от содержимого и генерируемых токенов. Один масштаб или одно смещение не воспроизводили результат: нужны обе части преобразования.
Важные участки оказались разреженными и зависели от задачи. Поэтому фиксированное место для вектора переносит знания хуже, чем оператор, распределённый по слоям и позициям. Авторы также объединяли операторы из отдельных небольших пакетов демонстраций: качество росло без помещения всех примеров в одно контекстное окно.
Планы меняются только для моделей под собственным контролем
Task Operator имеет практический смысл для повторяющейся задачи с устойчивым шаблоном: классификации, нормализации данных или специализированного рассуждения. Команда может один раз извлечь оператор, а затем не передавать одинаковые демонстрации в каждом запросе. Статья, однако, не даёт замеров задержки и стоимости, поэтому величину ускорения для рабочего сервиса пока нельзя оценить.
Метод нельзя добавить поверх закрытого API как обычную подсказку. Для извлечения нужны оценки внимания и внутренние значения, а для воспроизведения — вмешательство в выходные проекции на разных слоях и шагах генерации. Подход рассчитан на модели, которые команда запускает сама и может модифицировать.
Для продукта с часто меняющимися задачами обычный ICL остаётся проще: примеры видны, быстро заменяются и не требуют отдельной инфраструктуры исполнения. Если же одна подсказка обслуживает большой поток однотипных запросов, работа даёт основание проверить оператор в пилоте — сначала на качестве, затем на задержке, памяти и совместимости с оптимизированным сервером вывода.
Источники
Иллюстрация: рисунок из статьи «Capturing In-Context Learning Dynamics with Task Operators», Guangzhi Xiong, Zhenghao He, Bohan Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.