Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Память при генерации текста больше не обязана расти вместе с контекстом. В модели блочной диффузии Mamba на контексте в 256 тысяч токенов кеш занял 7,5 ГБ против 82 ГБ у варианта с механизмом внимания; работа пока не рецензирована, а числа получили сами авторы. Такой кеш снимает аппаратное ограничение для продуктов, которым нужно обрабатывать длинные документы или истории взаимодействия.
Блочная диффузия создаёт текст слева направо блоками, но внутри каждого блока восстанавливает несколько токенов параллельно. Обычный кеш механизма внимания хранит ключи и значения для всего готового префикса, поэтому расход памяти и время каждого следующего шага растут вместе с текстом.
Mamba вместо полного префикса переносит между блоками рекуррентное состояние фиксированного размера. Модель обучали с тем же доступом к префиксу, который она получает при генерации, поэтому кеш точно воспроизводит выученные вычисления, а не приближает их как надстройка над готовой моделью. Постоянный размер позволил увеличить совокупную пропускную способность при пакетной обработке в 14 раз относительно варианта с механизмом внимания.
Авторы сравнили варианты с механизмом внимания, Mamba и смешанной архитектурой класса 3 млрд параметров, обученные на одинаковых данных и с общей целью. Замеры скорости и памяти провели на одной NVIDIA H100, а качество проверили на поиске факта в длинном тексте, наборе задач LongBench и восьми задачах на рассуждение.
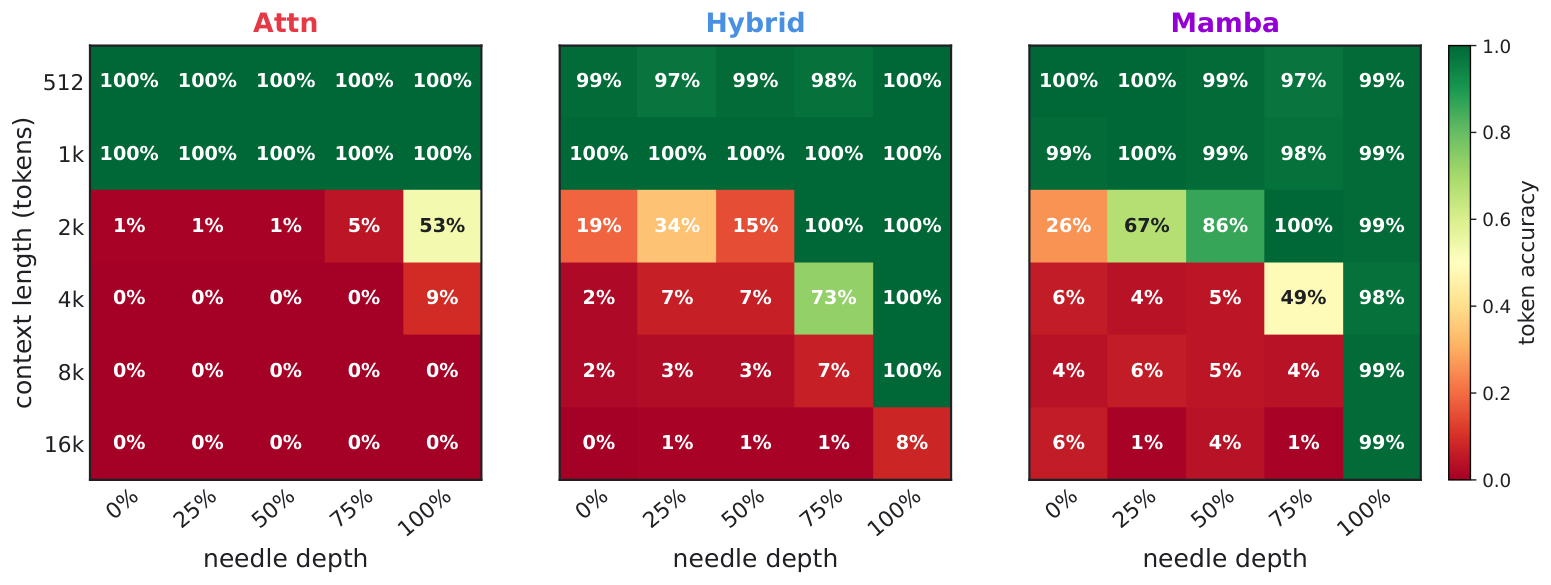
Модели обучались на контексте 1024 токена. Mamba и смешанный вариант сохраняли способность находить информацию на длине, которая превышала обучающую в 8–16 раз, тогда как результат модели с механизмом внимания резко падал уже при двукратном превышении. Смешанная архитектура при этом совпала с ней по среднему качеству, а чистая Mamba уступила примерно один процентный пункт.
Для продуктовой архитектуры это не сменный кеш, который можно подключить к существующей модели. Выигрыш требует выбрать Mamba или смешанный вариант и обучать модель под блочную генерацию; взамен память перестаёт зависеть от длины контекста, а пакетная обработка лучше использует GPU.
Источники
Иллюстрация: рисунок из статьи «Fixed State, Long Reach: What a Constant-Size Cache Buys Block Diffusion at Scale», Vaibhav Singh, Pierre-Andr\'e No\"el, Torsten Scholak и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.