Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агента научили управлять поливом на протяжении сельскохозяйственного сезона, не передавая языковой модели контроль над физикой и исполнительными механизмами. В нерецензированном препринте, где все числа получили сами авторы, Mimir израсходовал на 51% меньше воды, чем воспроизведение исторического графика полива. Для команд, которые строят длительно работающих агентов, работа предлагает схему: разрешить модели накапливать опыт, но оставить расчёты и право исполнить действие у проверяемого программного контура.
LLM предлагает действие, но не управляет клапаном
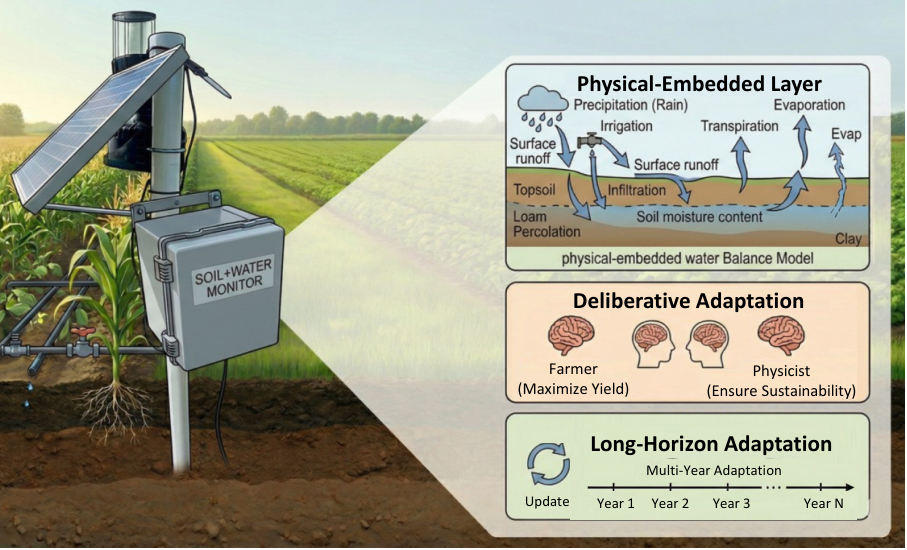
Команда Michigan State University и Ohio State University разделила Mimir на языковой и численный слои. Первый интерпретирует ситуацию и предлагает объём полива. Второй рассчитывает последствия, ограничивает допустимые действия и решает, какую команду можно исполнить.
Перед обращением к LLM система собирает структурированное состояние: запас воды в корневой зоне, полевую влагоёмкость, стадию роста культуры, испарение и прогноз осадков. Из этих величин программа вычисляет допустимый диапазон полива. Языковая модель не может изменить единицы измерения, расширить этот диапазон или переписать уравнение водного баланса.
Первый ответ LLM считается гипотезой. Детерминированный симулятор прогнозирует, как предложенный полив повлияет на запас воды, дефицит и дренаж. Результат возвращается модели, чтобы она исправила предложение; цикл ограничен тремя раундами и не может продолжаться до тех пор, пока модель не выдаст удобный для себя ответ.
Исправленное предложение тоже не становится командой. Оно лишь задаёт отправную точку для набора кандидатов, куда входят нулевой полив и максимально допустимое пополнение. Программа проигрывает каждый вариант на горизонте управления, сначала отбрасывает решения с физическими нарушениями, затем выбирает вариант с меньшей стоимостью. Последняя проверка ограничений и резервный сценарий работают независимо от LLM.
Такое распределение ролей отличается от агента, который вызывает инструмент сразу после текстового рассуждения. Mimir позволяет языковой модели направлять поиск, но численный слой сохраняет последнее слово. Ошибка рассуждения может ухудшить исходную гипотезу, однако не отменяет физические границы исполнения.
Опыт меняет контекст, а не законы физики
Быстрый контур исправляет отдельное решение. Медленный контур ищет повторяющиеся ошибки между сезонами: например, одинаковую реакцию на неопределённый прогноз или регулярное вмешательство защитного механизма. Когда настроенный порог повторяемости достигнут, система превращает наблюдение в короткий принцип для следующих запросов к LLM.
Такой принцип описывает ситуацию, рекомендуемую поправку, исключения и подтверждающий опыт. Если ошибка не повторяется, память не обновляется. Это защищает контекст от бесконечного накопления случайных выводов после каждого эпизода.
Память влияет только на будущие предложения. Она не меняет веса модели, физический симулятор, формулу оценки, допустимый диапазон полива и проверку перед исполнением. Поэтому агент может корректировать привычный ход рассуждения, но не способен объявить прежнее ограничение ненужным на основании собственного опыта.
Это полезная граница для любых длительно работающих физических агентов. Накопленная память обычно содержит выводы из неполных наблюдений и может закрепить ошибочную закономерность. В Mimir такая ошибка влияет на приоритет вариантов, но её всё равно проверяют по неизменной численной модели.
Архитектура важнее перехода на более крупную LLM
Общую схему проверяли ретроспективно на полевых данных из Michigan, Texas и Colorado, для картофеля, кукурузы и подсолнечника в разные годы. Все контроллеры оценивали одной сводной стоимостью: чем она ниже, тем лучше система балансирует расход воды и последствия водного дефицита. Расход воды рассматривали отдельно, поскольку экономия за счёт пересушивания сама по себе не означает хорошего управления.
Mimir получил стоимость 100,94 против 134,33 у ближайшего из приведённых ориентиров MAD-50. Удаление прогнозирования физических последствий увеличило стоимость почти в пять раз. Без проверяемого исправления предложений она выросла на 66%, а без постоянного контекста между сезонами — на 53%.
Эти сравнения проводили на отдельных согласованных срезах, поэтому абсолютные значения между ними сопоставлять нельзя. Проверка показывает вклад каждого механизма внутри его пары, а не универсальный рейтинг способов полива. Эксперименты также были ретроспективными: они оценивают поведение в симуляторе на наблюдавшихся погодных и полевых данных, а не безопасность автономного управления реальным оборудованием.
Увеличение размера LLM и смена семейства моделей не давали последовательного улучшения при неизменном физическом контуре. Значит, переход на более крупную модель сам по себе не заменяет симулятор, ограниченный перебор действий и независимую проверку исполнения.
Работа не даёт причины добавлять LLM в задачу, которую уже полностью описывает численный контроллер. Она меняет планы там, где агенту приходится учитывать семантический контекст, разбирать нестандартные ситуации и переносить опыт между длинными циклами работы. В такой системе LLM стоит проектировать как изменяемый слой предложений, а физическую модель, критерий оценки и право исполнить действие — как отдельную доверенную основу.
Источники
Иллюстрация: рисунок из статьи «Mimir: Physics-Grounded LLM Agents for Long-Horizon Irrigation Control», Yimeng Liu, Mi Zhang, Younsuk Dong и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.