Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили находить недоступные ей решения с помощью редких исправлений по ходу ответа, после которых она продолжает рассуждать сама. Хотя препринт не рецензировали и числа получили сами авторы, метод MInTRL от Amazon Web Services и Boston University обошёл сильнейший из методов сравнения на величину до 9,44 процентного пункта. Для обучения с проверяемой наградой это предлагает промежуточный вариант между генерацией только собственных ответов и обучением на полностью чужих решениях.
Проверяющий исправляет только ошибочный шаг
При обучении на данных текущей политики (on-policy) модель генерирует решения сама, а затем получает награду за правильный итог. Такие данные близки к поведению модели, поэтому на них удобно учиться. Но при ограниченном числе попыток модель видит только те успешные пути, которые уже способна случайно найти.
Полностью внешние решения расширяют набор примеров, но создают другую проблему. Если учитель рассуждает не так, как обучаемая модель, вероятность его токенов может оказаться слишком низкой. Модель получает правильную траекторию, но плохо усваивает её из-за разрыва между собственным и чужим распределением ответов.
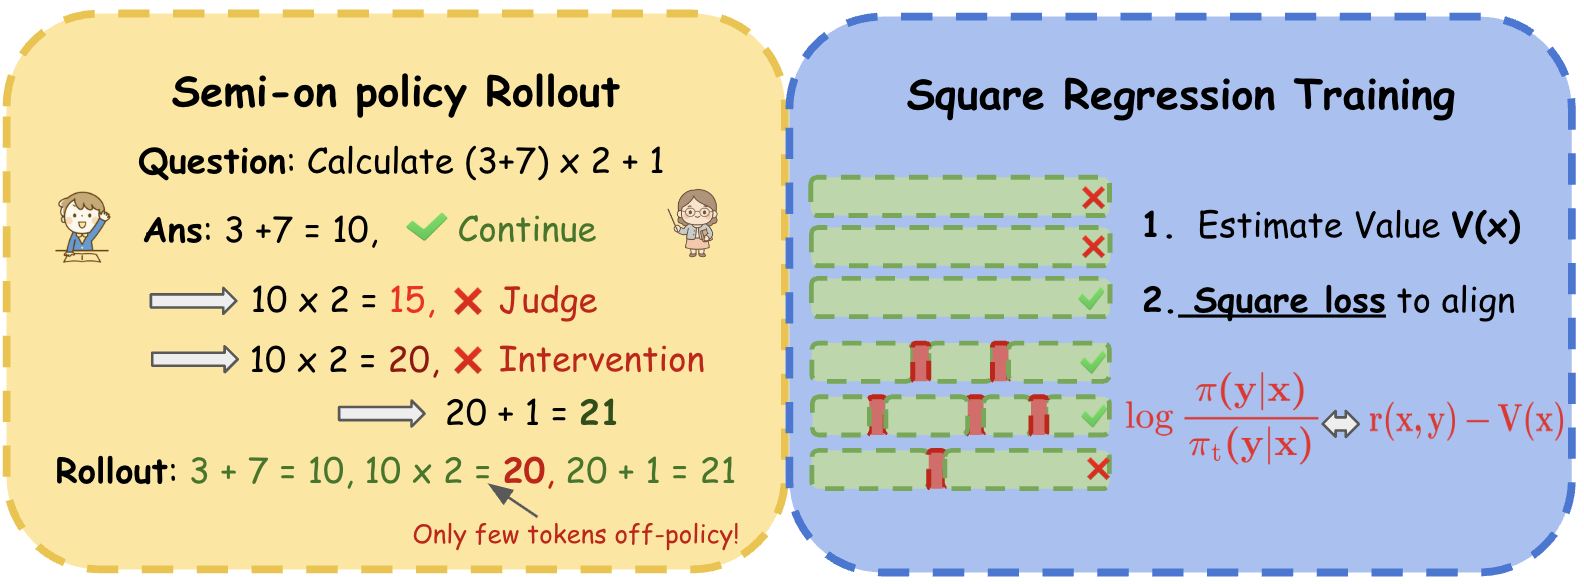
MInTRL оставляет генерацию за текущей моделью и периодически отдаёт готовый фрагмент модели-проверяющему. Та находит первый ошибочный шаг, отбрасывает неверное продолжение и пишет короткую поправку. Сразу после неё исходная модель снова получает управление и заканчивает ответ самостоятельно.
В примере с кодом модель вывела формулу, которая для входа n=2 давала 4 вместо ожидаемых 19. Проверяющий указал на несовпадение с тестом и направил рассуждение к геометрии шестиугольника. Дальнейшую формулу и реализацию модель построила уже без его участия.
Так исправление не заменяет решение целиком, а переносит модель через участок, на котором её собственный поиск застрял. В обучающей траектории сохраняется большая часть токенов текущей модели, но появляется успешный путь, который обычная генерация могла не обнаружить.
Умеренное вмешательство оказалось полезнее полного решения
Для смешанных траекторий авторы отказались от обычной коррекции через отношение вероятностей. Даже короткая чужая вставка может сделать такое отношение нестабильным на уровне всего ответа. Вместо этого MInTRL напрямую обучает вероятность траектории соответствовать её преимуществу: итоговой награде за вычетом среднего результата чистых ответов текущей модели.
Лучший результат пришёлся на долю внешних токенов около 2–4%. Когда проверяющий вмешивался чаще или писал более длинные фрагменты, выигрыш сокращался, а затем результат опускался ниже варианта без вмешательств. Метод работает не потому, что сильная модель производит больше текста, а потому, что она добавляет минимальный фрагмент в нужном месте.
В отдельном опыте роль проверяющего выполняла та же модель, но с дополнительным контекстом, недоступным при обычной генерации. Средний результат лучшего варианта MInTRL составил 52,29 против 47,26 у GRPO. Значит, схема не всегда требует отдельного более сильного учителя: иногда достаточно дать текущей модели сведения, по которым она распознает и исправит ошибку.
Проверяли Qwen3-1.7B и Qwen3-4B без режима подробного рассуждения. Обучение охватывало математику и генерацию кода, а оценка — семейства задач AIME и HMMT, а также LiveCodeBench, HumanEval+ и MBPP+. В сравнение вошли обычное обучение с подкреплением на собственных ответах, дообучение на полных решениях учителя и другие способы добавлять внешние подсказки.
Менять план стоит на этапе собственного дообучения
MInTRL относится к командам, которые сами обучают модель с проверяемой наградой: компилятором, тестами, точным числовым ответом или другим автоматическим критерием. Для продукта, который только вызывает готовую модель через API, метод не меняет архитектуру приложения — он требует доступа к циклу генерации и обновлению весов.
Если собственное обучение уже построено вокруг GRPO или сходного метода, работу разумно рассматривать как план отдельного эксперимента, а не как замену контура целиком. Понадобятся пошаговая генерация, проверяющий, возможность обрезать ошибочный суффикс и отдельные чистые ответы для расчёта базового результата. После начальной фазы авторы отключают вмешательства и продолжают обычное обучение на данных текущей модели.
Главный параметр здесь — не сила проверяющего сама по себе, а объём текста, который он забирает у обучаемой модели. Более сильный проверяющий в опытах не всегда давал лучший итог: его формулировки могли оказаться дальше от распределения Qwen и хуже усваиваться. Поэтому в пилоте нужно сравнивать не только качество исправлений, но и то, продолжает ли модель успешно рассуждать после короткой подсказки.
Работа меняет план там, где обучение упёрлось в отсутствие успешных траекторий, а полная дистилляция слишком сильно смещает данные к поведению учителя. MInTRL предлагает сохранить основной обучающий поток прежним и добавить внешний сигнал только в первых ошибочных шагах. Если же текущая модель уже регулярно находит правильные решения, дополнительные проверки добавят вычисления, а их польза по мере обучения снижается.
Источники
Иллюстрация: рисунок из статьи «MInTRL: Off-policy Intervention can boost On-policy RL», Mingyu Chen, Yefan Tao, Gerald Friedland и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.