Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Долю старых данных при продолженном предобучении можно определять по ходу работы модели, а не задавать до запуска, показал препринт Replay on Demand. Хотя работу ещё не рецензировали и числа получили сами авторы, метод RoD снизил забывание на 43% по сравнению с настроенной фиксированной смесью при том же качестве адаптации. Для команд это возможная замена перебору пропорций одной обучающей сессией, которая сама перераспределяет вычисления.
Как модель решает, что повторить
Продолженное предобучение адаптирует готовую LLM к новым текстам: например, к юридическим документам или другому языку. При этом модель может хуже справляться с материалом, который освоила раньше. Обычно в новые данные заранее добавляют фиксированную долю исходной обучающей выборки, чтобы сдержать забывание.
Фиксированная смесь расходует вычисления независимо от состояния модели. Она может снова показывать модели хорошо сохранившийся материал и недостаточно часто возвращаться к знаниям, которые быстро разрушаются. Подход также требует заранее выбрать долю повтора или обучить несколько вариантов и сравнить их.
RoD оценивает новые и старые примеры по разным признакам, но затем помещает их в общий конкурс за место в обучающем пакете. Новый пример получает высокий приоритет, если модели ещё есть чему на нём учиться. Старый — если текущая модель обрабатывает его хуже, чем исходная версия до адаптации.
Для оценки новых данных нужен отдельный эталон, обученный на целевой области. Для старых данных эталоном служит исходная модель. RoD сравнивает потери текущей и эталонной моделей: чем больше разница, тем полезнее сейчас обучаться на этом примере.
В начале старые примеры почти не выигрывают отбор, поскольку модель ещё ничего не забыла. Затем потенциал новых данных снижается, а оценки забытых примеров растут. Доля повтора увеличивается автоматически, причём RoD чаще выбирает именно те источники, на которых ухудшение оказалось сильнее.
Динамическая смесь удержала знания без перебора пропорций
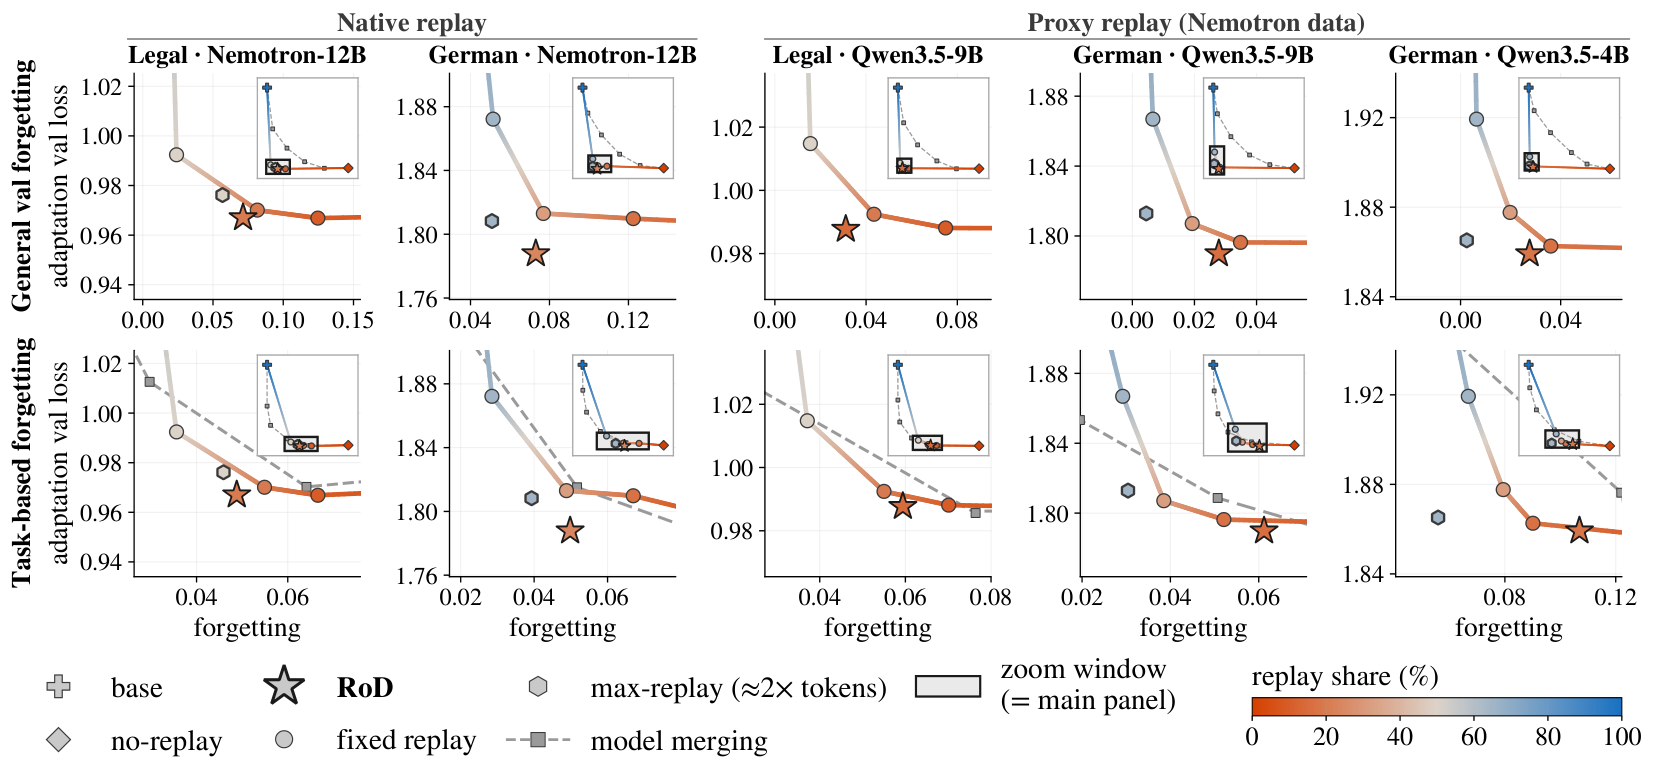
Метод проверяли на семействах Nemotron и Qwen размером от 4B до 35B параметров. Модели адаптировали к юридическим текстам и немецкому языку, а сравнивали с обучением без повтора, несколькими фиксированными долями старых данных и объединением весов исходной и адаптированной моделей.
Качество оценивали одновременно по двум осям. Адаптацию измеряли потерями на отложенных данных новой области, а забывание — ростом потерь на общих текстах относительно исходной модели. Дополнительно проверяли, как меняется точность в группах задач на знания, рассуждения, здравый смысл и языковые способности.
На Nemotron с доступом к данным исходного предобучения RoD достигал границы лучших сочетаний адаптации и сохранения знаний либо сдвигал её. Иными словами, фиксированная смесь могла улучшить один показатель только ценой другого, тогда как RoD находил сопоставимую или более выгодную точку без заранее выбранной доли повтора.
Для Qwen исходная обучающая выборка была недоступна, поэтому вместо неё использовали данные Nemotron. Даже с такой заменой RoD уменьшил забывание в задачах на 60% относительно адаптации без повтора в одном из юридических экспериментов. Однако преимущество перед фиксированной смесью по прикладным задачам оказалось меньше, чем по проверочным потерям: чужая выборка хуже отражала способности Qwen, которые требовалось сохранить.
Вариант с максимальным повтором удерживал знания немного лучше, но использовал примерно вдвое больше обучающих токенов и слабее адаптировался. Сравнение фиксированных смесей и RoD проводили при одинаковом числе обучающих токенов, хотя RoD дополнительно тратил вычисления на оценку кандидатов.
Меняет ли RoD планы продолженного предобучения
RoD меняет план эксперимента, если команда собиралась перебирать несколько долей старых данных. Вместо серии полноценных запусков можно проверить один динамический режим, а фиксированную смесь оставить контрольным вариантом. Особенно полезен подход там, где разные части исходной выборки забываются с разной скоростью.
Это не бесплатная замена обычному продолженному предобучению. Нужно подготовить адаптационный эталон, сохранить исходную модель и заранее вычислить их потери на кандидатах. На каждом шаге текущая модель также выполняет дополнительный проход для оценки пула, который в основных опытах был вдвое больше выбранного пакета.
Критичен и источник старых данных. Опыт с Qwen показывает, что сторонняя выборка способна уменьшить забывание, но её сигнал хуже совпадает с сохранением конкретных способностей модели. Поэтому до изменения основного конвейера стоит проверить, предсказывает ли рост потерь на доступной старой выборке ухудшение тех задач, которые важны продукту.
Для крупных моделей работа предлагает два способа сократить накладные расходы. Авторы получали подходящую смесь с адаптационным эталоном меньшего размера и переносили найденную последовательность данных между моделями с разницей в масштабе 8,75 раза. Это делает RoD кандидатом для пилота на малой модели, но перенос проверен только на использованных семействах, юридических текстах и немецком языке.
Источники
Иллюстрация: рисунок из статьи «Replay on Demand: An Emergent Curriculum for Balancing Adaptation and Forgetting in Continued Pretraining», Lukas Thede, Shengzhuang Chen, Stefan Winzeck и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.