Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Многоходового LLM-агента научили не только избегать ранней ключевой ошибки, но и возвращаться к решению после неё. В препринте, который не прошёл рецензирование и приводит замеры самих авторов, PivotOPD показал лучший средний результат среди 13 методов на задачах с действиями, поиском и работой в интернете. Для разработки агентов это меняет цель обучения: полезно разбирать не только правильные траектории, но и состояния, в которые модель попадает из-за собственных ошибок.
Одна ранняя ошибка меняет всю дальнейшую траекторию
Обычная дистилляция на траекториях текущей модели (on-policy distillation) работает так: ученик выполняет задачу, а более сильная модель даёт подробный обучающий сигнал для получившихся ответов. В многоходовой среде этого недостаточно, потому что неправильное действие меняет состояние среды и набор доступных следующих действий.
PivotOPD сосредоточен на поворотной ошибке — действии, после которого кратчайший путь к цели становится длиннее или задача перестаёт решаться. В ALFWorld такие ошибки встретились в 59% неудачных траекторий трёх моделей Qwen3. Обычно первая из них возникала в начале работы, после чего агент продолжал тратить ходы, не возвращаясь к полезной последовательности действий.
Ошибку не всегда нужно предотвращать, чтобы спасти задачу. Если заменить поворотное действие на подсказанное символьным оракулом, доля успешных повторов достигает 59%. Если оставить ошибку и направить только следующие действия, результат почти тот же — 58%.
Стандартная дистилляция снижала общую долю неудач, но почти не исправляла траектории с поворотной ошибкой. Причина в том, что ученик редко сам выбирает действие, которое выводит его из созданного им состояния. Значит, правильное продолжение не попадает в обучающие примеры и не получает полезного сигнала.
Как модель учат предотвращать ошибку и выходить из неё
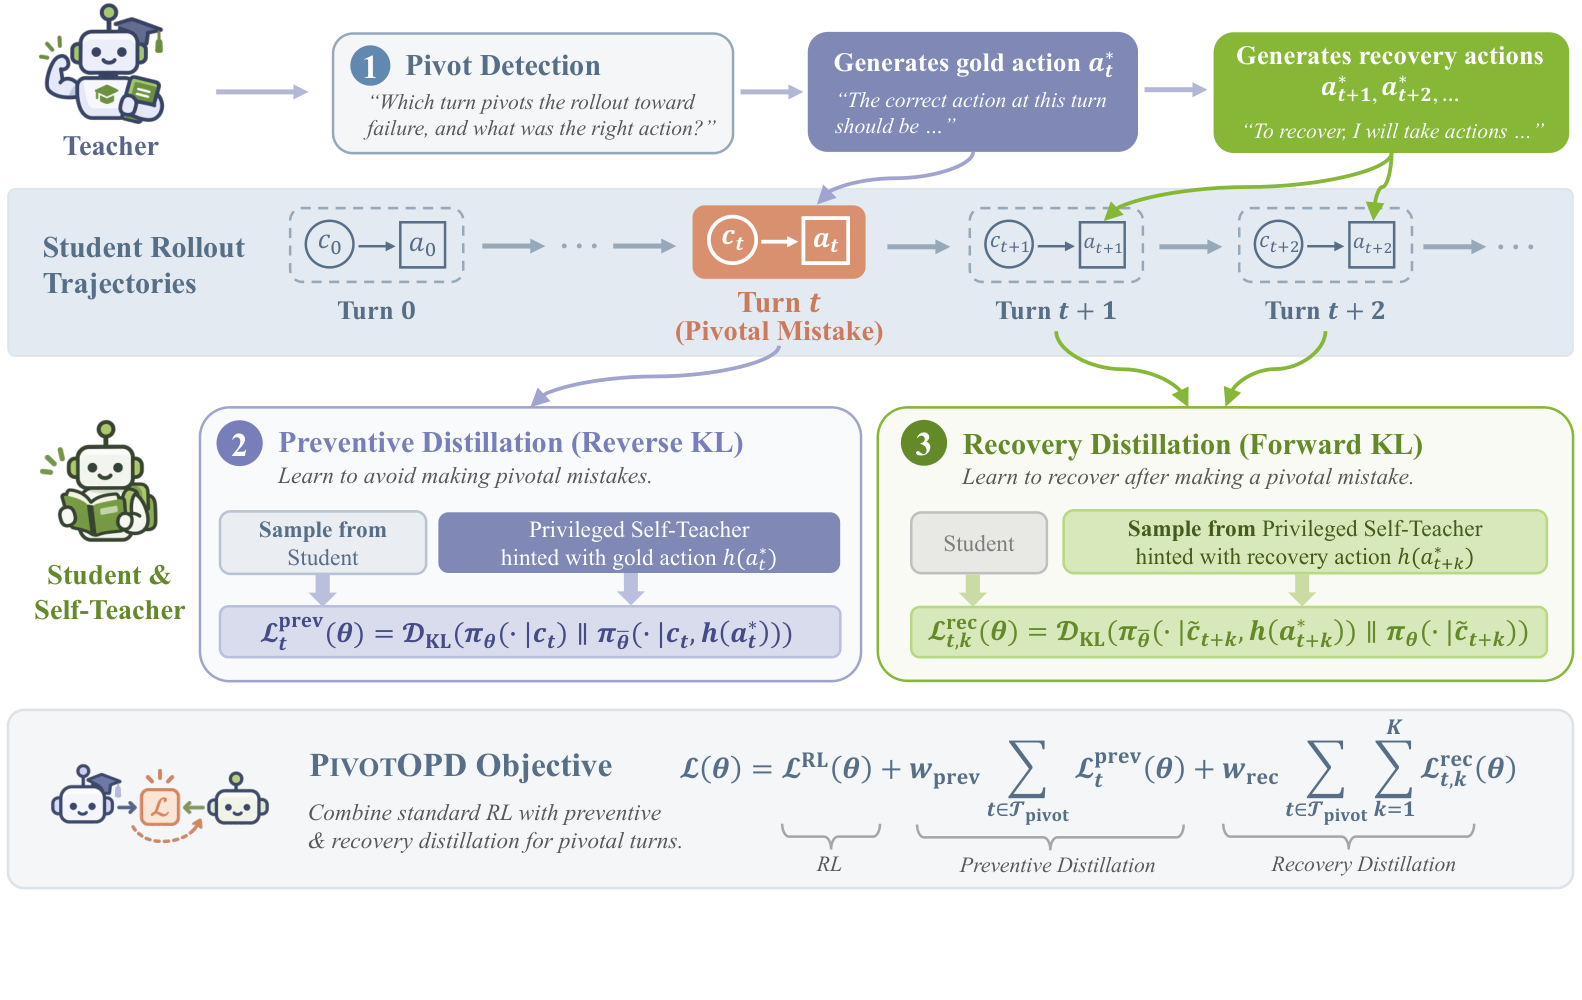
PivotOPD сначала собирает траектории ученика вместе с итогом задачи. Модель-учитель читает каждую траекторию, выбирает места, где решение могло свернуть не туда, и называет эталонное действие. Если оно отличается от действия ученика, ход считают поворотным.
Дальше обучение расходится на две ветви. Первая повышает вероятность эталонного действия в момент ошибки. Для этого замороженная копия ученика получает подсказку с правильным действием и заново оценивает уже записанный ответ. Такой сигнал отталкивает модель от выбранной ошибки, не требуя переписывать всю траекторию.
Вторая ветвь начинается после ошибки. Учитель называет действие для восстановления, а замороженная копия ученика пишет ответ, который ведёт к нему в привычном для модели стиле рассуждения. Исходный ученик получает тот же контекст без подсказки и учится воспроизводить это продолжение.
Разница между ветвями существенна. Предотвращение переоценивает ответ, который ученик уже смог создать. Восстановление обучает на ответе, созданном с подсказкой, поэтому модель видит полезное действие, даже если сама почти никогда его не выбирает.
Следующие шаги восстановления выполняются в копии среды: она повторяет все предыдущие действия, включая ошибочное, а затем применяет новый ответ. Поэтому PivotOPD учит не абстрактному исправлению рассуждения, а поведению в состоянии, которое действительно возникло после сбоя. В одном из разборов агент взял томат вместо яйца; обученная модель отложила томат, нашла яйцо и закончила задачу, тогда как базовая продолжила работать не с тем предметом.
Когда PivotOPD меняет планы разработки агента
Метод проверяли на Qwen3-1.7B и Qwen3-8B в ALFWorld, WebShop и задачах поиска ответа, а перенос на другую модельную семью — на Nemotron-3.5 в SWE-Bench Verified. Это охватывает текстовые действия в среде, покупки, поиск сведений и исправление программ, но все эксперименты относятся к обучаемым агентам с доступом к траекториям и модели-учителю.
На ALFWorld младшая Qwen3 прибавила 5,5 процентного пункта относительно сильнейшего базового метода. В SWE-Bench Verified PivotOPD поднял долю решённых задач на 3,2 пункта, тогда как стандартная дистилляция дала 0,2 пункта. Перенос между семействами моделей показывает, что эффект связан не только с особенностями Qwen3.
Работа меняет планы команды, если агент выполняет длинные задачи, взаимодействует с изменяемой средой и после ошибки продолжает действовать в ней. В таком проекте стоит сохранять не только успешные прогоны и итоговую награду, но также состояния после неудачных действий, оценки критических ходов и варианты выхода из них.
PivotOPD требует учителя, который способен найти ошибочный ход и предложить допустимое продолжение, а для нескольких шагов восстановления — ещё и повторяемой среды. Если процесс нельзя воспроизвести или состояние после действия не сохраняется, сначала придётся построить журналирование и механизм повторного запуска. Сам метод не заменяет эту инфраструктуру.
Источники
Иллюстрация: рисунок из статьи «PivotOPD: Learning to Recover from Pivotal Mistakes in Multi-Turn Agents», Yinghui He, Yapei Chang, Khushi Bhardwaj и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.