Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Часть длинного контекста научились сохранять в весах модели, чтобы она не пропадала при сильном сжатии кэша. В препринте Chanryeol Lee и коллег, который не прошёл рецензирование и содержит числа, полученные самими авторами, PatchKV стабильно улучшал результаты двух способов сжатия без дополнительных вычислений на каждом запросе. Подход рассчитан на системы, где один контекст загружают один раз, а затем задают по нему много вопросов.
Поправка воспроизводит поведение полного кэша
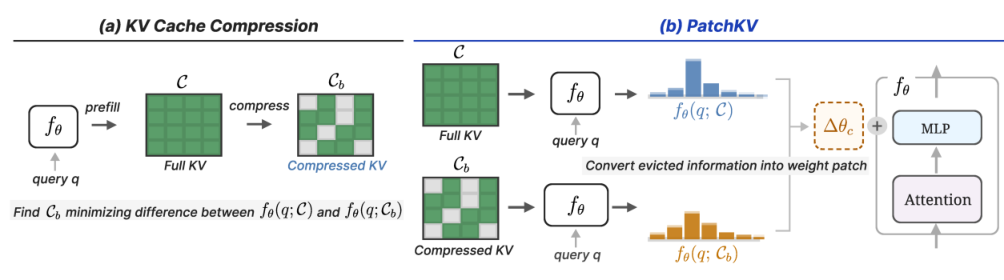
Во время генерации LLM хранит кэш ключей и значений (KV-кэш) для уже обработанных токенов. Его размер растёт вместе с контекстом, поэтому длинный документ, репозиторий или база знаний занимают всё больше памяти GPU при каждом последующем запросе.
Существующие компрессоры удаляют менее важные записи либо строят уменьшённое приближение полного кэша. Чем меньше остаётся записей, тем выше риск потерять факт или зависимость, которая понадобится в ещё неизвестном запросе.
PatchKV не заменяет компрессор. После сжатия он запускает модель на служебных последовательностях сначала с полным кэшем, а затем со сжатым. Получаются эталонные и искажённые активации, разницу между которыми нужно компенсировать.
Для каждого блока трансформера метод подбирает поправку к выходной проекции многослойного перцептрона. Гребневая регрессия (ridge regression) находит её прямым матричным расчётом: обучать модель градиентным спуском не требуется. Блоки исправляют последовательно, поэтому очередная поправка уже учитывает изменения в предыдущих.
Служебные последовательности строят из самого контекста. Модель может повторять его фрагменты, сама составлять сводку и перечень фактов либо объединять оба варианта. Реальные будущие вопросы при расчёте поправки не нужны.
Длинные последовательности обрабатывают частями, а для регрессии накапливают только матричные суммы. Поэтому память под промежуточные активации зависит от размера части, а не от полной длины служебной последовательности.
PatchKV помогает там, где компрессор уже теряет детали
Метод проверили на трёх архитектурах из семейств Qwen и LLaMA и на двух типах компрессоров: удалении записей через KVzip и построении приближённого кэша через Attention Matching. Набор задач включал вопросы по длинному контексту, поиск спрятанных фактов и математические задачи; длина контекста в SCBench доходила до 170 тысяч токенов.
Наиболее заметно поправка помогала при агрессивном бюджете, когда в кэше оставалось меньше 20% исходных записей. В этом режиме обычное сжатие быстро теряло качество, а PatchKV возвращал часть разницы между сжатым и полным кэшем. Улучшение сохранялось как для удаления токенов, так и для приближения кэша.
На смешанных контекстах одна поправка одновременно обслуживала разные задачи: например, поиск по репозиторию и извлечение значений либо суммаризацию и поиск спрятанного факта. Вариант с самопроверкой лучше подходил для сводок, а повторение фрагментов контекста — для точного поиска.
Для построения поправки авторы выбрали части по 5 тысяч токенов: при меньших частях результат оставался близким, а более длинные уже ухудшали качество. Это показывает, что нарезка служит не только экономии памяти. Если часть становится слишком длинной, модели сложнее точно реконструировать её, и эталонные активации становятся менее полезными.
Проверка охватывает сценарий с фиксированным контекстом и повторными запросами. PatchKV не заменяет полный кэш самостоятельно: в контролируемом опыте нужное поведение возвращалось только тогда, когда поправку соединяли с тем сжатым кэшем, для которого её рассчитали.
Повторные запросы оправдывают подготовку отдельной поправки
Для команд с уже работающим сжатием кэша план меняется умеренно: компрессор можно оставить и добавить PatchKV вторым этапом загрузки контекста. После слияния поправки с весами граф вычислений при генерации остаётся прежним, поэтому метод не добавляет операций для каждого нового токена ответа.
Экономия начинается только после подготовки. Система сначала должна построить полный кэш, получить сжатую версию, выполнить оба прогона служебных последовательностей и решить регрессии. PatchKV сокращает память при последующем обслуживании запросов, но не устраняет потребность в полном кэше на этапе расчёта.
Инфраструктуре также придётся связывать три объекта: исходную модель, конкретный сжатый кэш и рассчитанную для него поправку. При смене документа или обновлении базы знаний поправку нужно строить заново. Если контекст используют для единственного запроса либо часто заменяют, подготовительные расходы могут не успеть окупиться.
Практический кандидат для проверки — сервис, где длинный документ, репозиторий или база знаний остаются неизменными на протяжении серии запросов, а качество резко падает при уменьшении KV-кэша. PatchKV позволяет проверить более жёсткий бюджет памяти, не меняя сам компрессор и цикл генерации. Рассчитывать на полную замену исходного контекста не стоит: работа показывает компенсацию потерь, а не восстановление полного кэша во всех задачах.
Источники
Иллюстрация: рисунок из статьи «PatchKV: Weight-Space Compensation of KV Cache», Chanryeol Lee, Chanhyuk Lee, Yeonwoo Choi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.