Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Инференс LLM с субквадратичным вниманием можно распределять между разными ускорителями так, чтобы тратить меньше энергии и не передавать данные после каждого слоя. Хотя работа не рецензирована и все числа в ней получили сами авторы, схема SQD повысила число токенов на джоуль на 31–56% относительно лучшей системы только на GPU. Для инфраструктурных команд это меняет границу разбиения: этап генерации стоит делить по тому, растёт ли его рабочая память вместе с контекстом.
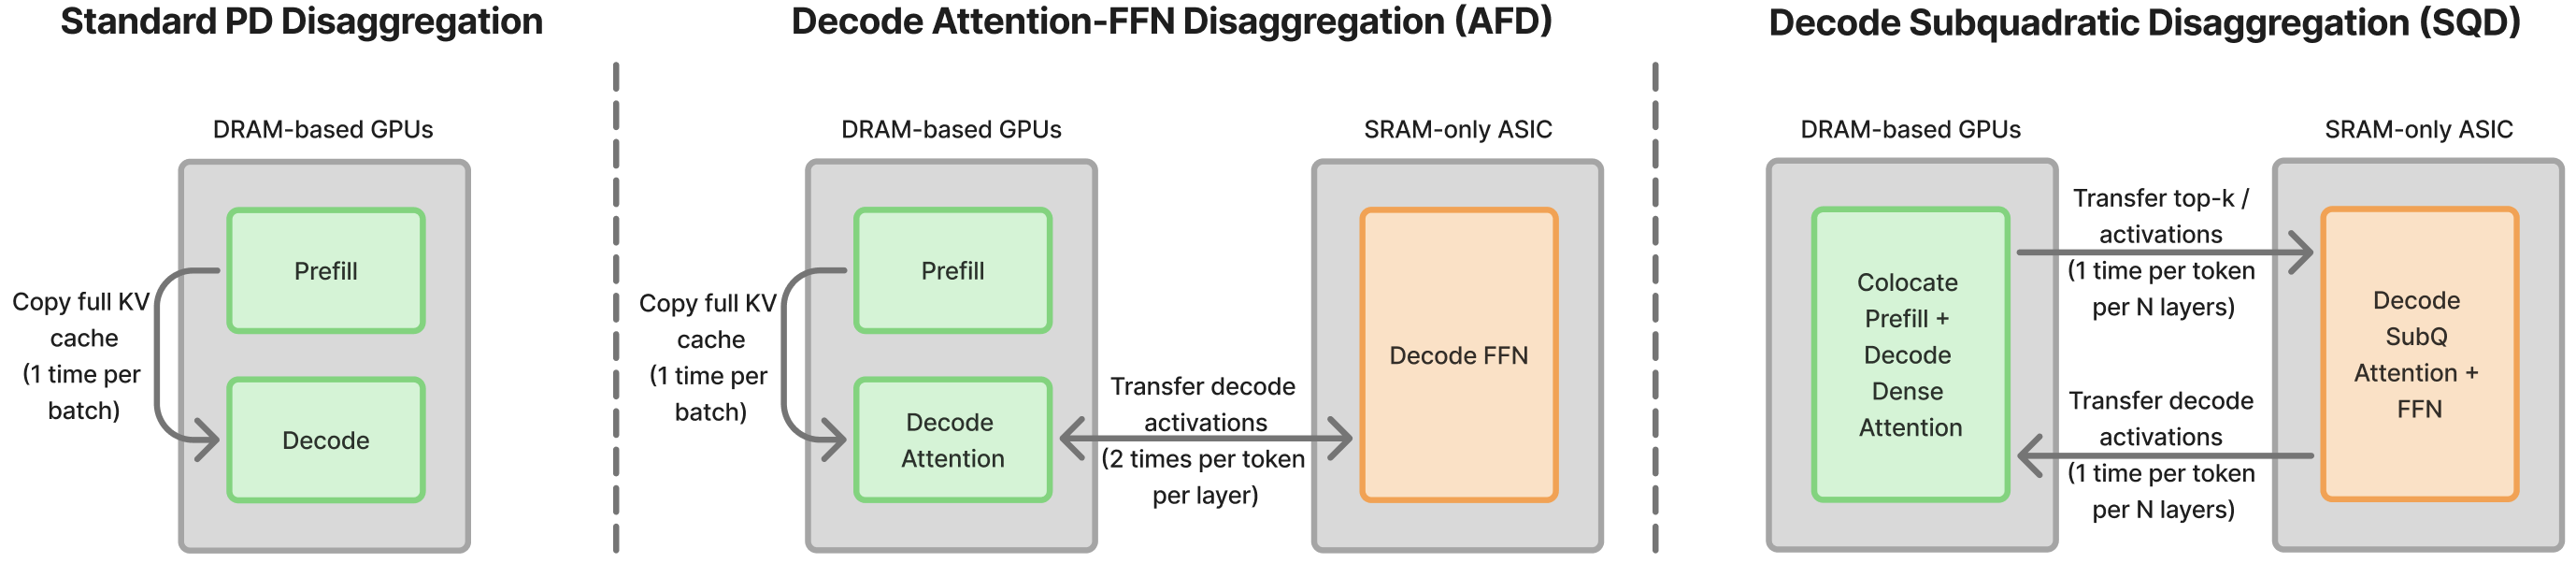
Команда Harvard University и NVIDIA разделила генерацию не на внимание и полносвязные слои, как делают прежние схемы, а на квадратичные и субквадратичные этапы. Квадратичное внимание читает состояние, которое растёт вместе с контекстом. Субквадратичные этапы работают с фиксированным окном, выбранными фрагментами или постоянным рекуррентным состоянием.
SQD оставляет первичную обработку запроса и квадратичное внимание на GPU с DRAM: там уже находится растущий кэш ключей и значений. Субквадратичное внимание и полносвязные слои переходят на специализированный ускоритель с SRAM. Поэтому данные пересекают соединение между устройствами раз в несколько слоёв, а не дважды на каждом слое.
Для разреженного внимания граница проходит внутри одной операции. Выбор top-k по-прежнему просматривает весь кэш и остаётся на GPU, а вычисление внимания только по выбранным позициям переносится на ускоритель. SQD кэширует выбранные значения и заранее передаёт промахи, скрывая часть задержки соединения за вычислениями соседних слоёв.
Схему проверяли на GLM-5.2, Nemotron 3 Ultra и Gemma4-31B с контекстом от 32 тысяч до 1 миллиона токенов. Энергопотребление измеряли на настроенном стенде из восьми B200, который имитировал гетерогенную систему, а Rubin и LPX оценивали аналитической моделью. При фиксированном бюджете мощности SQD дала до 3,6 раза больше пропускной способности, чем разбиение на внимание и полносвязные слои. Вывод относится к системам, где GPU работают вместе с ускорителями, чьё рабочее состояние целиком помещается в SRAM.
Источники
Иллюстрация: рисунок из статьи «Rethinking Heterogeneous System Disaggregation for Subquadratic Attention», Arya Tschand, Yaosheng Fu, Vikram Sharma Mailthody и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.