Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
KV-кэш, где LLM хранит ключи и значения предыдущих токенов, удалось сжать примерно до одного бита на элемент без резкого обвала качества на длинных задачах. TaSQ поддержал до 14 раз больший пакет запросов, чем базовый вариант BF16, хотя препринт не рецензирован и числа получили сами авторы. Для команд, которые упираются в память GPU при длинном контексте, это предлагает альтернативу покупке дополнительных ускорителей или сокращению пакета.
Почему обычное квантование ломается на одном бите
KV-кэш растёт вместе с контекстом и читается при генерации каждого нового токена. Поэтому он занимает память не однократно, как веса модели, а пропорционально числу одновременно обрабатываемых запросов и длине их истории.
Векторное квантование заменяет группу чисел индексом одного эталонного вектора из заранее построенного справочника. Чем меньше битов остаётся на исходный элемент, тем больше каналов приходится описывать одним справочником и тем труднее подобрать эталоны без искажения механизма внимания.
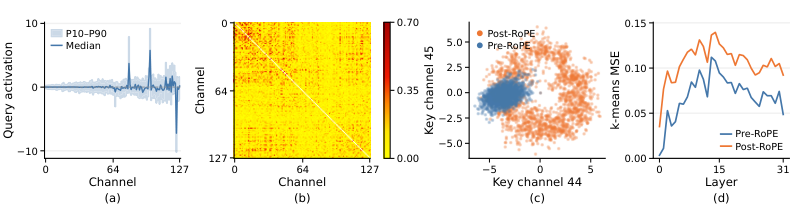
TaSQ меняет не сам принцип хранения, а пространство, в котором система подбирает эталонные векторы. Сначала метод сильнее взвешивает каналы ключей, где ошибка заметнее влияет на произведение запроса и ключа. Ошибка в канале с большими значениями запроса получает больший вес, чем такая же ошибка в менее чувствительном канале.
Затем TaSQ нормализует ключи общей шкалой для всех голов внимания у одного токена. Это снижает влияние выбросов и требует хранить одну шкалу вместо отдельной шкалы для каждой головы.
Наконец, метод объединяет в одну группу каналы, которые статистически связаны. Обычная схема берёт соседние каналы, хотя соседство в векторе ничего не говорит об их совместном распределении. TaSQ оценивает ковариацию и переставляет каналы так, чтобы один справочник описывал зависимости, которые действительно встречаются в данных.
Ключи квантируются до применения RoPE: позиционное вращение расширяет их распределение и усложняет подбор компактного набора эталонов. При этом TaSQ сохраняет пары каналов RoPE вместе, поэтому вращение можно применить позднее без плотного преобразования всего ключа. Для значений авторы оставили стандартное векторное квантование: их чувствительность и связи между каналами оказались менее выраженными.
Качество сохраняется лучше всего на длинном рассуждении
На общих задачах для Llama-3.1-8B-Instruct TaSQ опередил ближайший низкобитный вариант в среднем на 5,89 пункта. Сюда вошли задачи по математике, программированию, знаниям и следованию сложным инструкциям. От BF16 разрыв остался, поэтому метод не делает агрессивное сжатие бесплатным.
Сильнее преимущество проявилось у Qwen3-4B-Thinking-2507 на задачах с длинной цепочкой рассуждений: средний результат составил 60,55 против 46,67 у лучшей из других схем векторного квантования. TaSQ также реже приводил модель к повторяющейся генерации до установленного предела длины.
В поиске фрагмента внутри длинного контекста Llama-3.1-8B-Instruct сохранила результат 93,17 при длине 64k. Другие варианты сильнее теряли качество по мере выхода за длину, использованную при калибровке.
Проверка охватила Llama-3.1-8B-Instruct, Qwen3-4B, Qwen3-4B-Thinking-2507, DeepSeek-R1-Distill-Llama-8B и Phi-4-reasoning-plus. Методы сравнивали на общих задачах, программировании, математических рассуждениях и поиске в длинном контексте; справочники калибровали на окнах из GPQA и CodeParrot. Замеры обслуживания провели в SGLang на одном NVIDIA RTX 6000 Ada.
Что меняется в планах инфраструктурной команды
TaSQ имеет смысл рассматривать там, где размер KV-кэша уже ограничивает пакет запросов или длину контекста. На одном GPU реализация достигла в 1,87 раза большей пиковой пропускной способности, чем BF16. Выигрыш появился за счёт освободившейся памяти и снижения объёма данных, который ядро внимания читает при генерации.
Метод не требует перемешивать каналы или умножать восстановленные ключи на плотную матрицу во время обслуживания. Масштабирование и перестановка заранее встраиваются в проекционные веса и справочники, а восстановление ключа, RoPE и вычисление внимания объединяются в одном ядре. Поэтому дополнительная логика почти не уменьшила пропускную способность относительно более простой схемы квантования.
Цена проявляется при обработке входного контекста: кодирование KV-кэша увеличило время до первого токена на 10–14%. Такой обмен подходит для длинных генераций, где разовый расход распределяется на последующие токены. Для коротких ответов с большим входом задержку нужно измерять отдельно на рабочем распределении запросов.
Это не замена нагрузочному тесту конкретной модели. Результат зависит от калибровочных данных, модифицированных весов проекций и специализированных ядер SGLang. Практический план — проверить TaSQ как отдельный профиль обслуживания рядом с BF16 и текущим квантованием, сравнивая качество длинных ответов, время первого токена и максимальный устойчивый пакет.
Источники
Иллюстрация: рисунок из статьи «Tailoring the Quantization Space for 1-Bit KV Cache Compression», Minsoo Cheong, Donghyun Son, Sungjoo Yoo, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.