Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Веб-агент может правильно выбрать действие и всё равно провалить задачу из-за кода между моделью и браузером. В нерецензированном препринте независимый исследователь Jiangang Han на собственных замерах поднял результат WebFovea с 31 до 57 баллов из 100, не меняя claude-opus-4-6. Для разработки такого агента это смещает приоритет с выбора LLM на проверку всей цепочки исполнения.
Каждый шаг разбили на четыре этапа: ответ модели нужно превратить в команду, выполнить её на странице, правильно сообщить результат и показать модели новое состояние сайта. Сбой на любом этапе выглядит как ошибка рассуждения: агент повторяет ввод, отказывается от уже сработавшего действия или кликает мимо цели.
Самая заметная ошибка возникла из-за разных систем координат. Браузер получал снимок размером 1920×1080 пикселей, API уменьшал его, а исполнитель считал координаты исходными. Поэтому каждый клик попадал примерно в три четверти нужной позиции. После явного масштабирования три промаха на 122–189 пикселей превратились в попадания с отклонением не более пяти пикселей.
Другие исправления закрывали столь же приземлённые сбои. Исполнитель научился работать с системными выпадающими списками, проверять введённый текст, нажимать Enter, обрабатывать элементы внутри iframe и замечать изменения во вложенных страницах. Фрагменты служебной разметки модели попадали в поля ввода в 4,9% эпизодов; фильтрация удаляла их до выполнения команды.
WebFovea проверяли на живых сайтах в WebRetriever Challenge: скрытый набор включал 100 задач, где агент должен был пройти интерфейс сайта и вернуть проверяемый ответ. Во всех четырёх отправках использовали одну модель, но отдельные исправления тестировали на небольших наборах задач, а сайты менялись между запусками. Результат показывает направление для архитектуры, но не доказывает, что каждый приём одинаково сработает с другой LLM или средой.
Источники
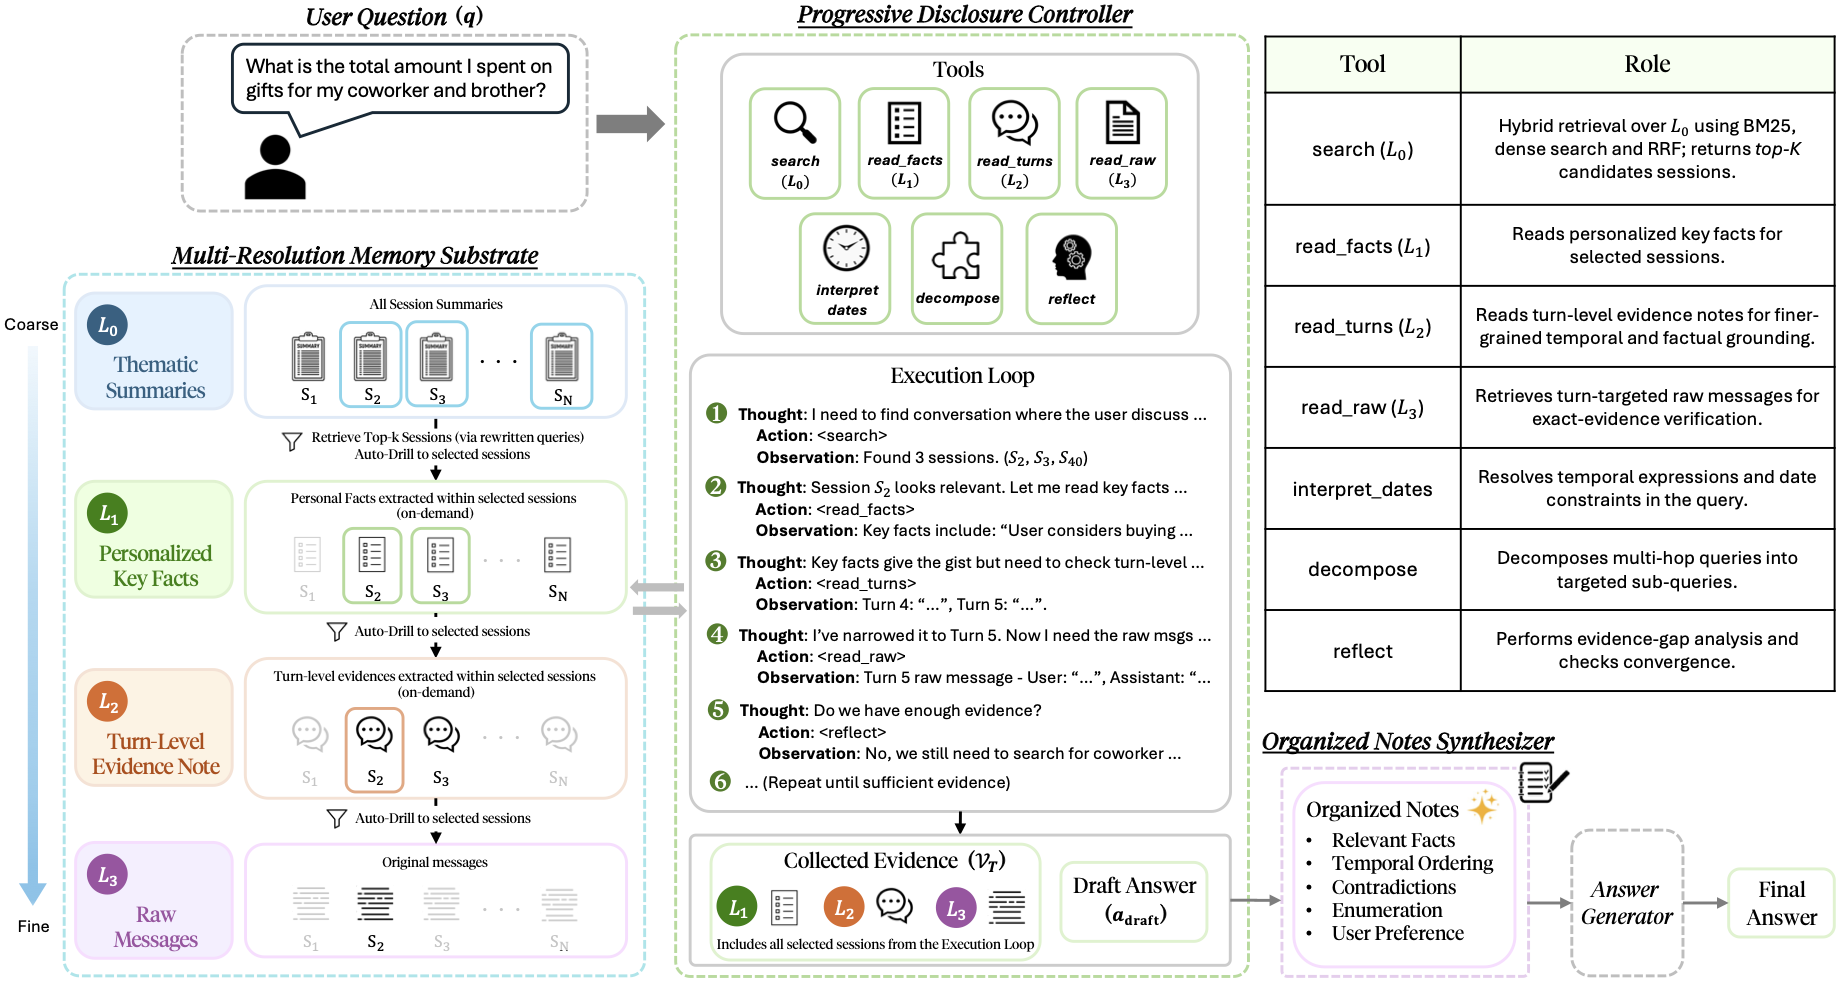
Иллюстрация: рисунок из статьи «WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites», Jiangang Han, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.