Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Новая схема внимания научилась при генерации не читать весь длинный контекст на каждом шаге и при этом сохранять качество плотной модели. Работа Themistoklis Haris, Henry Li и Maryam Karimzadehgan показывает ускорение до 2,5 раза, хотя препринт не рецензирован и числа получили сами авторы. Подход меняет расчёт инфраструктуры для собственных моделей с длинным контекстом, но не даёт готового ускорителя для любого существующего чекпойнта.
Как модель решает, какую часть контекста читать
При генерации каждого токена Transformer обычно загружает из памяти GPU весь кеш ключей и значений (KV-cache). Чем длиннее контекст и больше пакет запросов, тем чаще скорость ограничивает не арифметика, а перенос данных из памяти GPU в быстрые буферы вычислительных блоков.
ETA добавляет к каждому слою линейный предсказатель порога. Он получает представление текущего запроса и отдельно для каждой головы внимания решает, насколько широко та должна смотреть в прошлое. Сложный шаг может допустить больше контекста, а рутинный — отбросить почти все нерелевантные позиции.
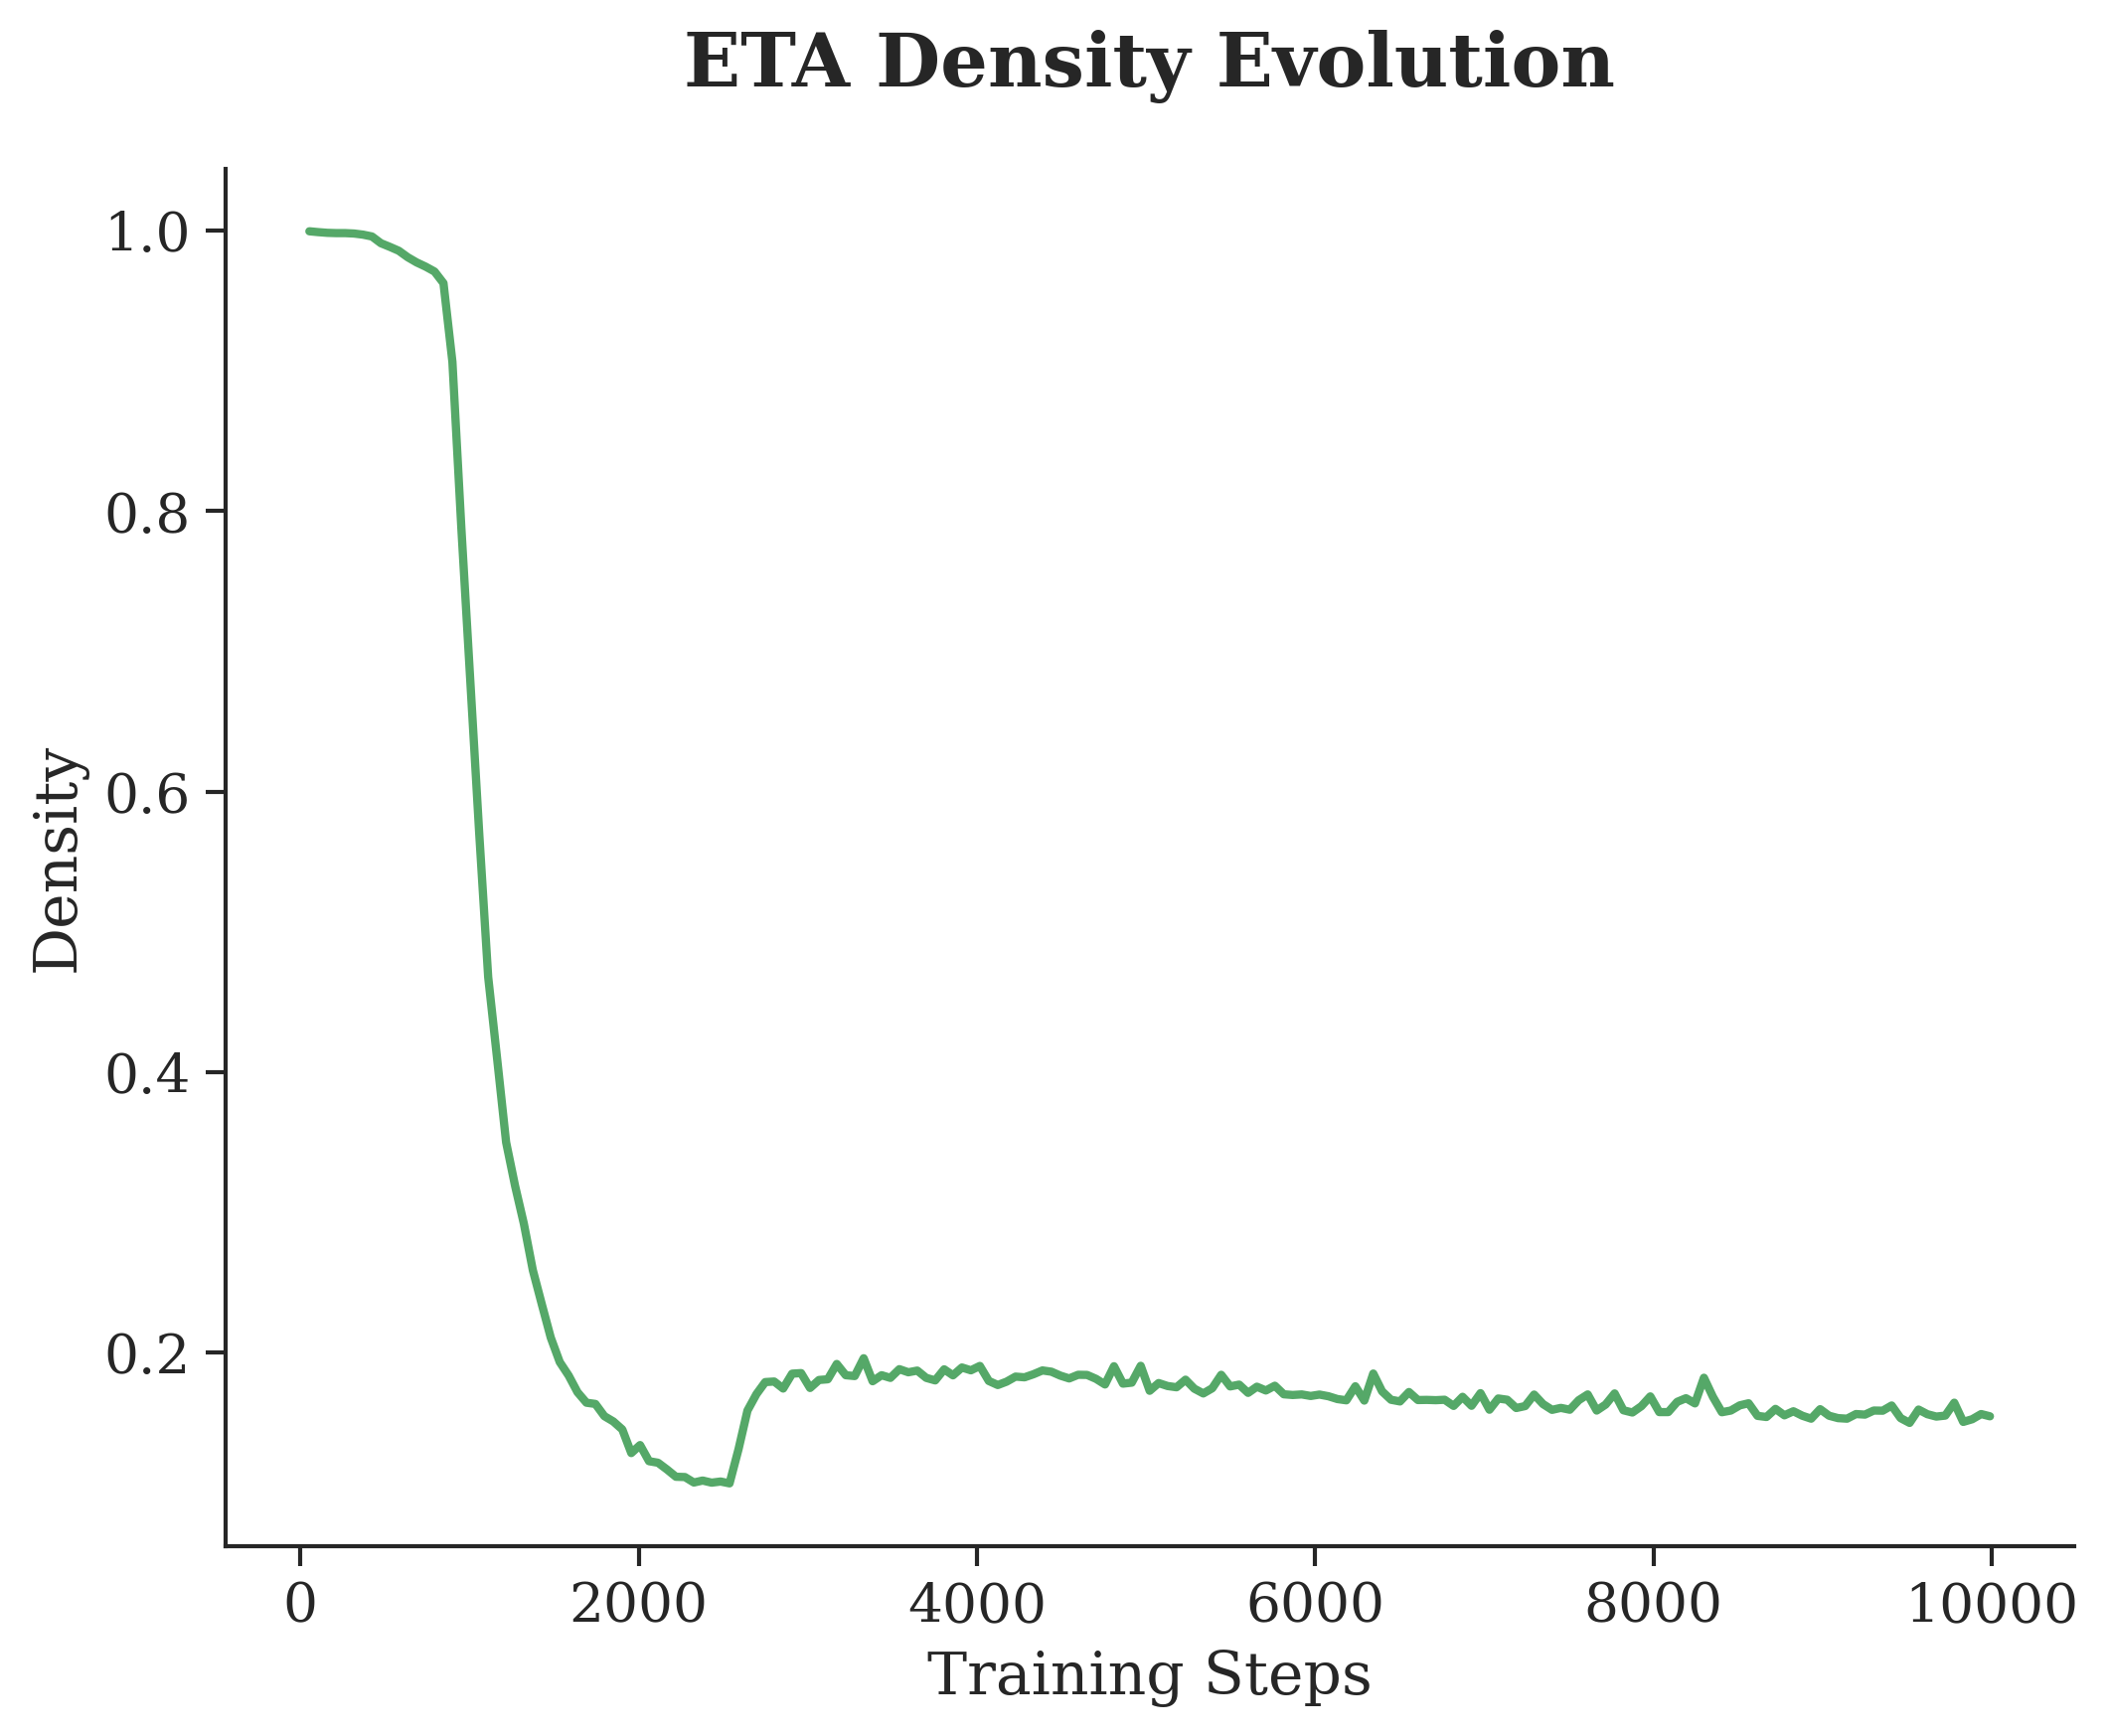
Главная деталь относится к обучению. Обычное разреженное внимание полностью удаляет позиции ниже порога, присваивая им бесконечно малую вероятность. ETA вместо этого умножает их оценки на плавную маску и стягивает оценки к нулю.
После нормализации такие позиции образуют равномерный фон, а не набор случайных пиков. Если модель не находит сильного совпадения, вероятность больше не концентрируется на первых токенах только потому, что им нужно куда-то принять остаток веса. Благодаря этому пропадают локальные «стоки внимания», а модель привыкает к фону, который затем можно убрать целыми блоками.
Во время генерации ядро на Triton сначала проверяет краткую статистику каждого блока: средний вектор ключей, разброс координат и максимальную норму. Если верхняя оценка релевантности не достигает порога, ключи и значения из этого блока вообще не загружаются из основной памяти GPU.
ETA при этом не уменьшает физически сохранённый KV-кеш: модель по-прежнему хранит полный контекст. Она сокращает долю кеша, которую приходится переносить на каждом шаге, а служебный индекс добавляет 1,6% памяти. Это важное различие для расчёта ёмкости GPU: метод прежде всего снижает трафик памяти и задержку, а не объём размещения модели вместе с контекстом.
Максимальное ускорение не совпадает с рабочим режимом модели
Авторы обучили модель на 1,45 млрд параметров с ETA с нуля на FineWeb и сравнили её с плотной моделью той же архитектуры. Проверки охватывали предсказание текста, задачи на здравый смысл и поиск спрятанного фрагмента в длинном контексте. При активной плотности внимания около 38% ETA показывала близкое к плотной модели качество.
На NVIDIA H100 при контексте в 512 тысяч токенов и рабочей плотности обученной модели ускорение относительно FlashAttention-2 составило 1,12 раза. При меньшем пакете накладные расходы на проверку блоков могли сделать ETA медленнее плотного внимания: экономия появляется, когда перенос KV-кеша уже насыщает пропускную способность памяти.
Результат до 2,5 раза получен в более разреженном режиме с укрупнёнными блоками. Это замер ядра в серии тестов задержки, а не основной режим, для которого отдельно показано совпадение качества с плотной моделью. Поэтому использовать максимальную цифру как прогноз для промышленной модели пока нельзя.
Границы работы заданы одной архитектурой, собственным ядром Triton и одним классом GPU. Модель обучали на обычном тексте, а качество проверяли на языковых задачах и поиске внутри контекста. Эти условия ближе к серверной пакетной генерации, чем к интерактивному запуску одиночных запросов или к готовым моделям другого размера.
Когда ETA стоит учитывать в планах
Для команды, которая обучает собственную базовую модель, ETA предлагает сравнительно небольшое изменение архитектуры: предсказатели порогов добавляют менее 0,1% параметров. Однако обучение остаётся плотным по числу операций. Экономия начинается при генерации и требует специального ядра, блочного индекса и чекпойнта, который во время обучения привык к подавлению слабых оценок.
Это не замена KV-квантизации и не способ освободить память под более длинный контекст. ETA можно рассматривать как дополнительный уровень оптимизации, если узкое место уже находится в чтении KV-кеша, запросы объединяются в крупные пакеты, а команда контролирует архитектуру модели и стек выполнения на GPU.
Для стабильного прикладного домена работа предлагает автономную калибровку. Алгоритм строит распределение оценок по 16 последовательностям, затем заменяет динамический предсказатель постоянным порогом для каждой головы. На C4 такие пороги сохранили перплексию — метрику качества предсказания следующего токена — и сократили вычисления внимания ещё на 27% относительно динамического режима при выходе за обученную длину.
Статические пороги подходят сервисам с повторяемым типом документов и запросов. Для открытого поиска, рассуждений и меняющегося трафика работа оставляет динамический выбор: именно он позволяет расширить внимание на редком сложном шаге. Практический вывод состоит не в том, чтобы заменить FlashAttention-2 немедленно, а в том, чтобы заложить испытание обучаемой разреженности при следующем цикле обучения собственной модели.
Источники
Иллюстрация: рисунок из статьи «Elastic Threshold Attention: Learned Contextual Sparsity for Long-Context Decoding», Themistoklis Haris, Henry Li, Maryam Karimzadehgan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.