Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили выбирать осмысленные ответы внутри заданной грамматики без размеченных примеров. В работе, которая не прошла рецензирование и содержит замеры самих авторов, GrammarRL улучшил жадное декодирование в среднем на 9,8 пункта и на двух из трёх задач не уступил лучевому поиску. Команда может один раз адаптировать модель под стабильную грамматику, а затем не оплачивать перебор нескольких вариантов при каждом запросе.
Почему правильный формат ещё не даёт правильный ответ
Генерация с грамматическими ограничениями блокирует токены, которые нарушают формальные правила. Так можно гарантировать допустимый JSON, метку из справочника или последовательность из разрешённого словаря, но грамматика проверяет форму, а не смысл.
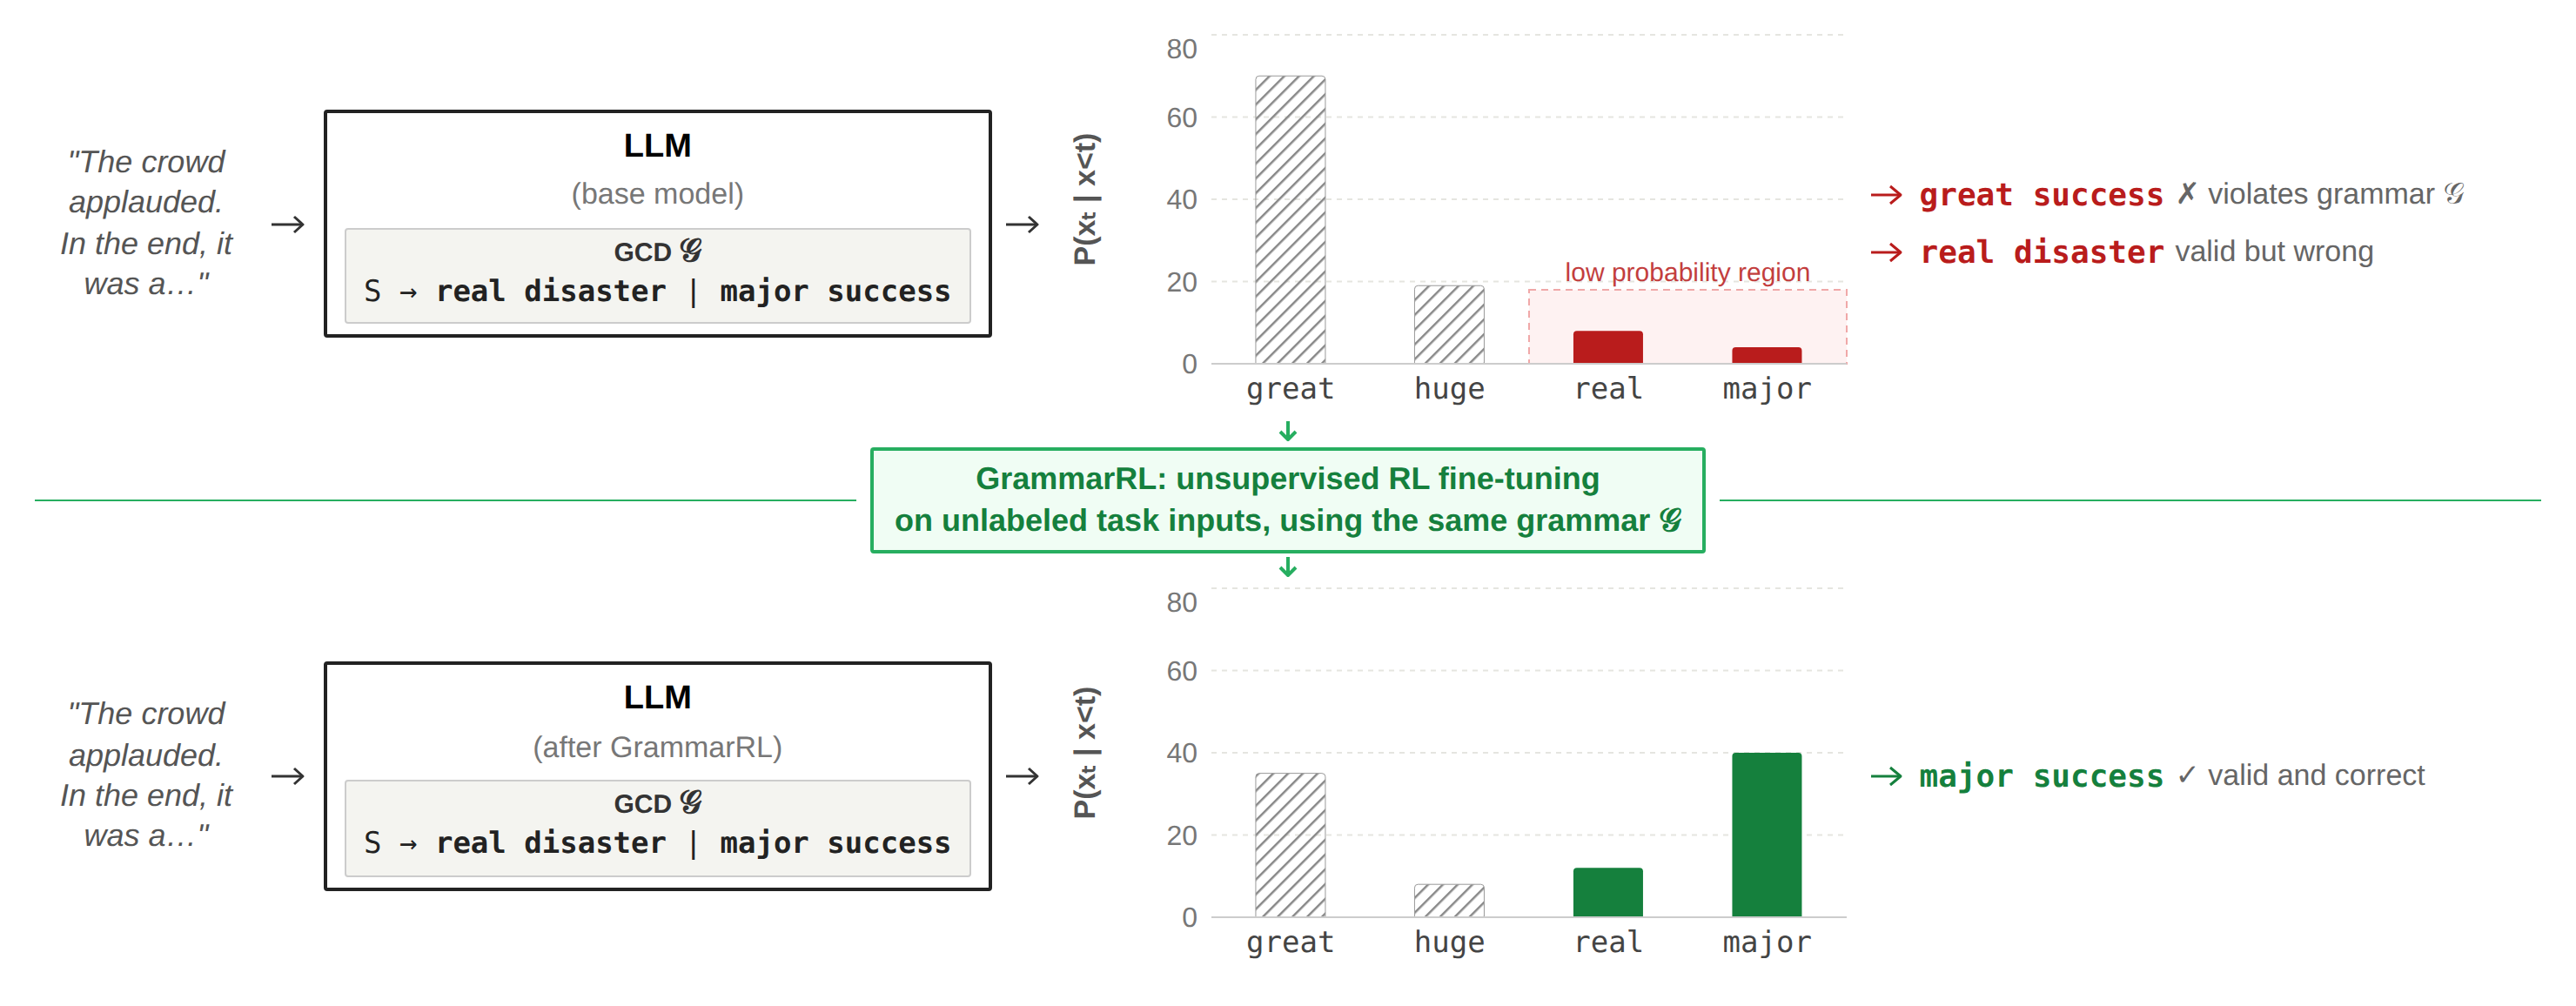
Проблема возникает, когда модель изначально предпочитает слова, запрещённые грамматикой. После блокировки она выбирает среди оставшихся вариантов, которым до этого назначала низкую вероятность. Первый допустимый токен может увести ответ в тупик: вся последовательность останется формально правильной, но перестанет соответствовать запросу.
Лучевой поиск (beam search) частично исправляет это: он сохраняет несколько продолжений и выбирает результат после сравнения полных последовательностей. Цена такого подхода растёт вместе с числом вариантов, а самая вероятная последовательность не обязательно точнее передаёт смысл.
GrammarRL переносит этот выбор в обучение. После адаптации модель сразу назначает больше вероятности продолжениям, которые одновременно укладываются в грамматику и сохраняют сведения из исходного запроса. Во время применения ей достаточно жадно выбирать лучший допустимый токен на каждом шаге.
Как две награды отсекают разные виды ошибок
Для обучения нужны входные запросы и грамматика, но не эталонные ответы. Обучаемая модель создаёт несколько допустимых кандидатов; к ним добавляют лучший вариант лучевого поиска. Последний не становится образцом для копирования: его оценивают наравне с остальными последовательностями.
Замороженная исходная модель выставляет каждому кандидату две награды. Прямая показывает, насколько вероятен ответ при заданном входе. Обратная проверяет, насколько хорошо модель может восстановить исходный вход, если увидит только сгенерированный ответ.
Первая награда отбрасывает грамматически допустимые последовательности, которые исходная модель считает неестественными. Но сама по себе она подталкивает модель к общим ответам, где мало сведений из запроса. Вторая сохраняет эти сведения, однако в одиночку может закреплять структурные ловушки. В экспериментах сочетание наград каждый раз превосходило исходное жадное декодирование, тогда как каждая по отдельности могла оказаться хуже него.
Алгоритм RLOO сравнивает кандидата с остальными вариантами для того же запроса и повышает вероятность последовательностей с лучшей относительной оценкой. Дополнительный штраф не даёт обучаемой модели слишком далеко отклониться от замороженной основы. Меняются только компактные адаптеры LoRA, а не все параметры модели.
Авторы считают награды по вероятностям до применения грамматической маски. Это существенная деталь: после маскировки вероятности разрешённых токенов пересчитываются до полной суммы, поэтому заведомо слабое продолжение может выглядеть уверенным лишь потому, что все предпочтительные варианты запретили.
Когда GrammarRL меняет планы продукта
Метод проверили на переводе английского текста в глоссы жестового языка, иерархической классификации научных текстов и распознавании именованных сущностей. В экспериментах участвовали модели Llama размером от 1 до 8 млрд параметров. Максимальный прирост составил 22,8 BLEU на задаче перевода, а на распознавании сущностей лучевой поиск исходной модели остался немного точнее GrammarRL с жадным декодированием.
На двух задачах метод также сравнялся с методами приближения распределения или обошёл их, хотя те генерировали в десять раз больше вариантов. Это делает подход уместным для сервисов с большим числом однотипных запросов: дополнительное обучение выполняют заранее, после чего каждый запрос требует только обычной генерации с маской.
GrammarRL не заменяет декодер одной настройкой. Для каждой грамматики требуется отдельный этап обучения с подкреплением, а при изменении правил его придётся повторить. Если схема продукта часто меняется или запросов мало, лучевой поиск может обойтись дешевле по общей стоимости разработки и вычислений.
Границы эксперимента также не позволяют сразу переносить результат на генерацию программ, SQL или произвольных JSON-схем. Работа показывает устойчивый эффект на трёх структурированных задачах, где ответы сравнительно узки, а правила можно проверять по мере генерации. Для команды это основание провести собственный тест на целевой грамматике, а не отказаться от лучевого поиска заранее.
Источники
Иллюстрация: рисунок из статьи «GrammarRL: Effective Grammar-Constrained Decoding via Reinforcement Learning», Gabriele Tuccio, Antonino Furnari, Aldo Gangemi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.