Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Предобученные трансформеры удалось сильно сжать с меньшей потерей качества, чем у прежних низкоранговых методов. Команда Massimo Bini, Yann LeCun и коллег назвала метод LSP; хотя препринт не рецензирован и числа получили сами авторы, на Llama-2-7B он при удалении 70% параметров линейных слоёв повысил среднюю точность без примеров на 6,2 процентного пункта относительно сильнейшего базового метода. После обучения проекции превращаются в обычные низкоранговые матрицы, поэтому метод не требует особых операций при запуске модели.
Почему качество теряется между слоями
Низкоранговое сжатие заменяет большую матрицу весов произведением двух узких. Оно сокращает число параметров и объём вычислений, но сначала нужно решить, какие направления в пространстве активаций сохранить.
Прежние методы обычно решают эту задачу для каждого слоя отдельно. Одни сохраняют направления с наибольшей энергией входных активаций, другие минимизируют ошибку восстановления выхода слоя или используют локальное приближение функции потерь.
Локальный критерий не показывает, как ошибка пройдёт через оставшуюся сеть. Направление со слабой активацией может заметно влиять на итоговое распределение следующего токена, а небольшие ошибки отдельных слоёв при сильном сжатии складываются.
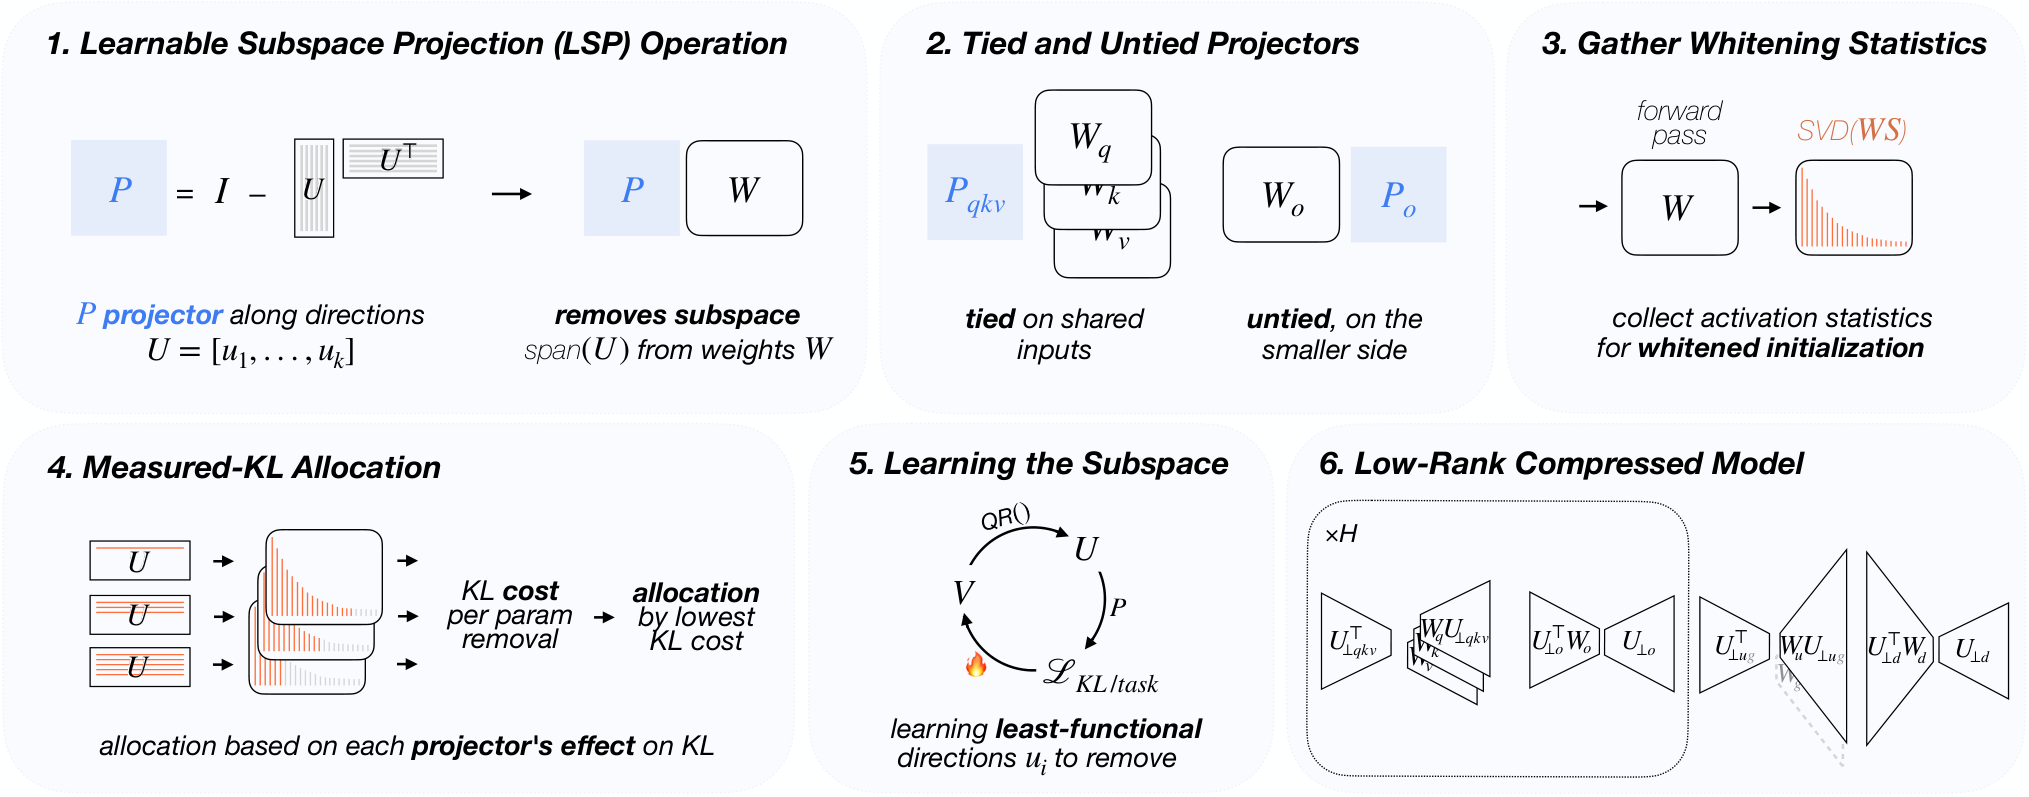
LSP назначает линейному слою ортогональный проектор, который удаляет часть направлений. Слои, читающие одну активацию, могут использовать общий проектор: так объединяются матрицы запросов, ключей и значений в механизме внимания, а также пара матриц в полносвязном блоке.
Сначала проекторы получают начальное состояние через SVD с поправкой на распределение входных активаций. Затем метод поочерёдно применяет варианты сжатия к отдельным группам и измеряет, насколько меняется выход всей модели. Бюджет распределяется туда, где каждый удалённый параметр вызывает наименьшее расхождение с исходной моделью.
После этого все проекторы обучаются совместно, а исходные веса остаются замороженными. Основная цель — приблизить полное распределение ответов плотной модели, а не только правильный токен. QR-разложение удерживает проекторы ортогональными во время обучения.
Обученные проекторы сливаются с весами в две обычные узкие матрицы. Специальный слой LSP в развёрнутой модели не остаётся, а группы связанных матриц могут совместно вычислять и хранить один узкий скрытый вектор.
Преимущество растёт при жёстком сжатии
На WikiText-2 сжатая Llama-2-7B получила перплексию 10,9 против 13,3 у сильнейшего базового метода. Перплексия показывает, насколько уверенно модель предсказывает следующий токен: чем она ниже, тем лучше. Разрыв особенно заметен в самом жёстком режиме, где локальные методы начинают быстро накапливать ошибки.
Один из двух вариантов LSP показал лучшую перплексию во всех проверенных сочетаниях моделей и степеней сжатия. Вариант с имитацией распределения исходной модели чаще сохранял общее поведение, а обучение на исходной функции потерь могло лучше подстроиться под данные калибровки.
Метод проверяли на семействах OPT, Qwen3 и Llama-2, а также на ViT-B/16 для изображений. Для языковых моделей оценивали WikiText-2 и набор задач без примеров; параметры распределяли по калибровочным текстам. Под сжатием работа понимает удаление параметров линейных слоёв: эмбеддинги и выходная голова в этот бюджет не входят.
Замеры скорости провели на одном GH200 с вычислениями bf16. Поэтому результаты показывают поведение факторизованных моделей на серверном GPU, но не заменяют проверку на конкретном ускорителе, размере пакета и реализации генерации.
Когда LSP меняет планы развёртывания
LSP стоит учитывать командам, которые разворачивают фиксированную предобученную модель и готовы один раз прогнать калибровку и обучение проекторов. Метод позволяет заложить низкоранговое сжатие после выбора модели, а не искать отдельную архитектуру или обучать уменьшенную модель с нуля.
Наибольший практический эффект возникает при небольших пакетах и длинном контексте. Факторизованная модель генерировала до 1,6 раза быстрее плотной. При контексте 128 тысяч токенов и пакете 8 общая память весов и KV-кэша сокращалась в 13,5 раза против максимум 6,5 раза у факторизаций без общих проекций.
Экономия KV-кэша получается не автоматически из низкого ранга. Матрицы ключей и значений должны разделять входной фактор, тогда вместо двух полных наборов в кэше хранится один узкий скрытый вектор. Это влияет на архитектуру реализации: ранги и группировку слоёв нужно выбирать с учётом памяти, а не только качества.
Калибровочные данные тоже становятся частью плана. Проекторы сохраняют направления, от которых зависит поведение модели именно на этих данных, поэтому набор должен отражать будущие запросы. Перед выпуском сжатую модель всё равно нужно проверять на редких сценариях, безопасности и устойчивости: средняя метрика не показывает, где именно распределилась потеря качества.
Для моделей, доступных только через внешний API, подход планов не меняет: LSP требует доступа к весам, активациям и возможности заменить линейные слои. Для собственного развёртывания работа даёт конкретный путь совместить сжатие весов, ускорение генерации и уменьшение памяти длинного контекста в одной процедуре.
Источники
Иллюстрация: рисунок из статьи «Learning Functional Subspaces for Neural Network Compression», Massimo Bini, Anders Christensen, Stephan Alaniz и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.