Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель временных рядов можно обучать с разной силой ограничений для чистых и зашумлённых примеров, не меняя её работу после обучения. В препринте, который не прошёл рецензирование и приводит замеры самих авторов, SACM снизил среднеквадратичную ошибку прогноза в среднем на 6,7% относительно тех же архитектур без этого метода. Для внедрения достаточно изменить обучение: вычислительный путь после развёртывания остаётся прежним.
Как спектр превращается в силу прореживания
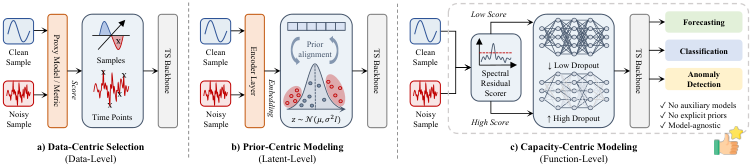
Обычное прореживание активаций (dropout) с одной вероятностью отключает часть внутренних признаков для всех обучающих примеров. Это создаёт конфликт: слабое прореживание позволяет модели запоминать сбои датчиков и случайные выбросы, а сильное мешает разбирать сложную структуру чистого сигнала.
SACM назначает вероятность отдельно для каждого примера. Чем менее надёжным выглядит временной ряд, тем больше внутренних путей модель временно отключает. Для последовательности с выраженной структурой она сохраняет больше доступной ёмкости.
Методу не нужны метки качества или отдельная модель-учитель. Он использует предположение, что полезные тренды и периодические компоненты часто сосредоточены в нескольких областях частотного спектра, тогда как шум распределяется шире.
Отдельная ветвь сначала удаляет линейный тренд, переводит ряд в частотную область и мягко выделяет доминирующие компоненты. Порог опирается на спектральную плоскостность: она показывает, сосредоточена ли энергия в отдельных частотах или распределена равномерно. Разница между исходной и восстановленной последовательностями становится оценкой ненадёжности примера.
Затем SACM нормализует оценки внутри мини-пакета и переводит их в ограниченный диапазон вероятностей прореживания. Двоичные маски применяются к внутренним активациям, а приближённая передача градиента позволяет совместно обучать этот механизм и основную модель.
Спектральная обработка здесь не очищает вход модели. Прогнозирующая архитектура по-прежнему получает исходный ряд, поэтому редкое событие не исчезает только потому, что похоже на шум. Спектр управляет регуляризацией, а не решает, какие наблюдения оставить.
Где адаптивная регуляризация дала выигрыш
SACM проверили на 301 сочетании набора данных и базовой архитектуры. В эксперимент вошли прогнозирование, классификация и поиск аномалий; во всех случаях метод сравнивали с той же архитектурой без адаптивного прореживания.
В классификации точность выросла в среднем на 3,04%. В поиске аномалий F1 с поправкой по размеченным участкам увеличился на 17,05%. Результат для прогноза из лида измеряли через MSE: эта метрика сильнее наказывает крупные ошибки.
При применении модели ветвь SACM отключается. Спектральный анализ, вычисление оценки и генерация масок нужны только во время обучения, поэтому задержка и число операций после развёртывания не меняются. Вывод остаётся детерминированным: один вход не получает разные случайные маски при повторных запусках.
Авторы также сравнили подход с жёсткой фильтрацией входа. Низкочастотная очистка помогла одной архитектуре, но ухудшила две другие, тогда как SACM улучшил результат у всех трёх. Это поддерживает разделение ролей: необработанный сигнал идёт в модель, а спектральный остаток лишь регулирует обучение.
Пилот нужен до смены архитектуры
Границы проверки широки по задачам, но заданы конкретными наборами: девять для прогнозирования, 32 для классификации и четыре для поиска аномалий. Эксперименты охватывают несколько типов архитектур и реальные данные, однако не доказывают, что спектральная оценка одинаково работает для любого производственного сигнала.
Главный риск связан с исходным предположением. Полезная широкополосная динамика, импульсы и резкие переходы тоже могут оставить большой спектральный остаток. SACM тогда примет важную деталь за ненадёжность и сильнее ограничит модель именно на редких режимах, которые продукту требуется распознавать.
Нормализация внутри мини-пакета добавляет ещё одну зависимость: вероятность прореживания определяется не только самим примером, но и соседними примерами при обучении. Для потоков с несколькими режимами стоит отдельно проверить состав пакетов и убедиться, что редкий тип сигнала не получает систематически завышенную регуляризацию.
Работа не требует менять выбранную архитектуру или производственный контур, поэтому сама по себе не оправдывает перенос продукта на другой стек. Практический шаг — добавить SACM в один существующий цикл обучения и сравнить его с подобранным фиксированным прореживанием на срезах по качеству сигнала. Отдельно нужны метрики на редких событиях: среднее улучшение может скрыть ухудшение именно там.
Метод также не заменяет проверку датчиков, обработку пропусков и контроль сдвига данных. В работе его сочетали с отбором наблюдений, и механизмы дополняли друг друга: один решал, какие данные использовать, второй менял доступную модели ёмкость. Для систем с неоднородным шумом SACM выглядит как локальная доработка обучения, а не новая архитектурная ставка.
Источники
Иллюстрация: рисунок из статьи «Towards Robust Time Series Learning via Capacity-Centric Modulation», Siru Zhong, Senzhang Wang, James T. Kwok и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.