Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Линейное внимание научили хранить несколько способов извлечения контекста и выбирать подходящий для каждого элемента ответа. В препринте Stanford, который не прошёл рецензирование и содержит замеры самих авторов, слой SwiLA обошёл другие рекуррентные модели на задачах поиска информации, сохранив память постоянного размера. Такой слой расширяет выбор для длинного контекста, но пока требует компромисса между качеством, скоростью обучения и сложностью реализации.
Почему одного линейного преобразования не хватает
Обычное softmax attention хранит ключи и значения для всех предыдущих токенов. Поэтому KV-кеш растёт вместе с контекстом, зато модель может по-разному связывать запрос с каждым сохранённым фрагментом.
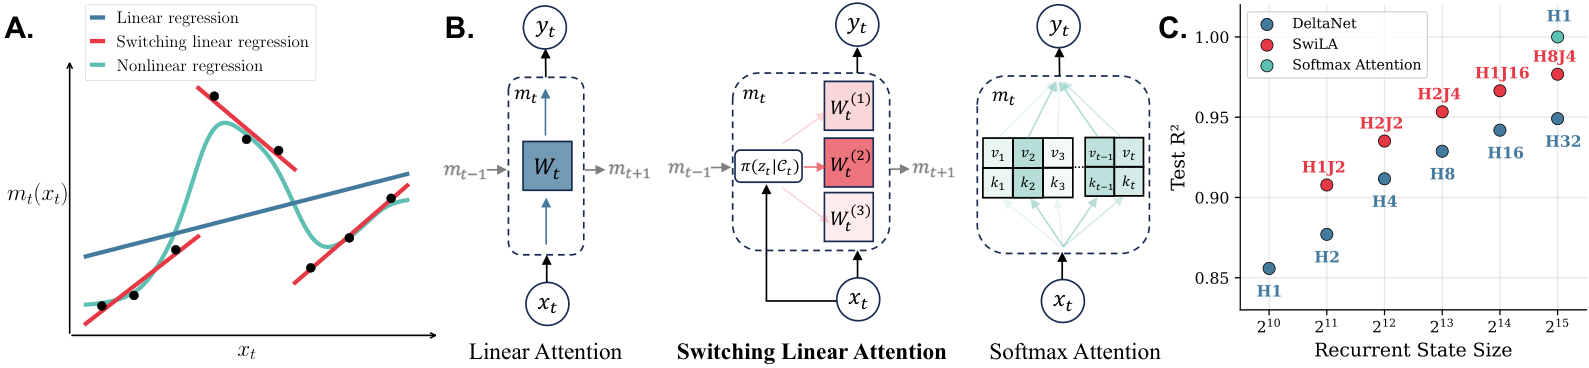
Линейное внимание сжимает историю в матрицу постоянного размера. На каждом шаге оно обновляет эту матрицу, а затем применяет её к новому запросу. Память больше не зависит от длины последовательности, но всё содержимое контекста проходит через одно линейное преобразование.
Проблема проявляется, когда одинаковый ключ требует разных ответов в разных контекстах. Одна матрица должна одновременно запомнить несколько несовместимых правил и начинает смешивать их. Softmax attention справляется лучше, потому что не сводит всю историю к единственному преобразованию.
SwiLA заменяет одну матрицу смесью линейных регрессоров. Каждый регрессор хранит свой способ сопоставить ключ и значение, а модель выбирает компоненты смеси по текущему входу и состоянию памяти. Получается кусочно-линейная функция: внутри отдельного контекста действует простое правило, но между контекстами модель может переключаться.
Как компонент выбирается на каждом шаге
При поступлении пары «ключ — значение» SwiLA проверяет, насколько точно каждый регрессор предсказывает значение. Чем меньше ошибка компонента и чем выше его заранее вычисленный вес для этого входа, тем сильнее обновляется его состояние. Это правило авторы выводят из последовательного алгоритма максимизации ожидания, который распределяет наблюдения между компонентами смеси.
Выбор проходит отдельно для каждой выходной координаты. Разные части одного вектора могут обратиться к разным регрессорам, поэтому число возможных сочетаний быстро растёт, хотя состояние увеличивается только вместе с числом компонентов. При извлечении модель снова вычисляет веса компонентов и складывает их ответы.
Temporal SwiLA дополнительно сохраняет выбранный режим между соседними токенами. Это подходит для фрагментов, где тема или значение слова держится несколько предложений. Gated SwiLA умеет ослаблять старое состояние перед записью новой информации.
Смеси требуют балансировки: без неё несколько компонентов забирают почти все обновления, а остальные перестают работать. В экспериментах временная устойчивость сама снижала этот эффект. Простое увеличение числа компонентов с 4 до 16, напротив, немного ухудшило результат: при том же размере состояния каждому регрессору достались более узкие проекции.
Метод проверяли на приближении softmax attention, синтетическом ассоциативном поиске, обучении по контексту и языковом моделировании на FineWeb-Edu. Отдельно сравнивали модели с 1,3 млрд параметров, а задачи на поиск информации ограничивали контекстом в 2 тысячи токенов. Поэтому работа показывает поведение слоя в контролируемом масштабе, а не готовую замену внимания в крупнейших производственных моделях.
На шести задачах поиска все варианты SwiLA обошли DeltaNet и две версии Mixture-of-Memories. Лучший чисто рекуррентный вариант получил средний результат 20,6 против 20,3 у KDA — преимущество небольшое. Гибрид Temporal SwiLA с периодическими слоями Transformer набрал 31,8, тогда как FoX с полным KV-кешем достиг 33,7.
Когда SwiLA меняет архитектурный план
Для системы, где память при генерации ограничивает размер пакета запросов, SwiLA выглядит практичнее полного softmax attention. Модель с таким слоем показала в 4–5 раз более высокую сквозную пропускную способность, чем Transformer: отсутствие растущего KV-кеша позволило обрабатывать более крупные пакеты.
За это приходится платить относительно других рекуррентных слоёв. По сравнению с GDN SwiLA обучалась примерно вдвое медленнее, а при выводе уступала по скорости в 1,25–1,5 раза и занимала больше памяти. Причина не только в нескольких состояниях: обновление SwiLA нелинейно и в текущей реализации последовательно проходит по токенам.
Авторы использовали собственное последовательное ядро Triton. Они описывают способ распараллелить вычисления блоками, но не применяют его в основных замерах. Команде, которая рассматривает SwiLA, придётся оценивать не только качество модели, но и зрелость ядер для целевого GPU и длины последовательности.
Работа пока не даёт основания полностью убирать softmax attention из архитектуры. Полный кеш всё ещё показал лучший средний результат на поисковых задачах, поскольку его вместимость растёт вместе с контекстом, а состояние SwiLA остаётся фиксированным. Более консервативный вариант — гибрид: рекуррентные слои сокращают расход памяти, а периодические слои Transformer сохраняют точный доступ к отдельным токенам.
SwiLA меняет планы прежде всего там, где продукт упирается в стоимость длинной генерации и размер пакета, а небольшая потеря точности поиска допустима. Для коротких запросов или задач, где критично дословно извлекать редкие фрагменты, работа скорее добавляет кандидата для эксперимента, чем задаёт новую архитектуру по умолчанию.
Источники
Иллюстрация: рисунок из статьи «Switching Linear Attention», Hyun Dong Lee, Xavier Gonzalez, Nicolas Zucchet и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.